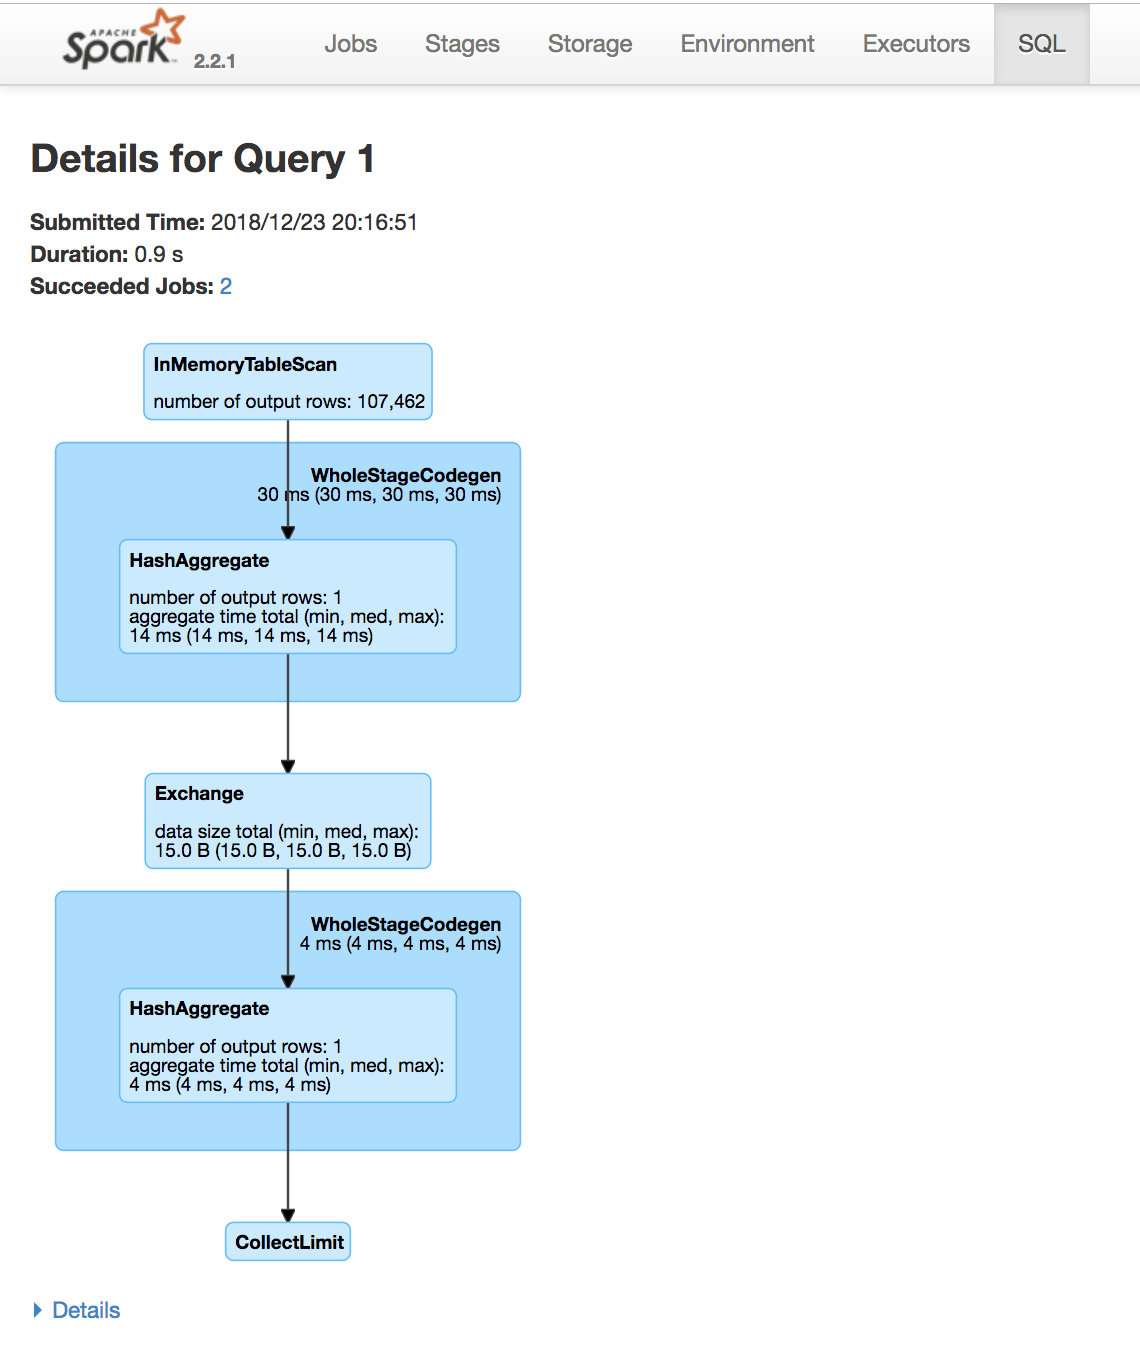
Introducere în Spark SQL în Python
Mark Plutowski
Data Scientist
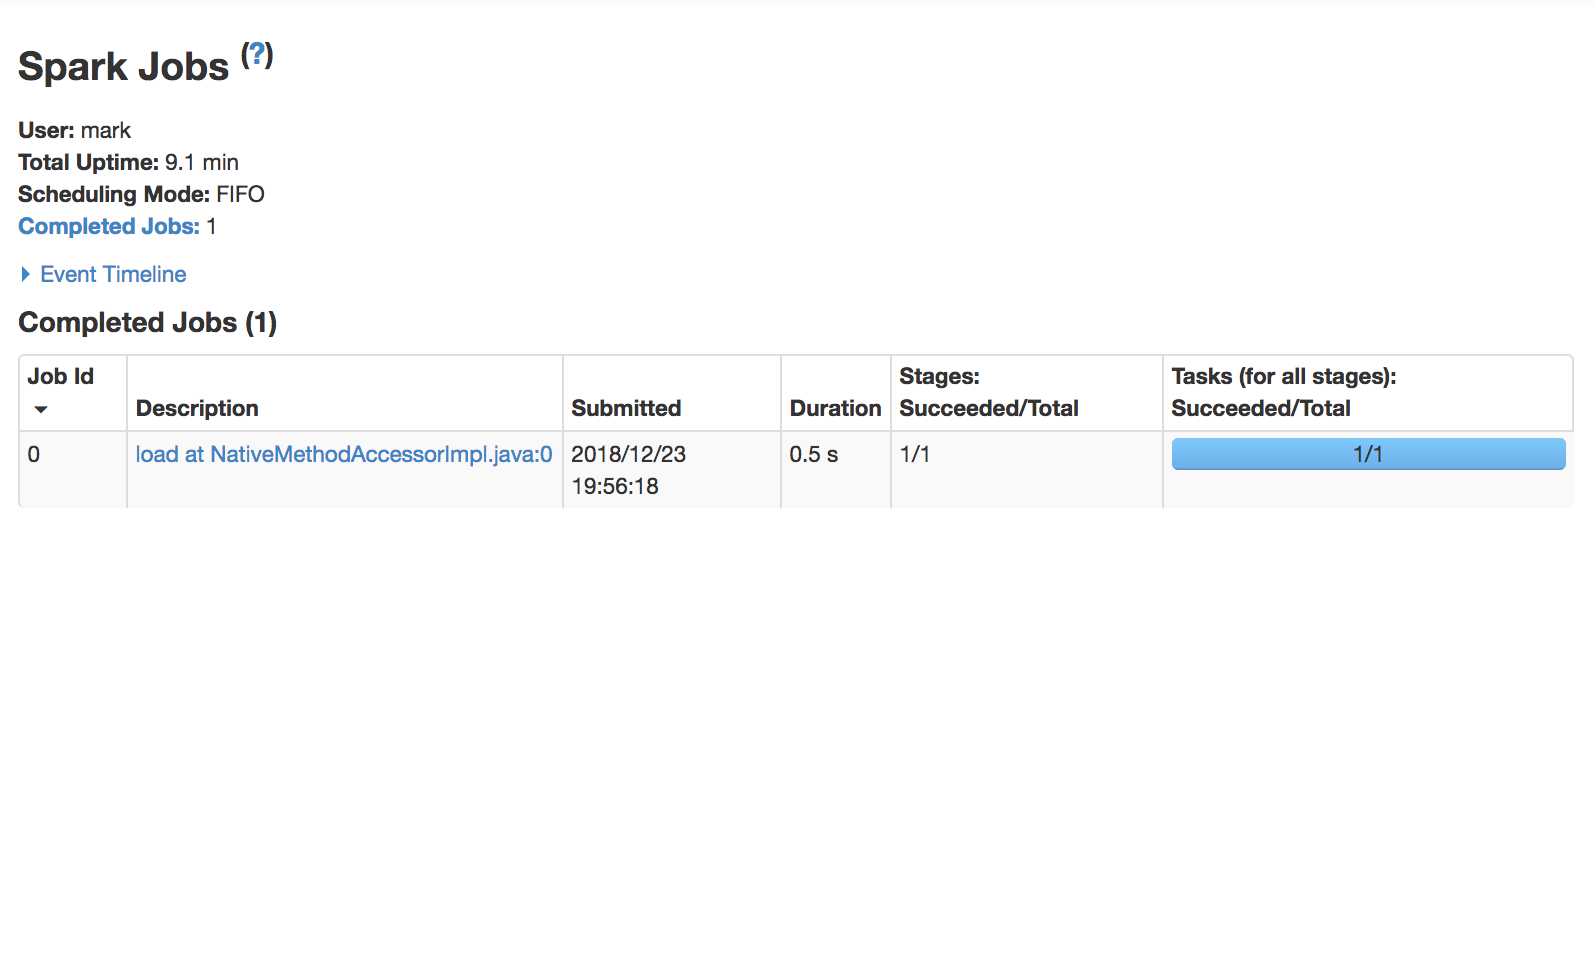
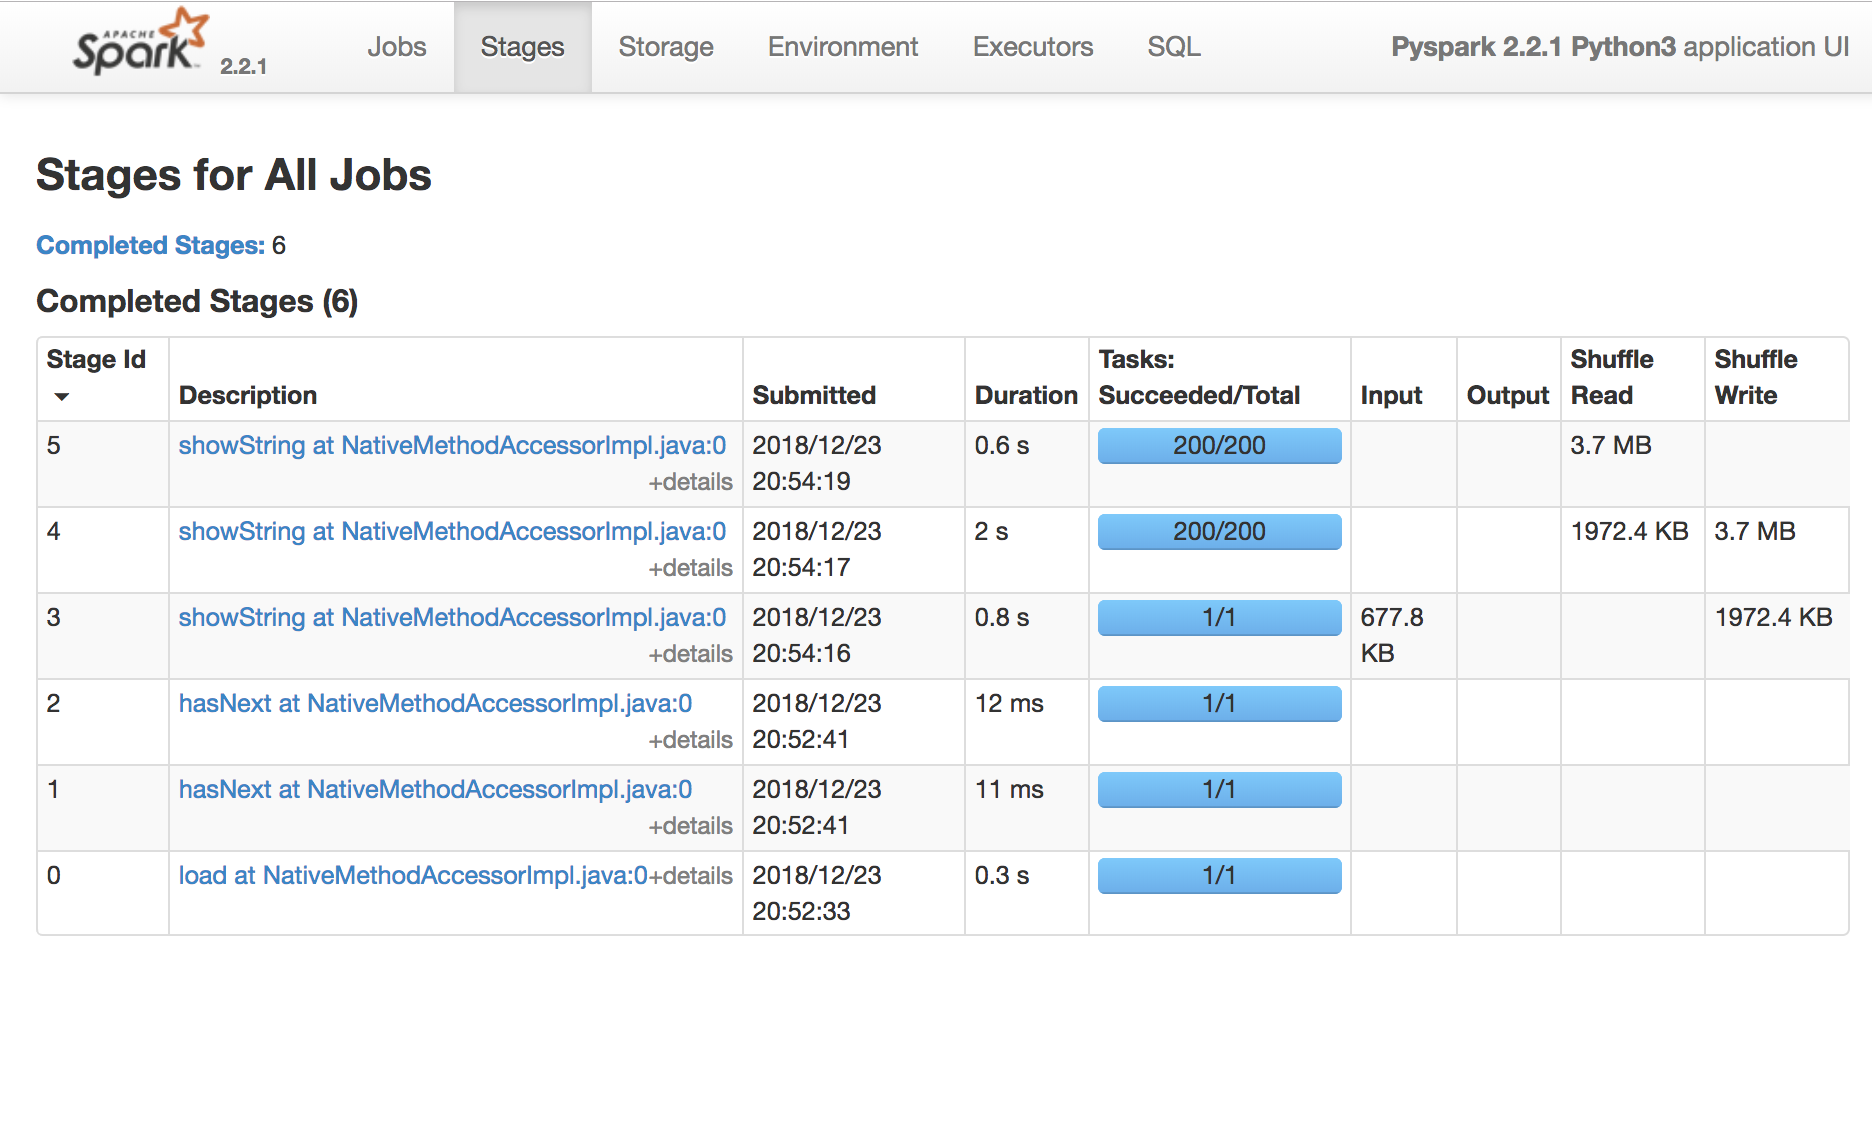
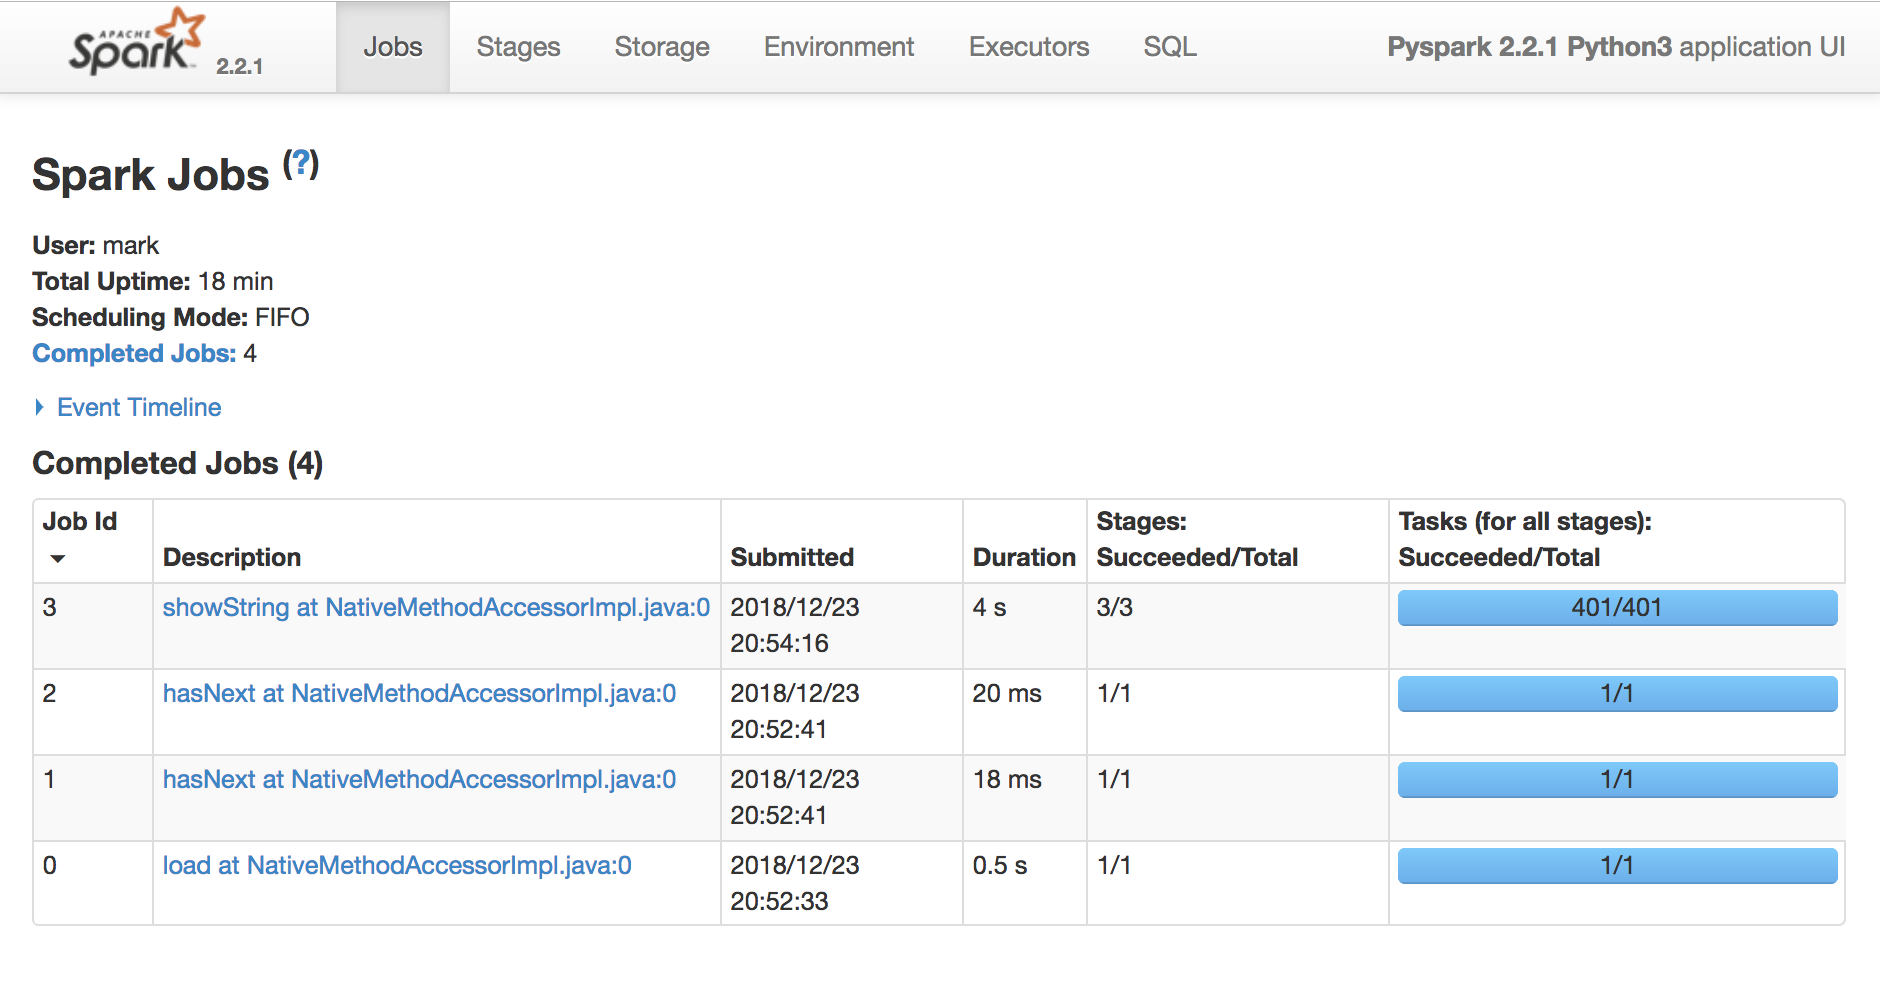
Task Spark – unitate de execuție care rulează pe un singur CPU
Etapă Spark – grup de taskuri care efectuează aceeași computație în paralel, fiecare pe un subset diferit de date
Job Spark – computație declanșată de o acțiune, împărțită în una sau mai multe etape.


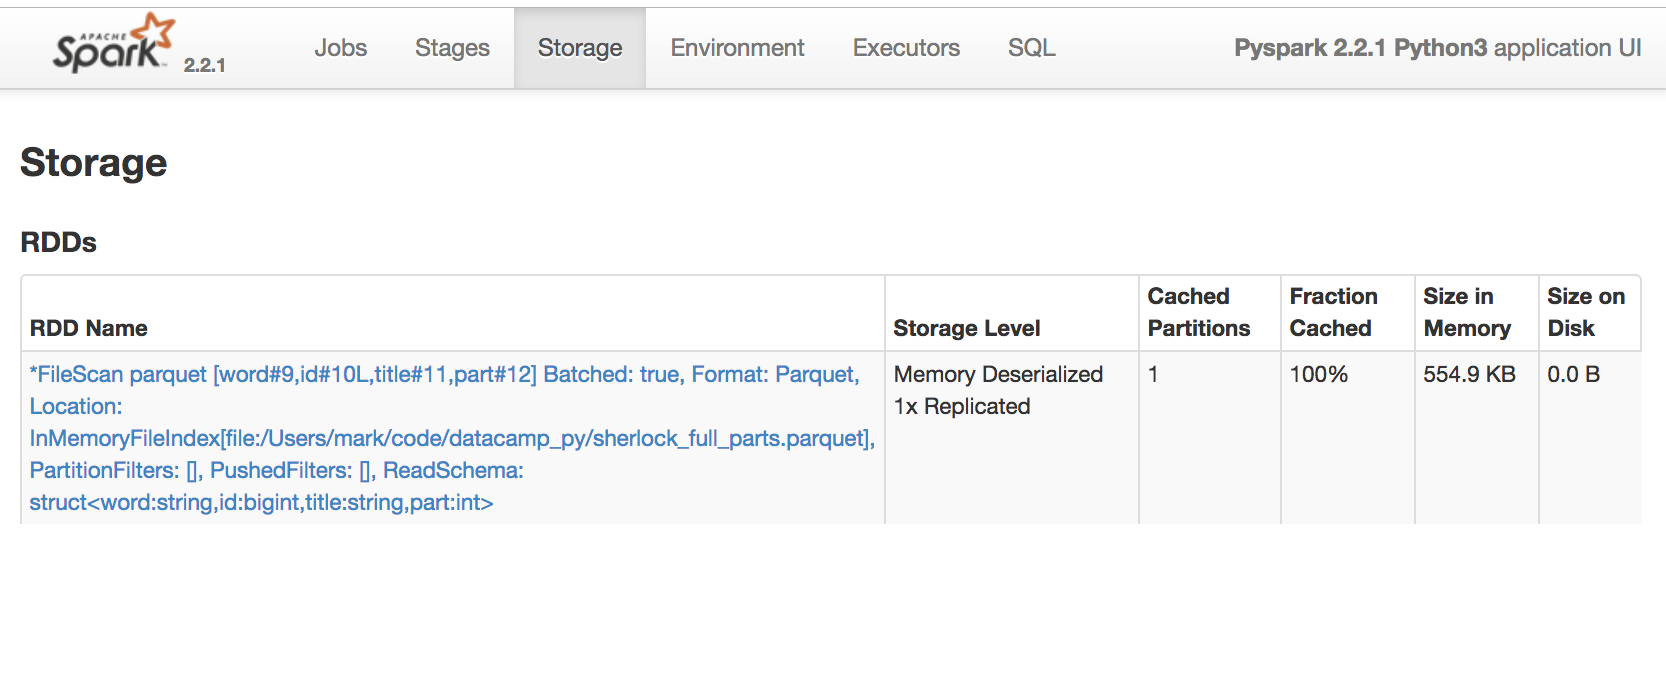
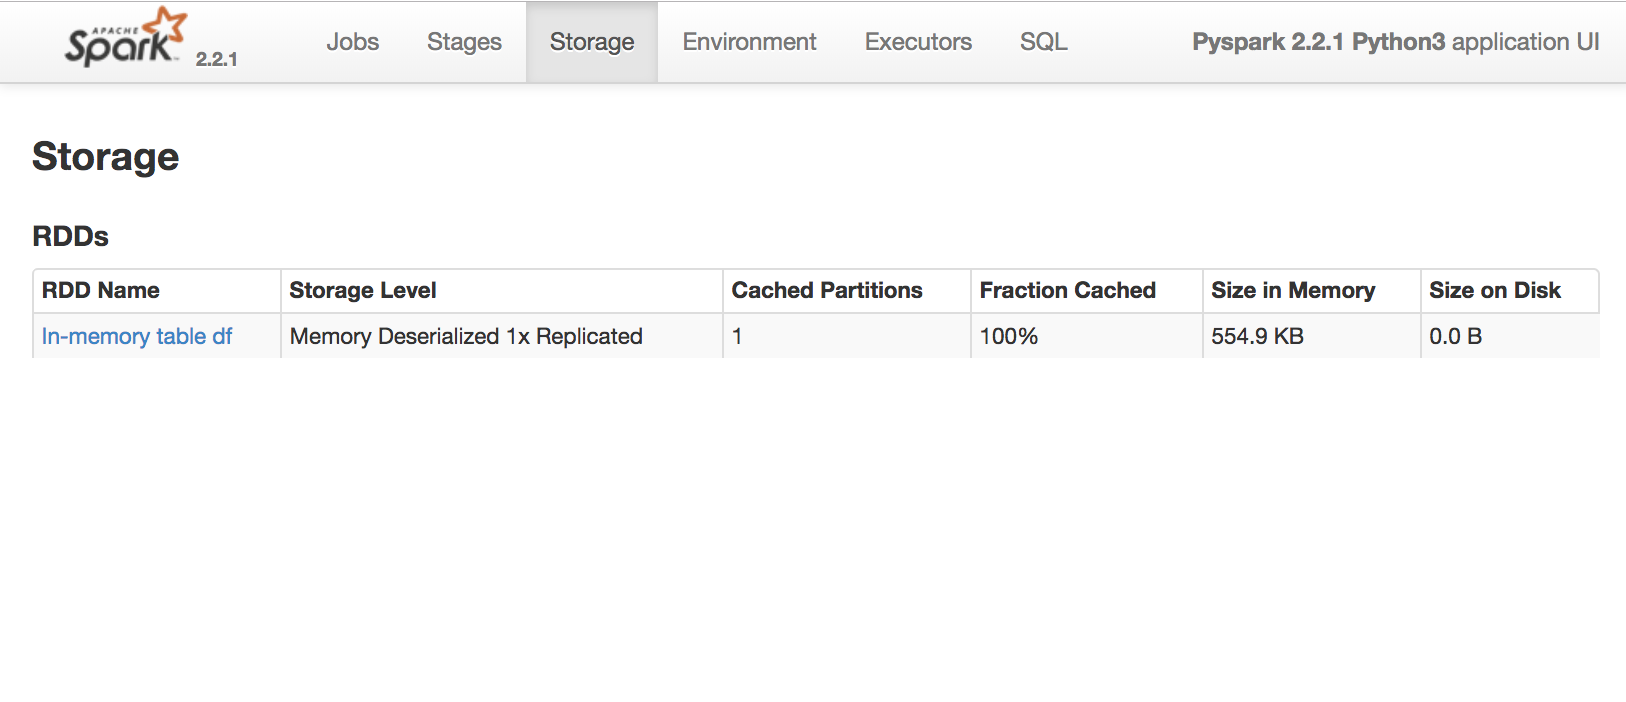
spark.catalog.cacheTable('table1')spark.catalog.uncacheTable('table1')spark.catalog.isCached('table1')spark.catalog.dropTempView('table1')spark.catalog.listTables()
[Table(name='text', database=None, description=None, tableType='TEMPORARY', isTemporary=True)]


Arată unde există partițiile de date
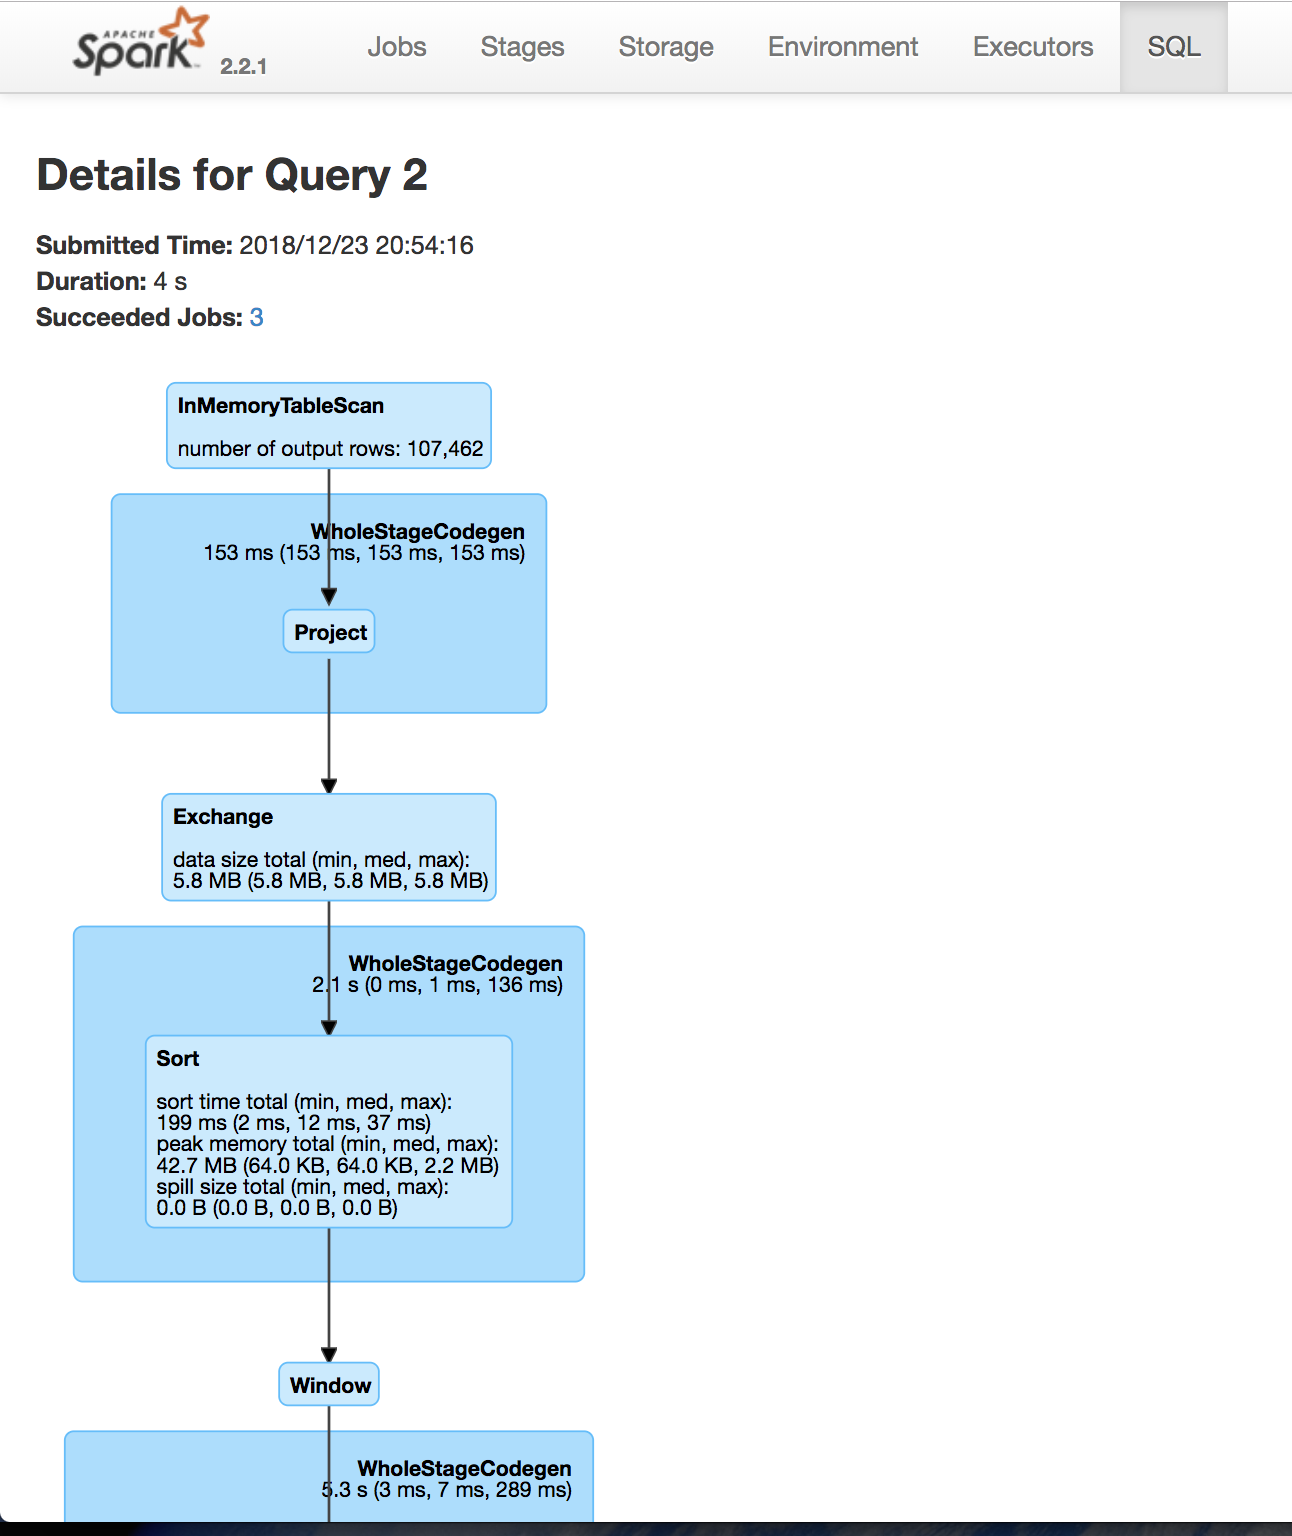
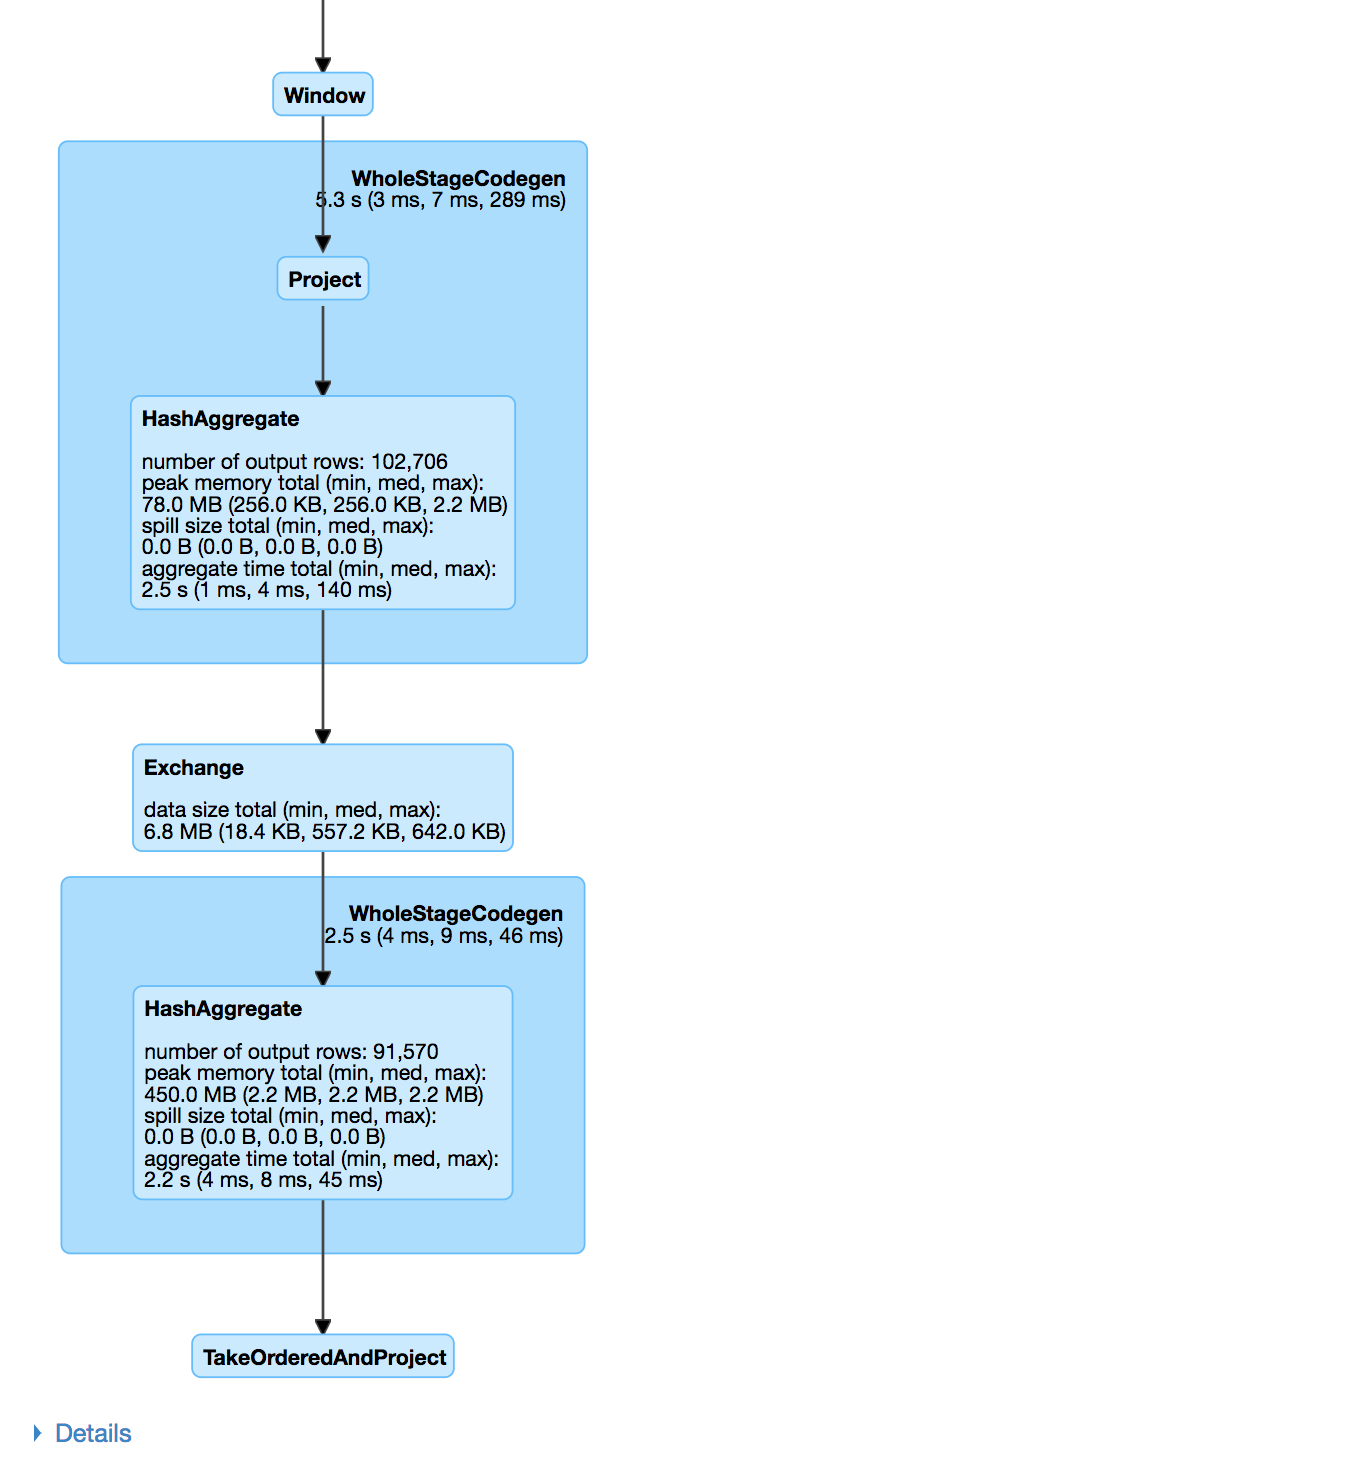
query3agg = """ SELECT w1, w2, w3, COUNT(*) as count FROM ( SELECT word AS w1, LEAD(word,1) OVER(PARTITION BY part ORDER BY id ) AS w2, LEAD(word,2) OVER(PARTITION BY part ORDER BY id ) AS w3 FROM df ) GROUP BY w1, w2, w3 ORDER BY count DESC """spark.sql(query3agg).show()


Introducere în Spark SQL în Python