Data Engineering în Microsoft Fabric
Transformă și analizează date cu Microsoft Fabric
Luis Silva
Solution Architect - Data & AI
Analiză de date end-to-end
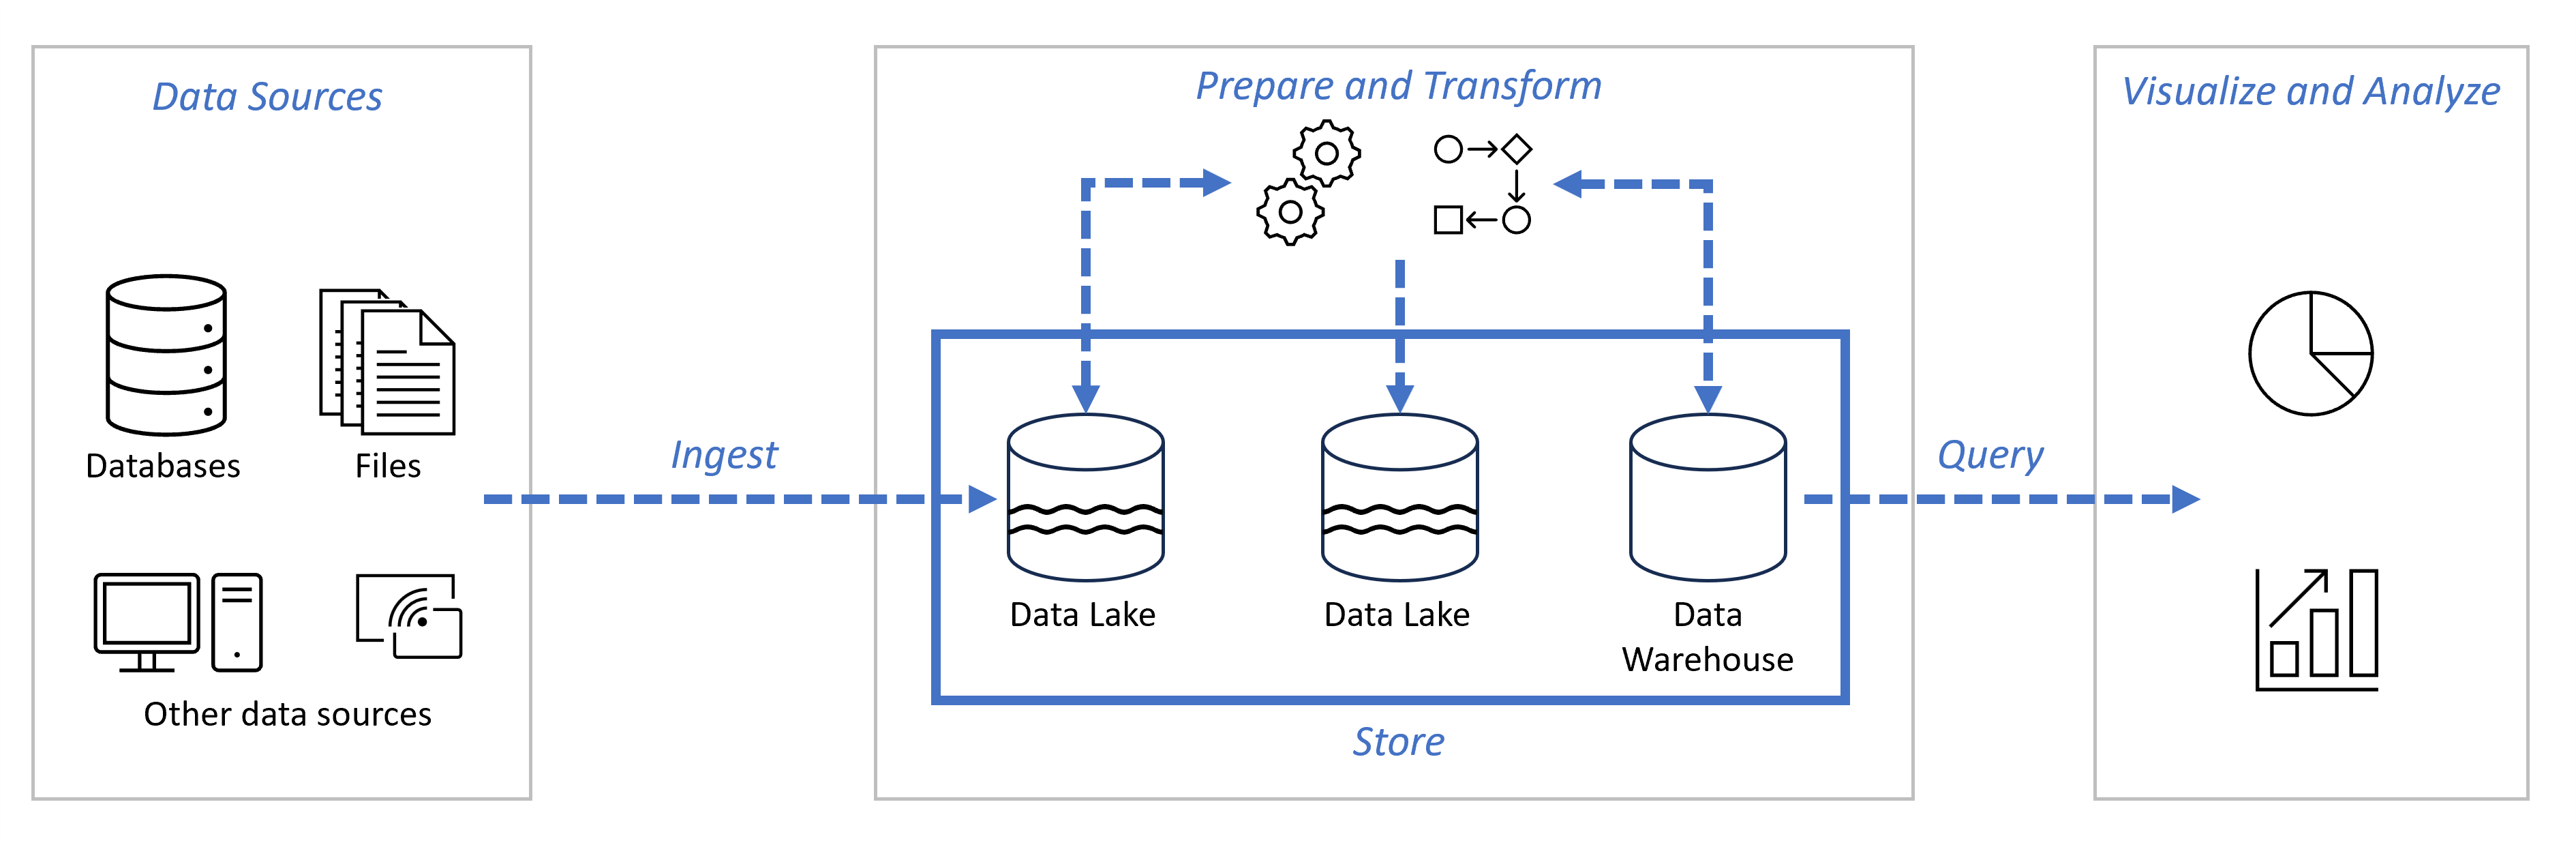
Ingestia datelor din surse și stocarea în data lake
Pregătirea și transformarea datelor
Vizualizarea și analiza datelor
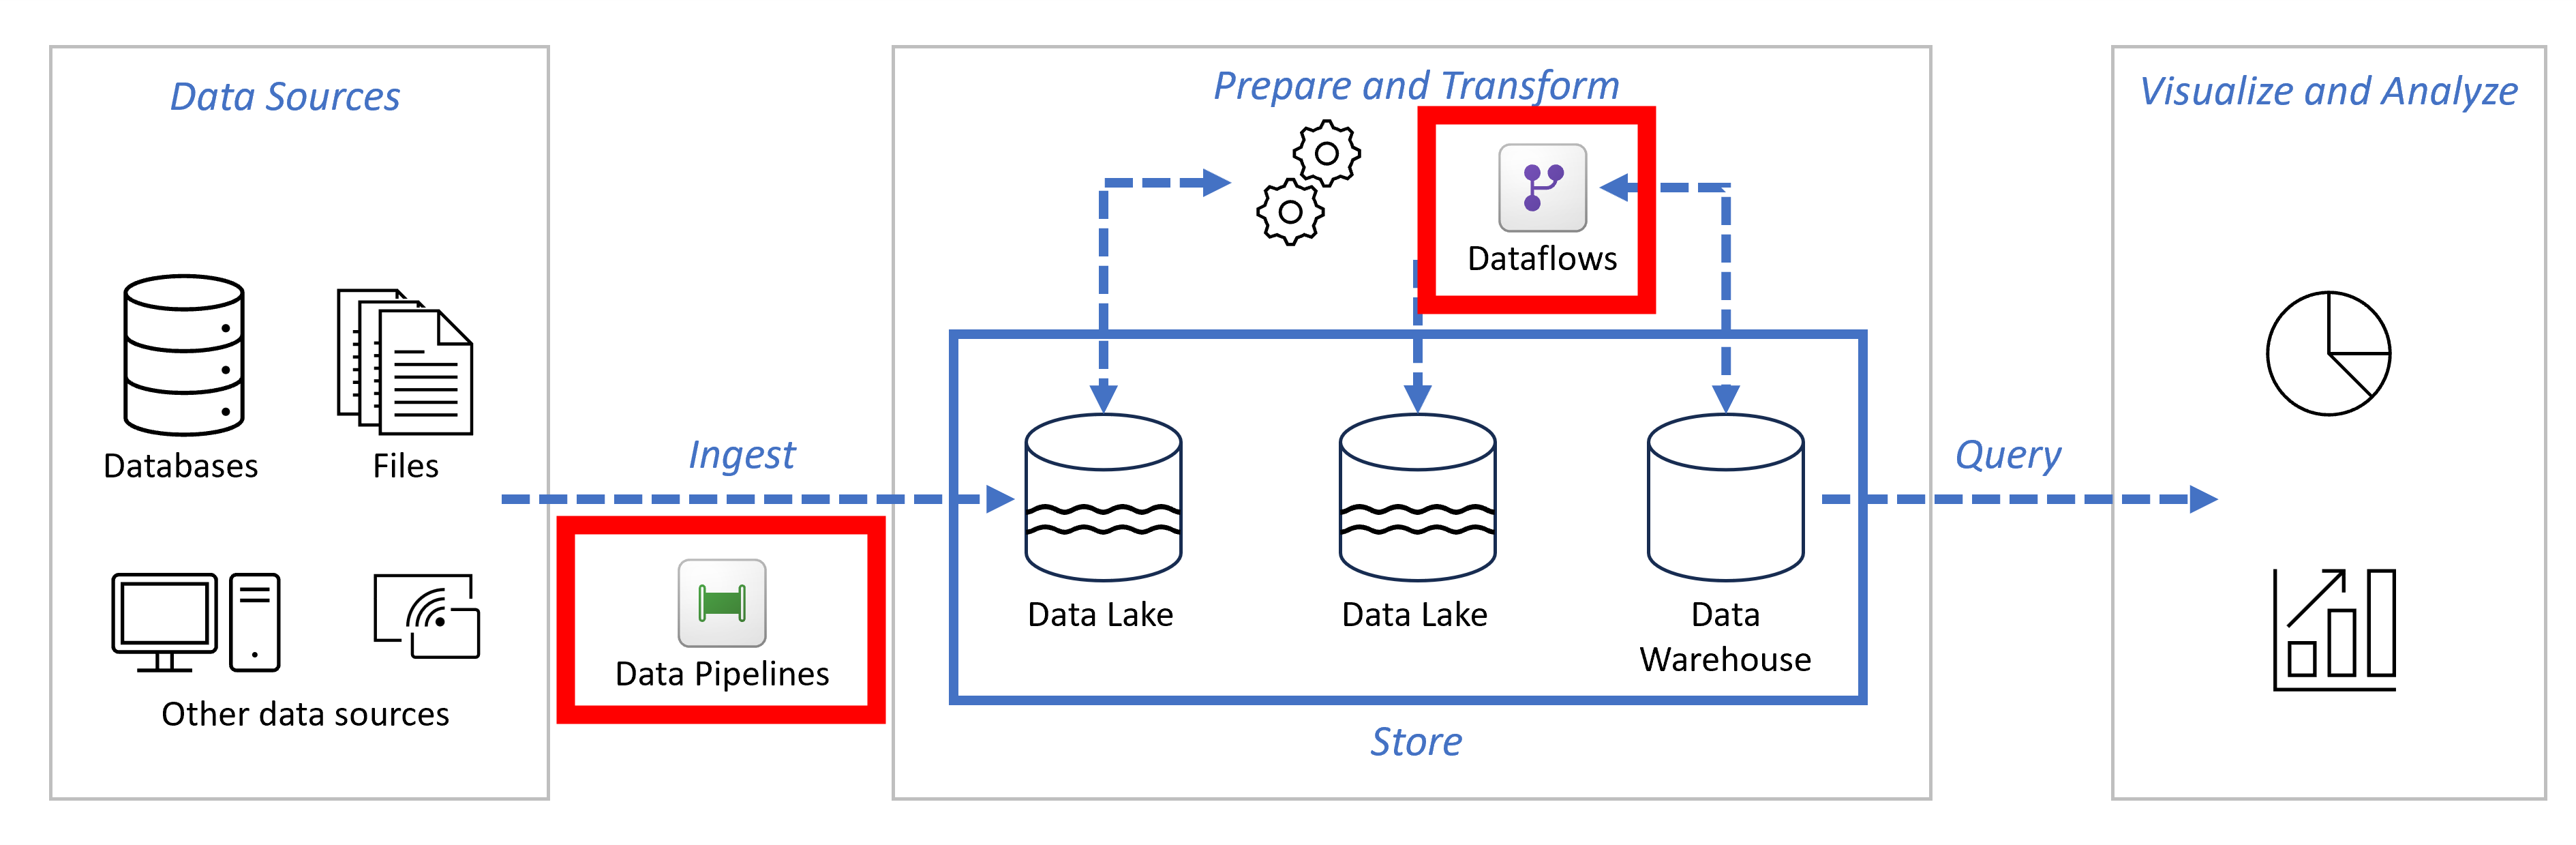
Data Factory
Ingestia, pregătirea și transformarea datelor
Dataflows și Data Pipelines
Dataflows
Interfață low-code pentru ingestia și transformarea datelor
Motor de transformare Power Query
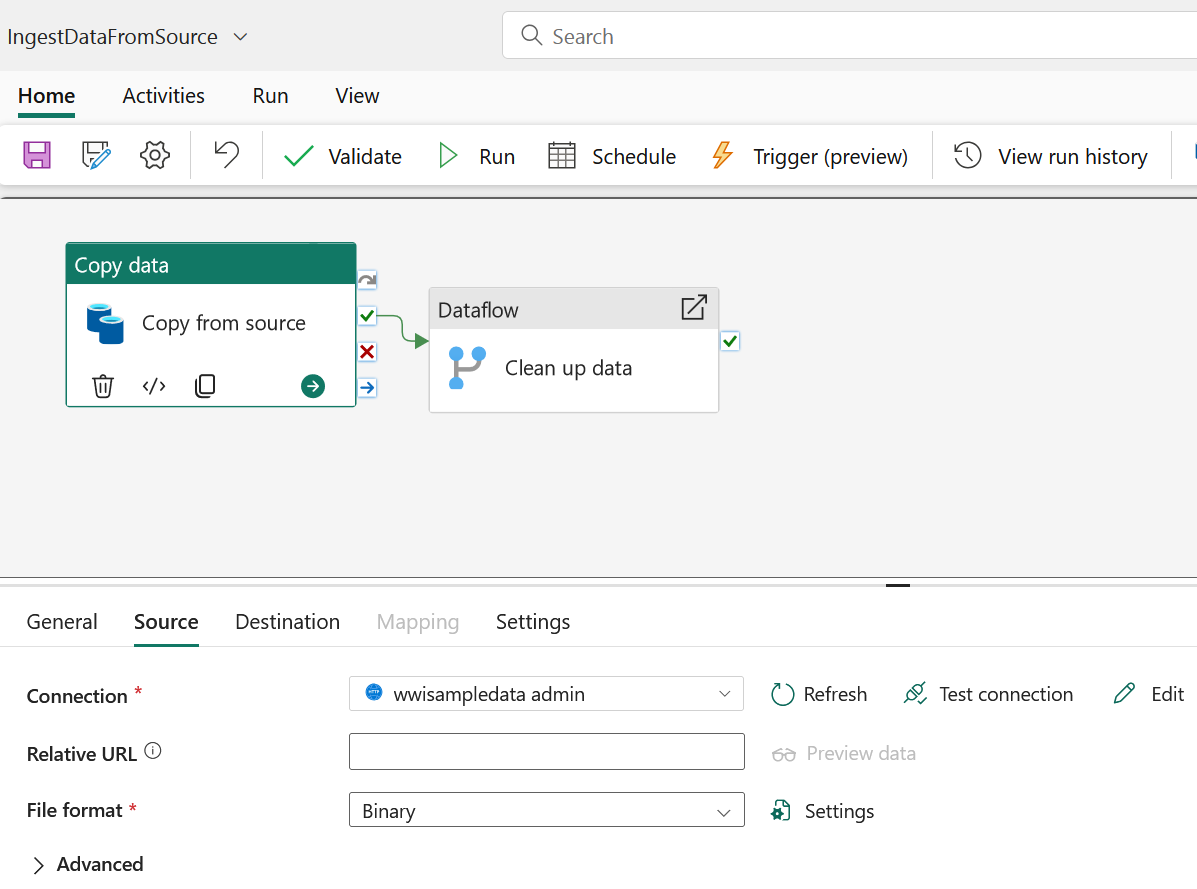
Data Pipelines
Colecție de activități care realizează o sarcină
Tipuri de activități:
Mișcare date (activitate Copy, Dataflow)
Transformare date (Notebook, Stored Procedure, Script)
Control (Switch, If, ForEach, Wait)
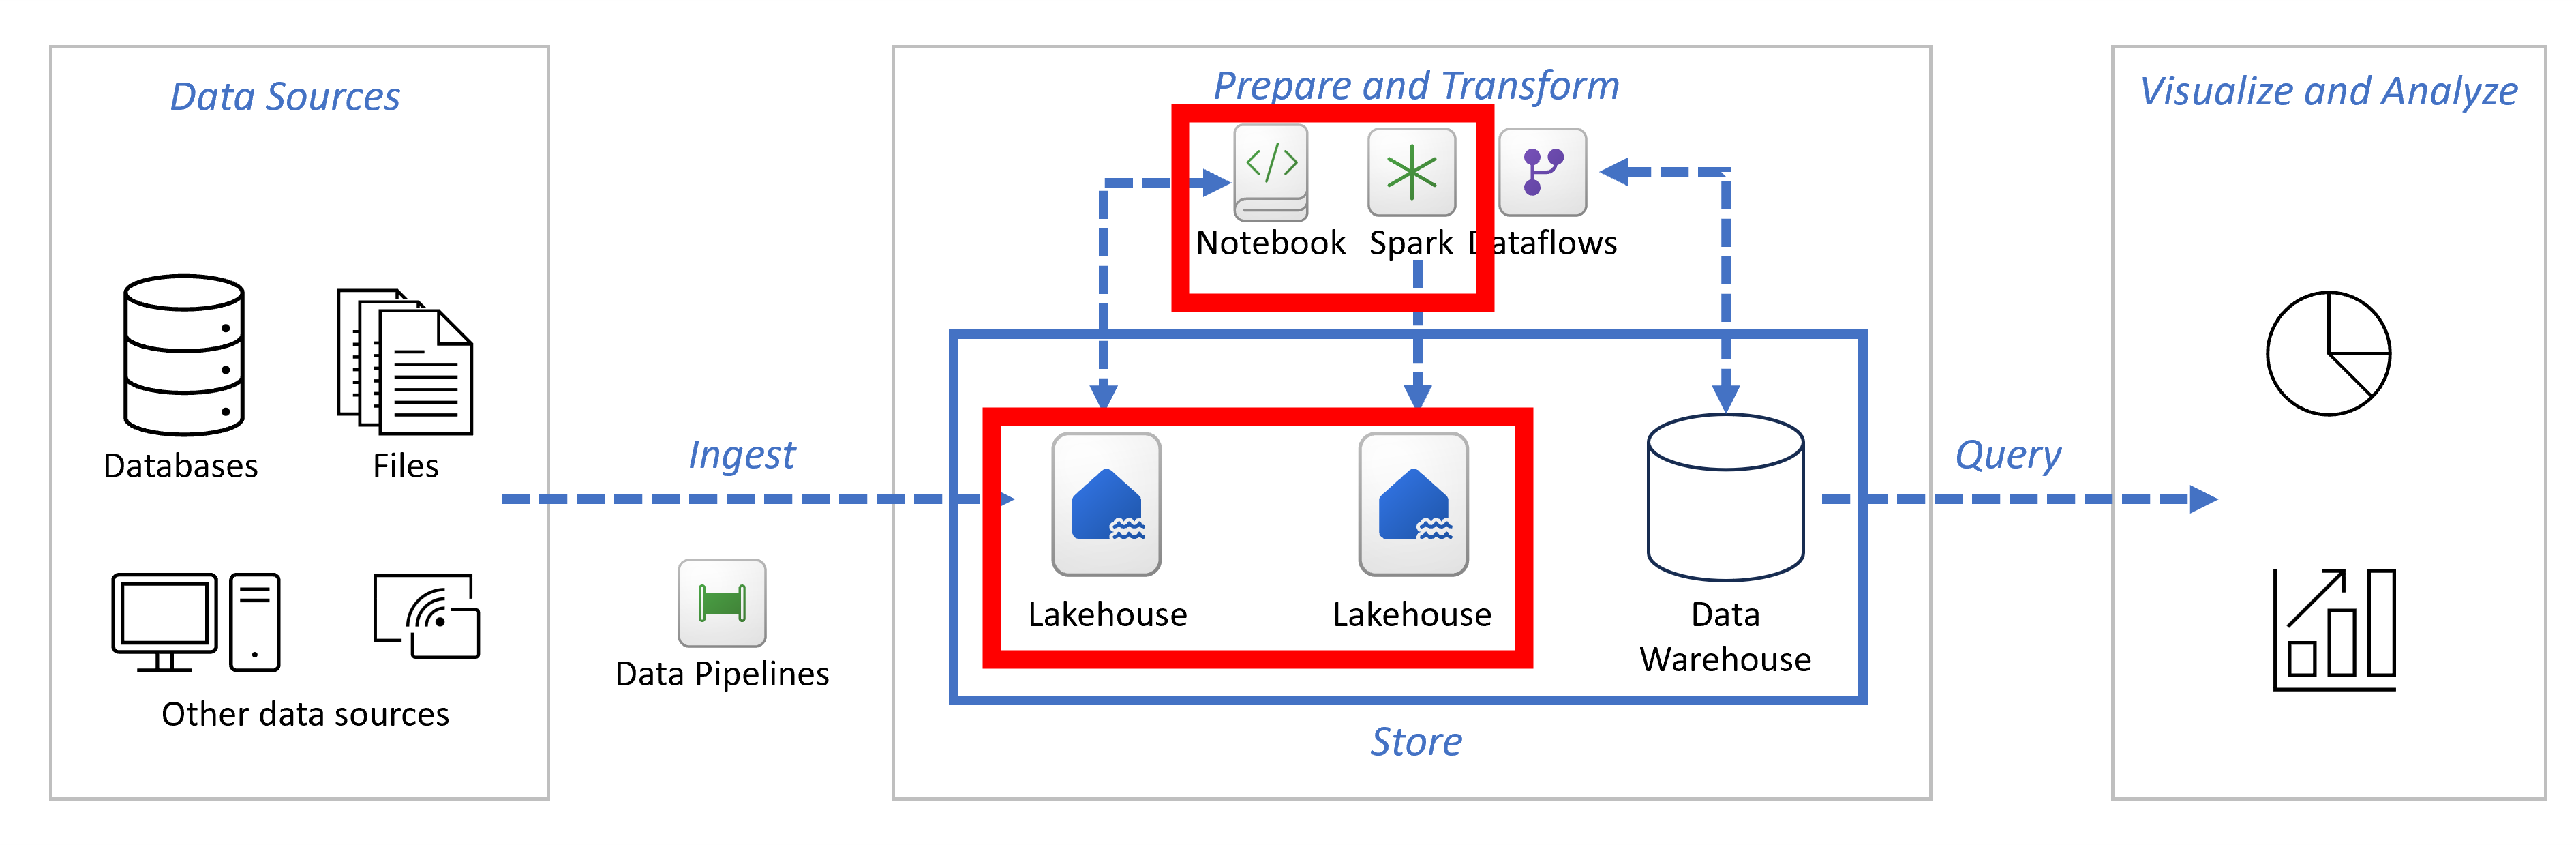
Synapse Data Engineering
Lakehouses
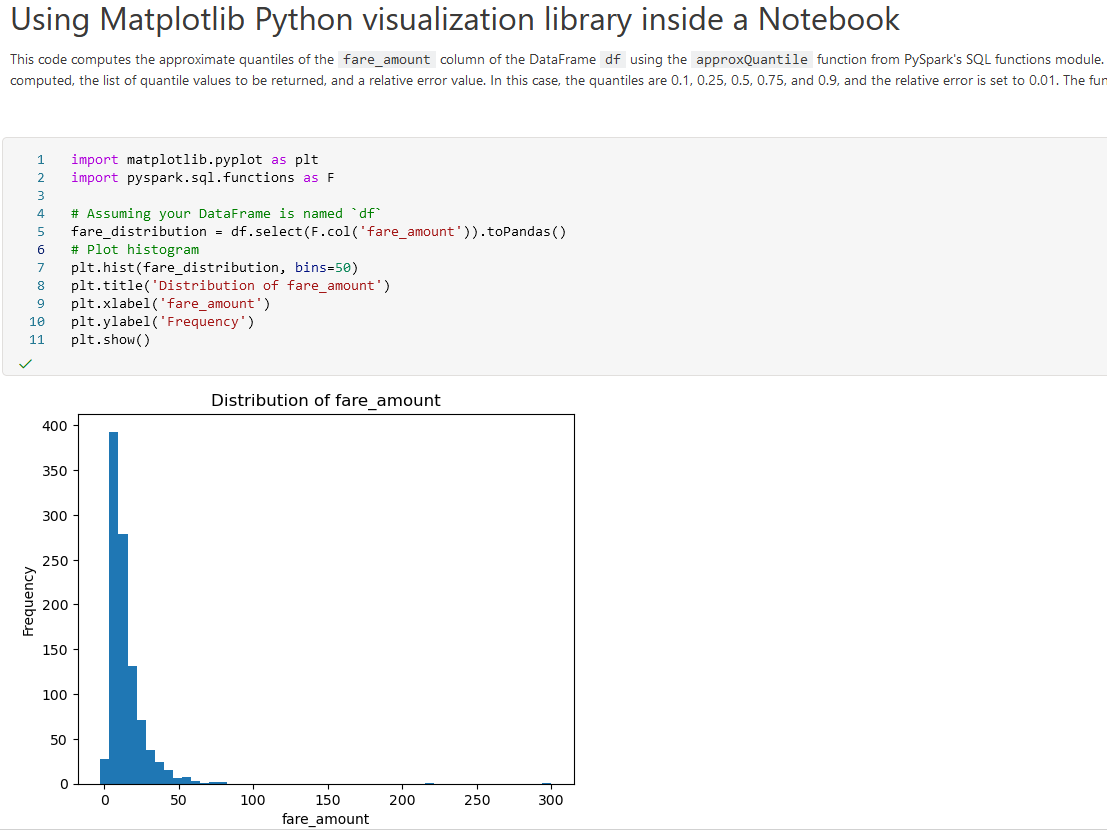
Notebooks
Definiții Apache Spark Job
Lakehouses
Date structurate (tabele)
Date nestructurate (fișiere)
Notebooks
Interfață web interactivă
Cod de manipulare a datelor
Vizualizări de date
Comentarii / Explicații
Suport multi-limbaj:
PySpark (Python)
Spark (Scala)
Spark SQL (SQL)
SparkR (R)
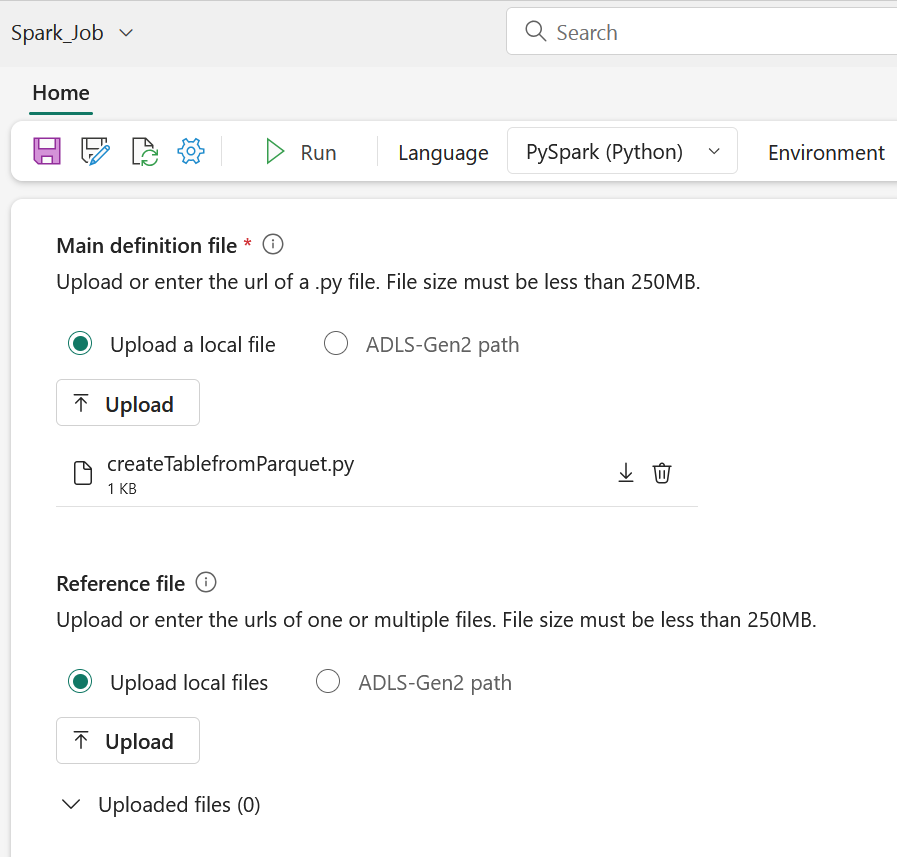
Definiții Apache Spark Job
Trimitere joburi batch/streaming către clustere Spark
Alternativă sau complement la Notebooks:
Notebooks pentru explorarea, prototiparea și dezvoltarea colaborativă a datelor
Spark Job Definition pentru automatizarea codului de procesare pregătit pentru producție
Synapse Data Warehouse
Funcționează ca un depozit de date relațional tradițional
Stochează date în OneLake folosind formatul deschis Delta Lake
Permite interoperabilitatea cu alte sarcini de lucru Fabric
Nu necesită crearea mai multor copii ale datelor
Alegerea unui spațiu de stocare
Lakehouse
Date nestructurate (fișiere)
Spark ca interfață principală de dezvoltare
Warehouse
Date structurate (tabele)
T-SQL ca interfață principală de dezvoltare
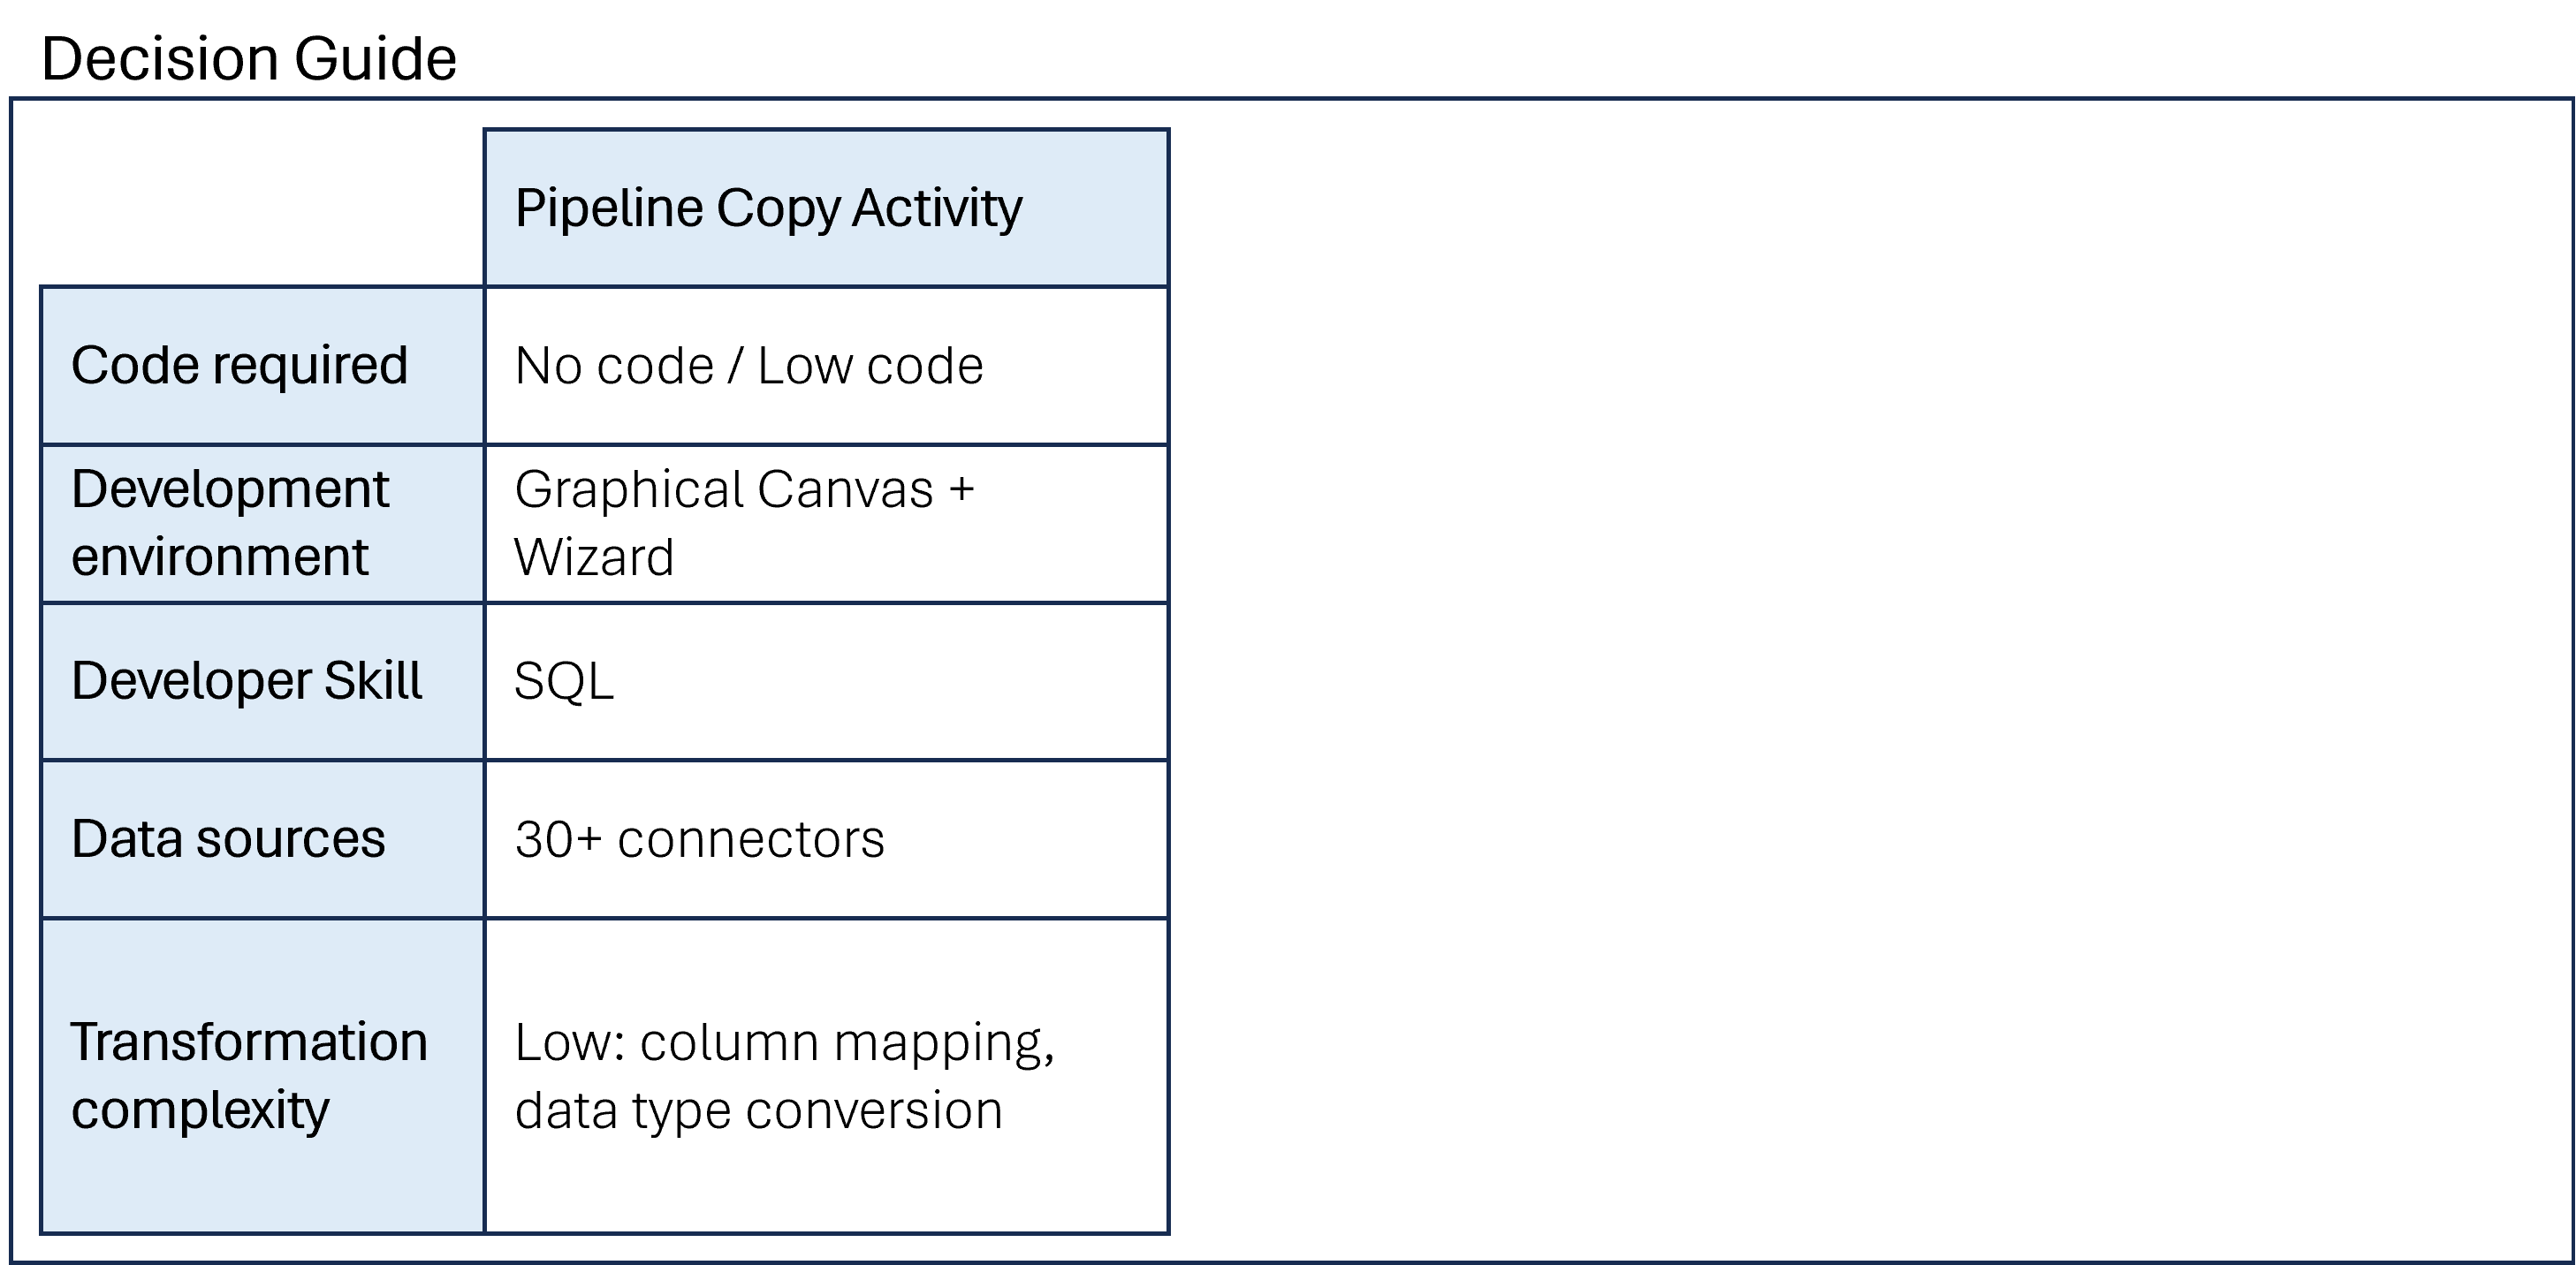
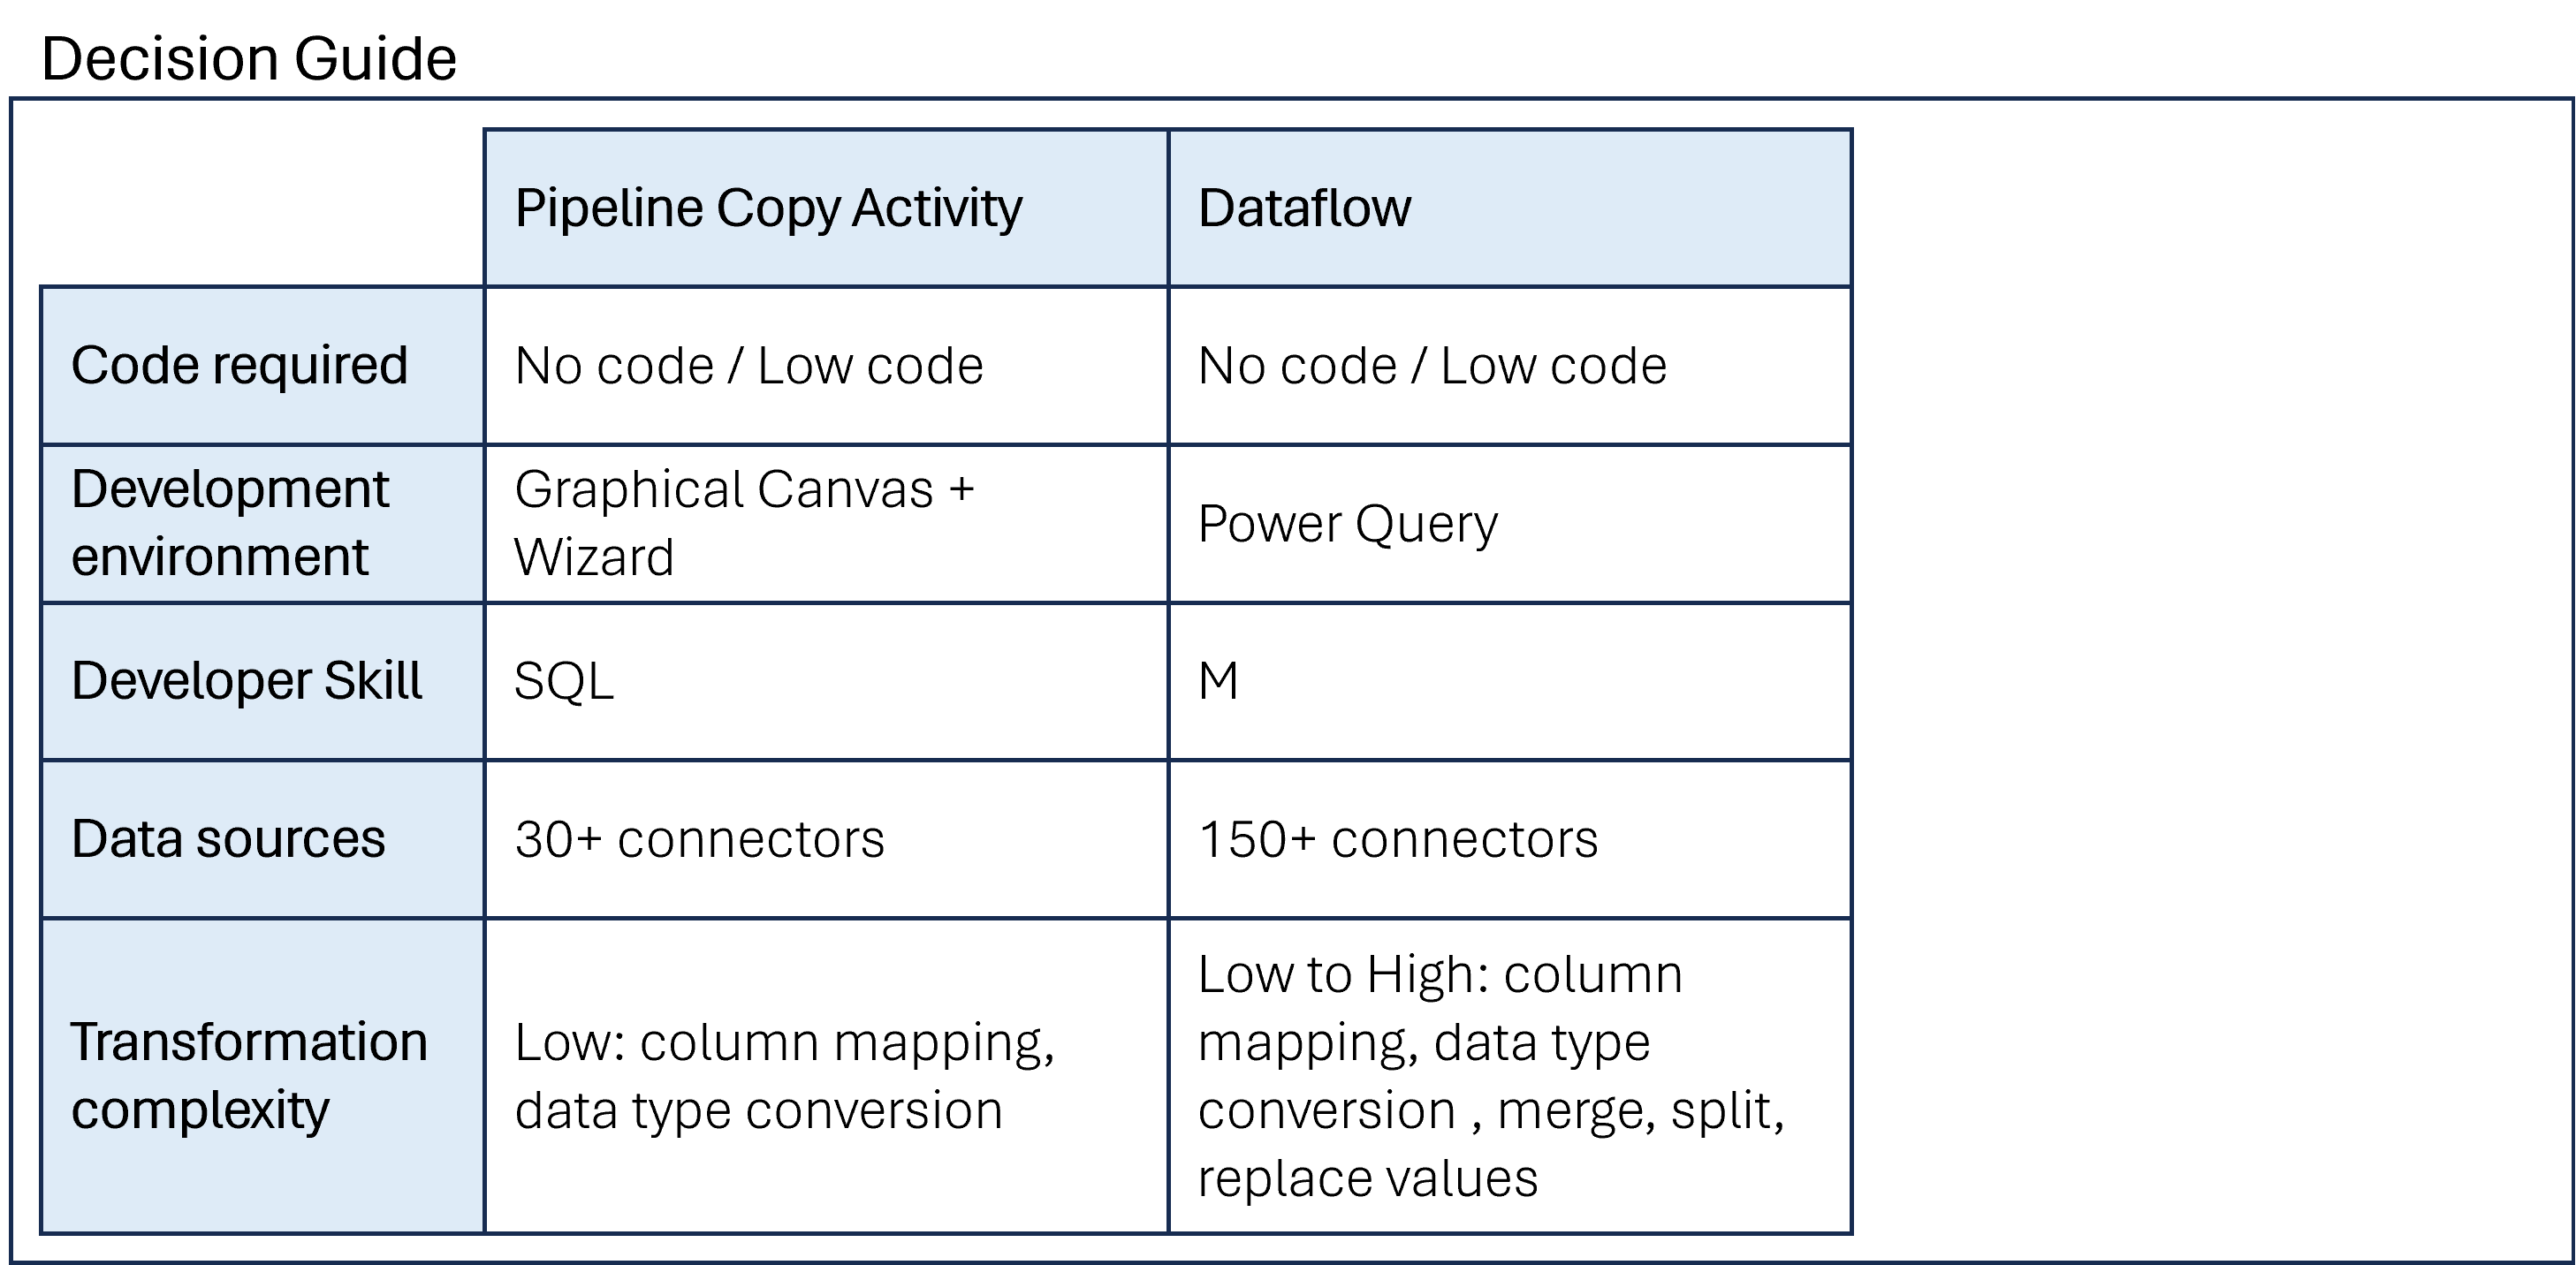
Alegerea unui instrument de copiere a datelor
Să exersăm!
Transformă și analizează date cu Microsoft Fabric
Preparing Video For Download...