Introducere în XPATH

Web Scraping în R

Timo Grossenbacher

Instructor

XML Path Language

  • Se formulează o cale printr-un arbore HTML, de ex. //div/p[@class = "blue"] (echivalent cu div > p.blue)
  • Selectarea nodurilor pe baza proprietăților altor noduri
  • Selecții mai avansate și personalizate sunt posibile
  • De exemplu: selectarea elementelor pe baza proprietăților copiilor lor, de ex. doar elementele div care conțin noduri a cu clasa special
Web Scraping în R

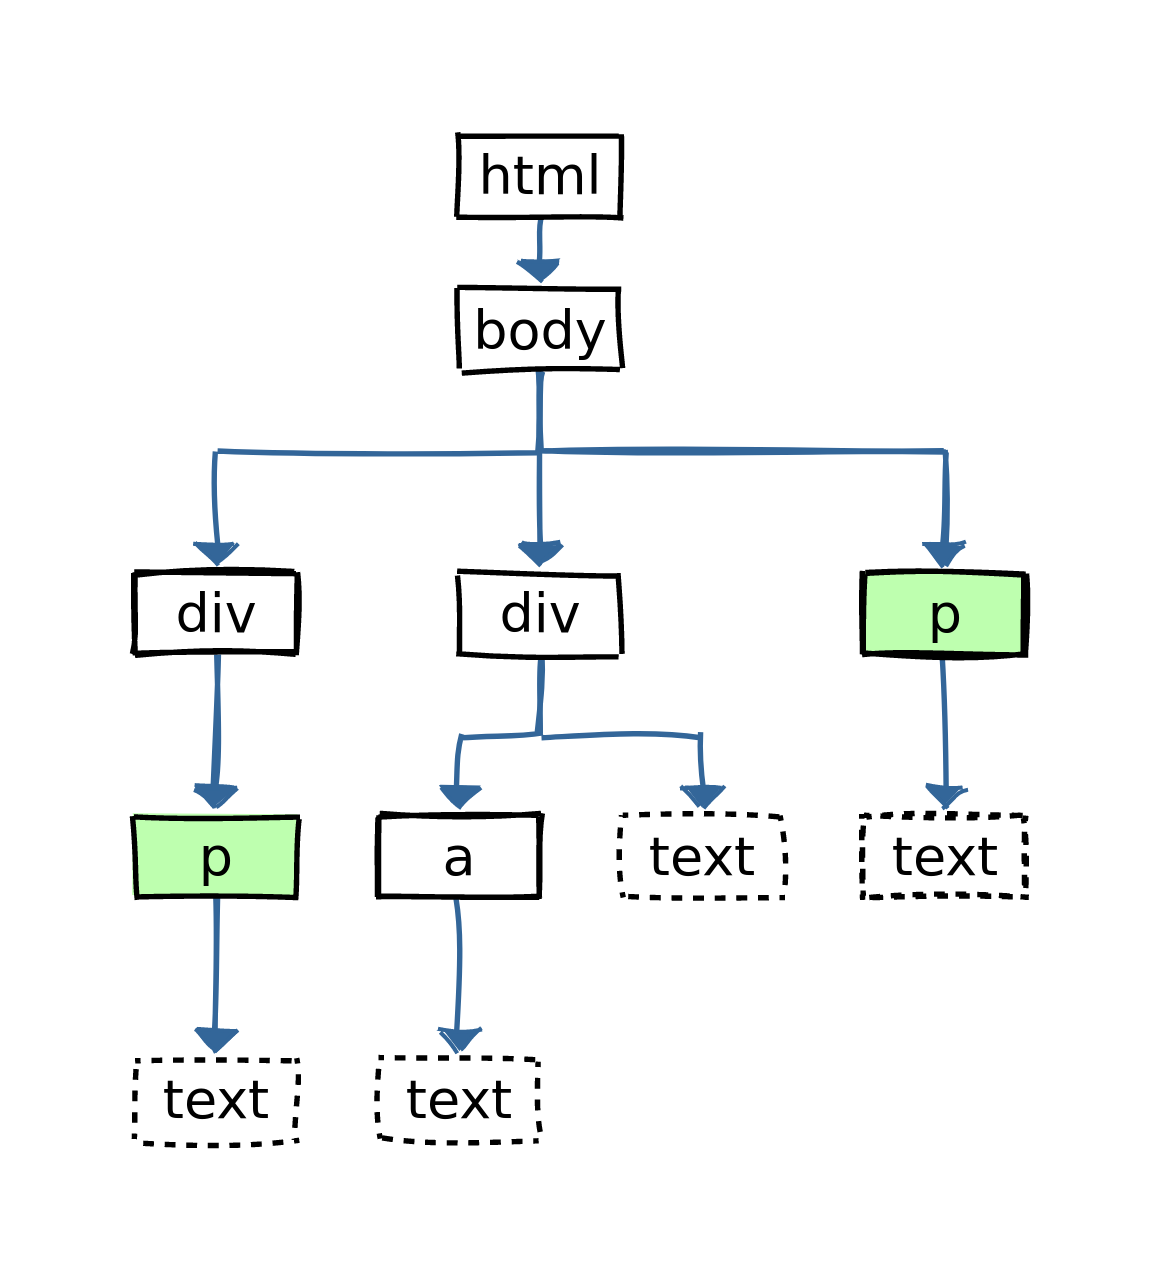
Un arbore HTML simplu în care sunt selectate toate elementele p

html %>%
    html_elements(xpath = '//p')
# CSS selector equivalent: p
html %>%
    html_elements(xpath = '//body//p')
# CSS selector equivalent: body p
html %>%
    html_elements(xpath = '/html/body//p')
# CSS selector equivalent: html > body p
Web Scraping în R

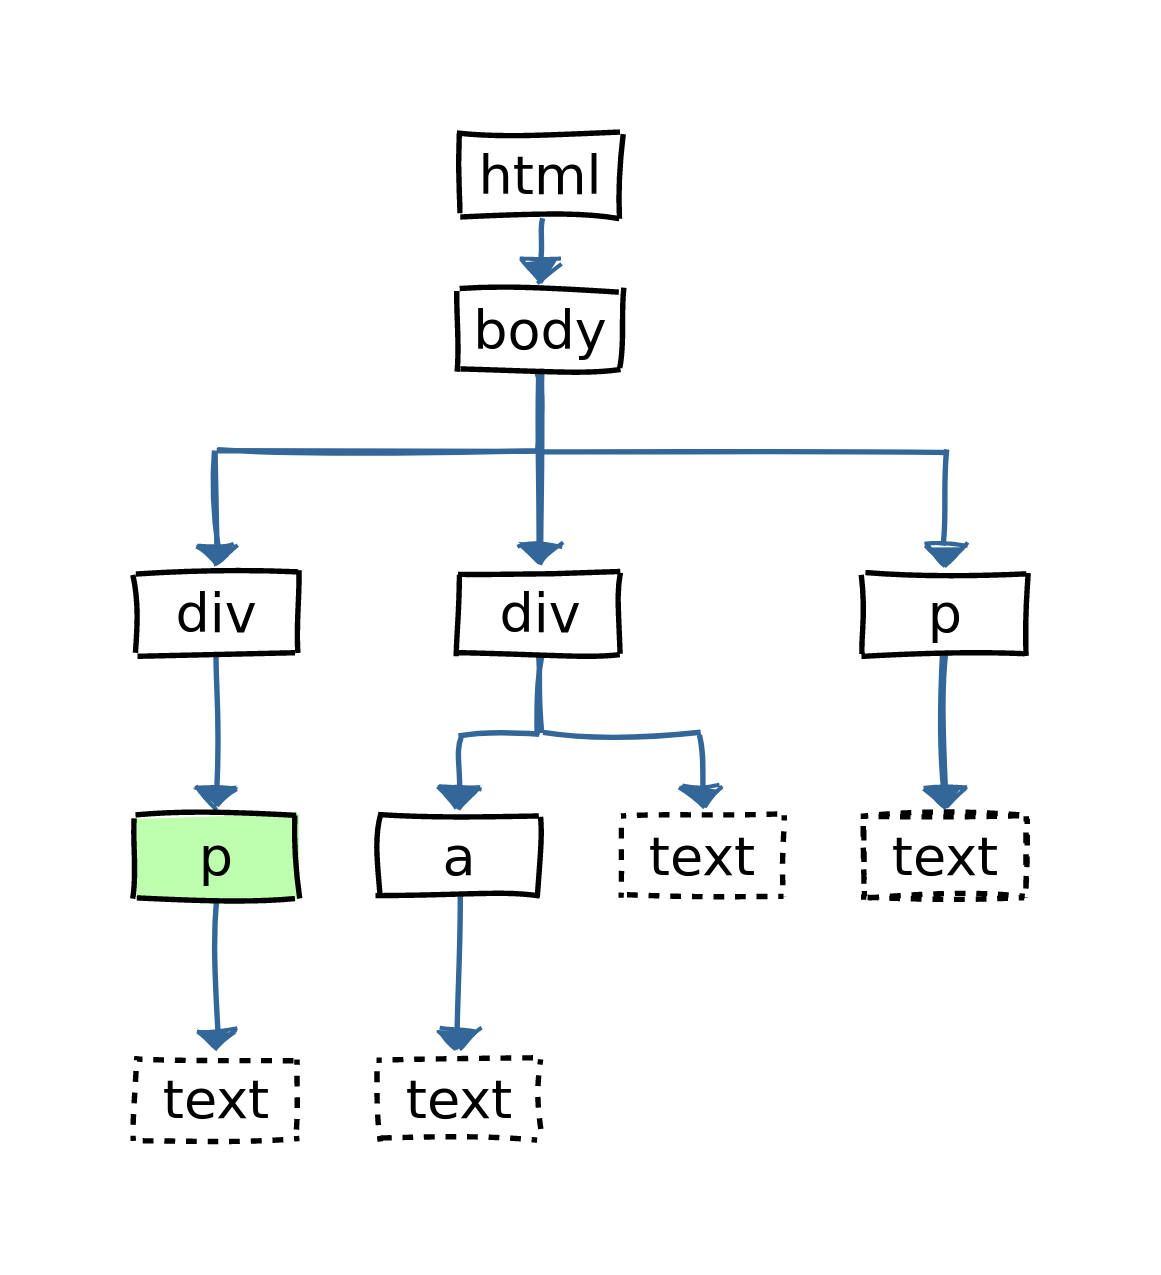
Un arbore HTML simplu în care sunt selectate doar elementele p din interiorul div-urilor

html %>%
    html_elements(xpath = '//div/p')
# CSS selector equivalent: div > p
Web Scraping în R

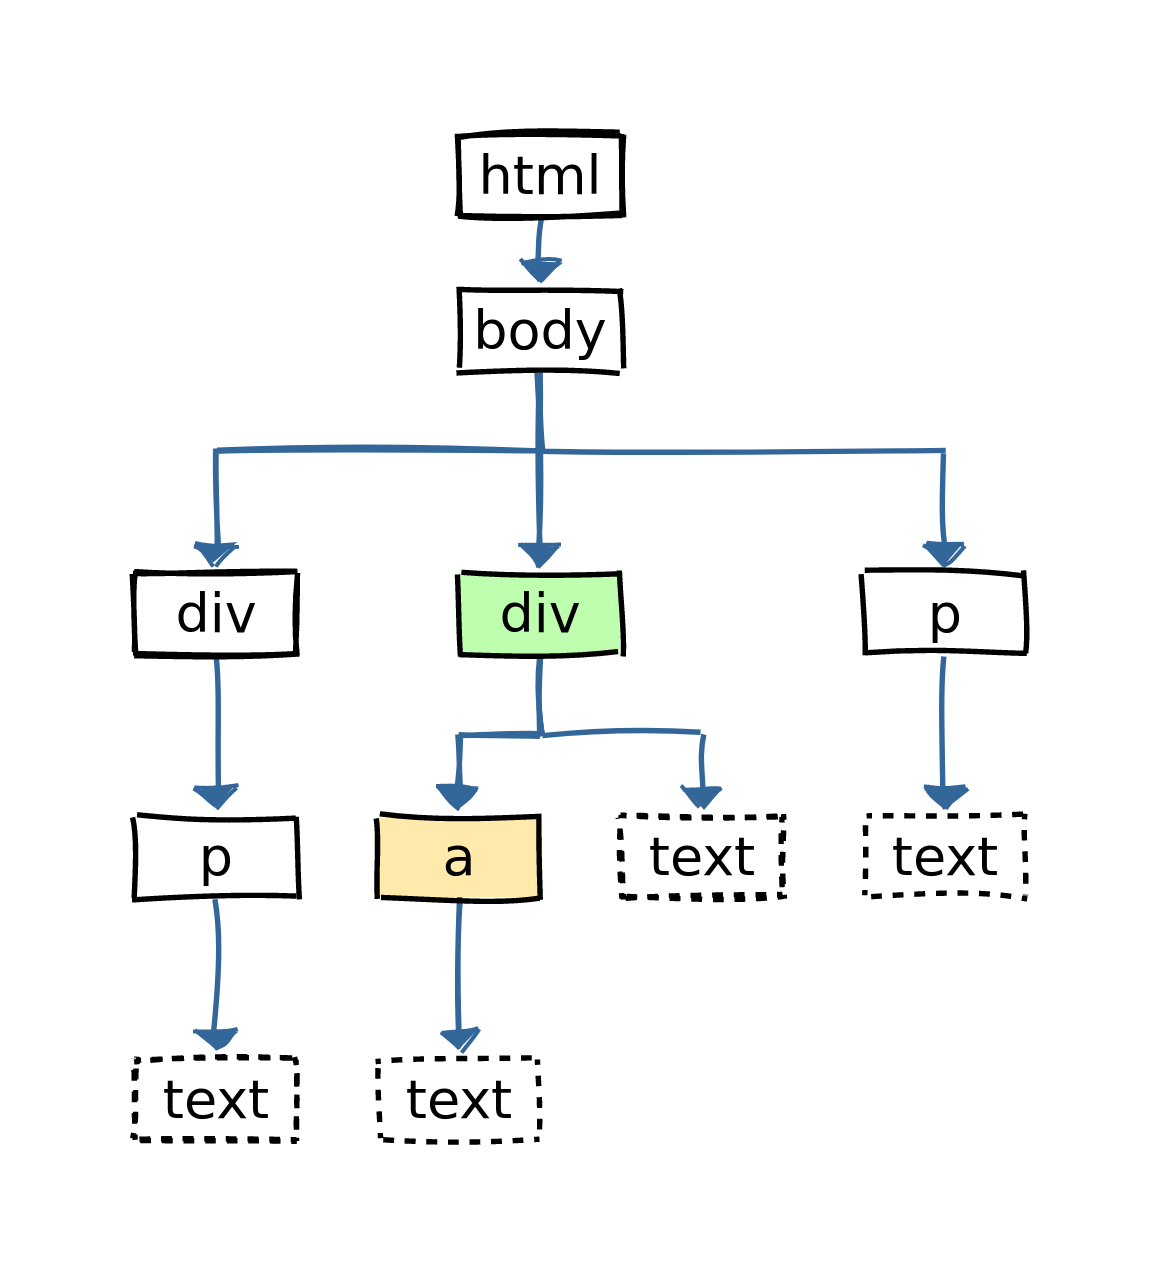
Un arbore HTML simplu în care sunt selectate doar div-urile cu copii de tip a

html %>%
    html_elements(xpath = '//div[a]')
# CSS selector equivalent: none
Web Scraping în R

Sintaxă: axe, pași și predicate

  • Axe: / sau //
  • Pași: tipuri HTML precum span și a
  • Predicate: [...]
  • Exemplu: //span/a[@class = "external"] (CSS: span > a.external)
  • Exemplu: //*[@id = "special"]//div (CSS: #special div sau *#special div)
Web Scraping în R

Să exersăm!

Web Scraping în R

Preparing Video For Download...