Estimarea modelului și verosimilitatea

Introducere în modelarea liniară în Python

Jason Vestuto

Data Scientist

Estimare
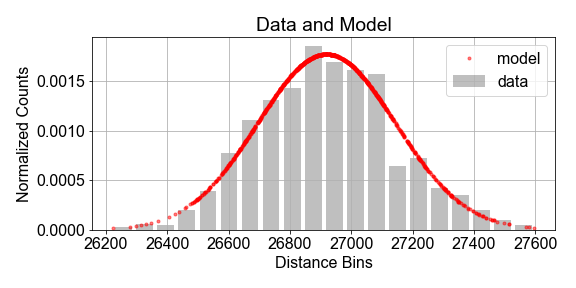
Grafic histogramă, frecvențe normalizate față de intervale de distanță, date ca bare gri și model ca o curbă gaussiană roșie care se potrivește cu vârfurile barelor gri

Introducere în modelarea liniară în Python

Estimare

# Define gaussian model function
def gaussian_model(x, mu, sigma):
    coeff_part = 1/(np.sqrt(2 * np.pi * sigma**2))
    exp_part = np.exp( - (x - mu)**2 / (2 * sigma**2) )
    return coeff_part*exp_part
# Compute sample statistics
mean = np.mean(sample)
stdev = np.std(sample)
# Model the population using sample statistics
population_model = gaussian(sample, mu=mean, sigma=stdev)
Introducere în modelarea liniară în Python

Verosimilitate vs. probabilitate

  • Probabilitate condiționată: $P( \text{outcome A} | \text{given B})$
  • Probabilitate: $P( \text{data} | \text{model} )$
  • Verosimilitate: $L( \text{model} | \text{data} )$
Introducere în modelarea liniară în Python

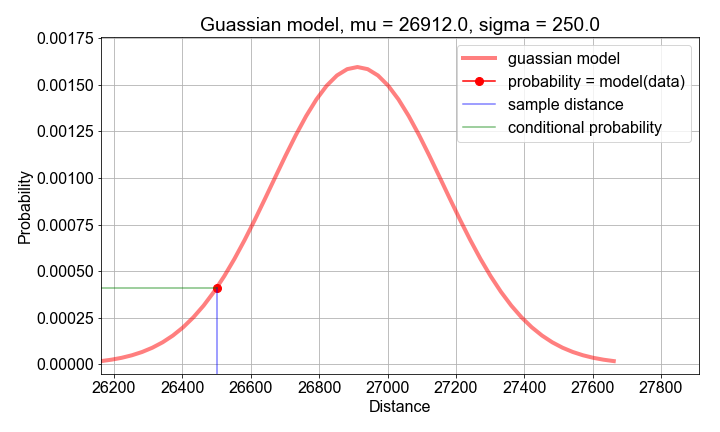
Calculul verosimilității

Grafic probabilitate față de distanță, ca o curbă gaussiană roșie, cu un punct aproape de marginea stângă și segmente orizontale și verticale care conectează punctul la fiecare axă

Introducere în modelarea liniară în Python

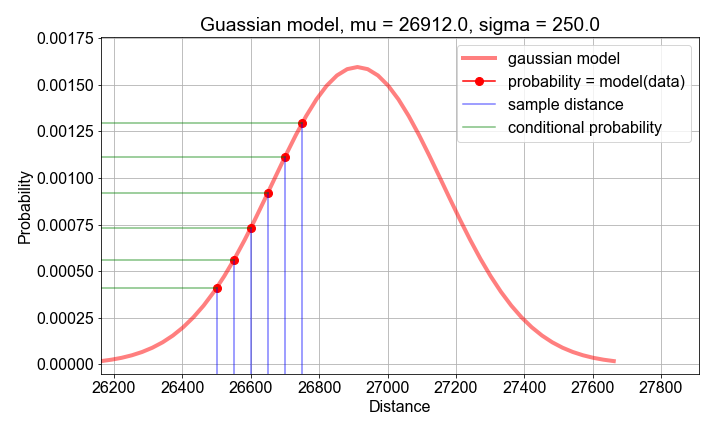
Calculul verosimilității

Grafic probabilitate față de distanță, ca o curbă gaussiană roșie, cu 6 puncte de la marginea stângă spre centru, cu segmente orizontale și verticale care conectează fiecare punct la ambele axe

Introducere în modelarea liniară în Python

Verosimilitatea din probabilități

# Guess parameters
mu_guess = np.mean(sample_distances)
sigma_guess = np.std(sample_distances)
# For each sample point, compute a probability
probabilities = np.zeros(len(sample_distances))
for n, distance in enumerate(sample_distances):
    probabilities[n] = gaussian_model(distance, mu=mu_guess, sigma=sigma_guess)
likelihood = np.product(probs)
loglikelihood = np.sum(np.log(probs))
Introducere în modelarea liniară în Python

Estimarea prin maximum de verosimilitate
# Create an array of mu guesses
low_guess = sample_mean - 2*sample_stdev
high_guess = sample_mean + 2*sample_stdev
mu_guesses = np.linspace(low_guess, high_guess, 101)
# Compute the loglikelihood for each guess
loglikelihoods = np.zeros(len(mu_guesses))
for n, mu_guess in enumerate(mu_guesses):
    loglikelihoods[n] = compute_loglikelihood(sample_distances, mu=mu_guess, sigma=sample_stdev)
# Find the best guess
max_loglikelihood = np.max(loglikelihoods)
best_mu = mu_guesses[loglikelihoods == max_loglikelihood]
Introducere în modelarea liniară în Python

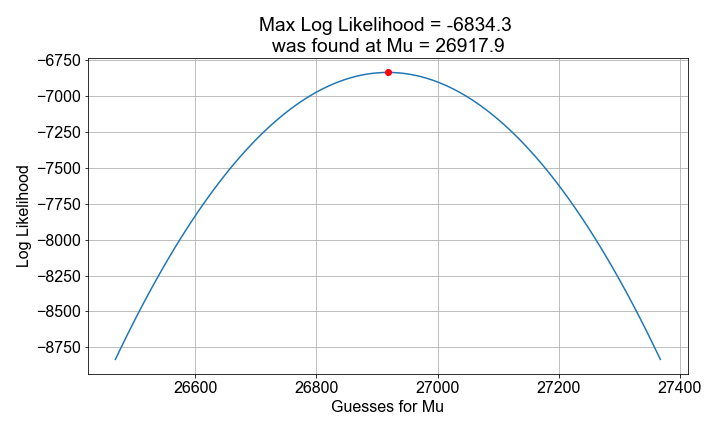
Estimarea prin maximum de verosimilitate

Grafic parabolă cu deschidere în jos, cu punct roșu la maximum, pe axele log-verosimilitate față de valorile lui mu

Introducere în modelarea liniară în Python

Să exersăm!

Introducere în modelarea liniară în Python

Preparing Video For Download...