Erori de model și aleatorism

Introducere în modelarea liniară în Python

Jason Vestuto

Data Scientist

Tipuri de erori

  1. Eroare de măsurare
    • ex.: senzor defect, măsurători înregistrate greșit
  2. Bias de eșantionare
    • ex.: temperaturi doar din august, când zilele sunt cele mai calde
  3. Întâmplare aleatorie
Introducere în modelarea liniară în Python

Ipoteza nulă

Întrebare: Efectul observat reflectă o relație reală sau se datorează hazardului?

Răspuns: verificați Ipoteza nulă.

Introducere în modelarea liniară în Python

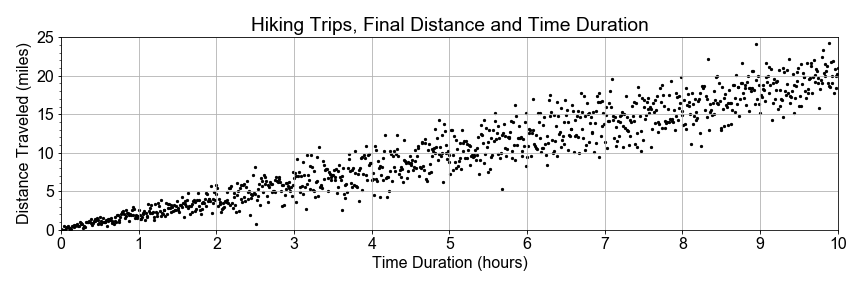
Date ordonate

Grafic scatter al datelor de drumeție, pe axe distanță parcursă în mile față de durată în ore

Introducere în modelarea liniară în Python

Gruparea datelor

Grafic scatter al datelor de drumeție, pe axe distanță parcursă în mile față de durată în ore, cu durate sub 5 ore în roșu și cele mai mari în albastru

Introducere în modelarea liniară în Python

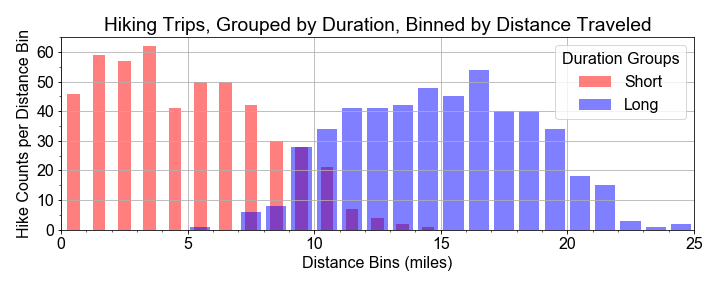
Gruparea datelor

Două histograme aproximativ în formă de clopot: una roșie pentru drumeții scurte, centrată pe ~5 mile, și una albastră pentru drumeții lungi, centrată pe ~15 mile

  • Grup durată scurtă, medie = 5
  • Grup durată lungă, medie = 15
Introducere în modelarea liniară în Python

Statistică de test

# Group into early and late times
group_short = sample_distances[times < 5]
group_long = sample_distances[times > 5]
# Resample distributions
resample_short = np.random.choice(group_short, size=500, replace=True)
resample_long = np.random.choice(group_long, size=500, replace=True)
# Test Statistic
test_statistic = resample_long - resample_short
# Effect size as mean of test statistic distribution
effect_size = np.mean(test_statistic)
Introducere în modelarea liniară în Python

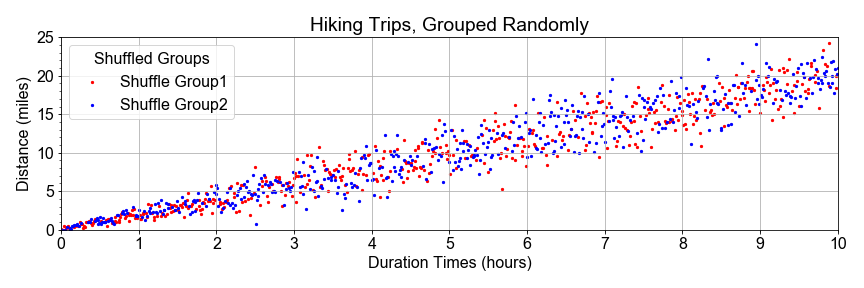
Amestecare și regrupare

Grafic scatter al datelor de drumeție, pe axe distanță parcursă în mile față de durată în ore, cu puncte roșii și albastre intercalate pentru toate duratele

Introducere în modelarea liniară în Python

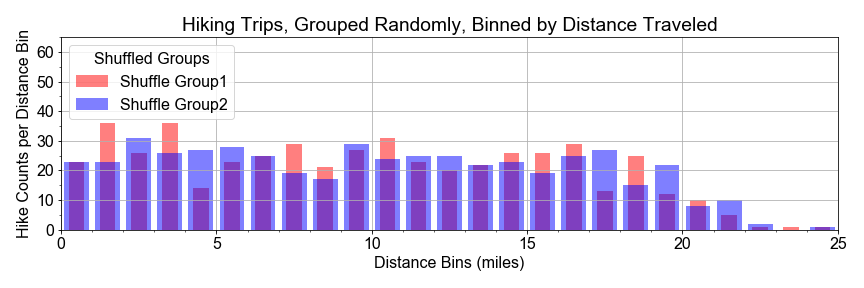
Amestecare și regrupare

2 histograme aproape complet suprapuse, între 0 și 25 mile, cu forme similare

Introducere în modelarea liniară în Python

Amestecare și împărțire

# Concatenate and Shuffle
shuffle_bucket = np.concatenate((group_short, group_long))
np.random.shuffle(shuffle_bucket)
# Split in the middle
slice_index = len(shuffle_bucket)//2
shuffled_half1 = shuffle_bucket[0:slice_index]
shuffled_half2 = shuffle_bucket[slice_index+1:]
Introducere în modelarea liniară în Python

Reesantionare și retestare

# Resample shuffled populations
shuffled_sample1 = np.random.choice(shuffled_half1, size=500, replace=True)
shuffled_sample2 = np.random.choice(shuffled_half2, size=500, replace=True)
# Recompute effect size
shuffled_test_statistic = shuffled_sample2 - shuffled_sample1
effect_size = np.mean(shuffled_test_statistic)
Introducere în modelarea liniară în Python

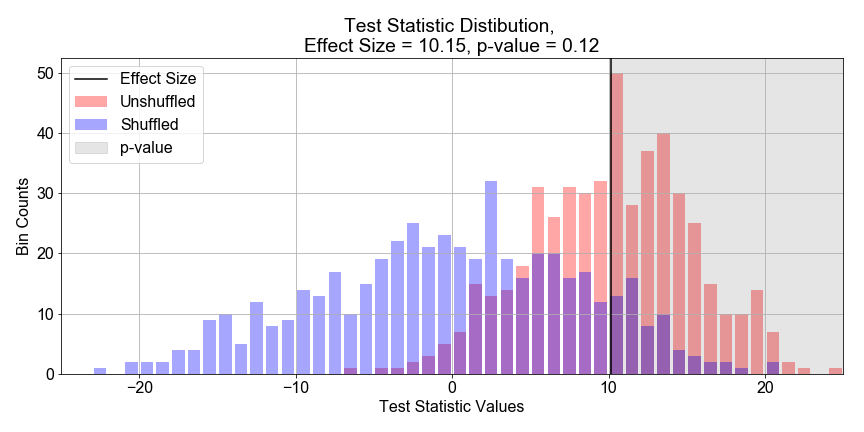
Valoarea p

Pe axe frecvențe față de valorile statisticii de test, două histograme: una albastră centrată pe x=0 cu dispersie largă, una roșie centrată pe x=10 cu dispersie mai îngustă, și o linie verticală neagră la x=10

Introducere în modelarea liniară în Python

Să exersăm!

Introducere în modelarea liniară în Python

Preparing Video For Download...