Criterii diferite de frecvență

Text Mining cu Bag-of-Words în R

Ted Kwartler

Instructor

Ponderarea termenilor
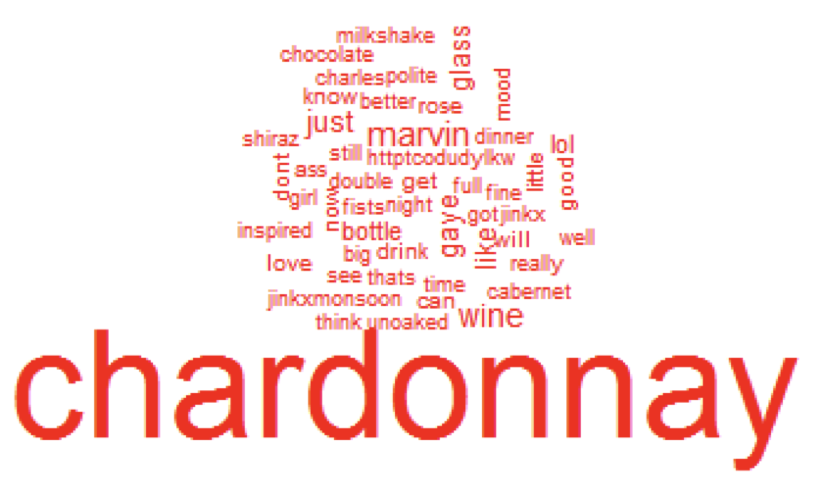
  • Frecvența implicită = număr simplu de cuvinte
  • Cuvintele frecvente pot masca informații relevante
  • Ajustați ponderarea prin TfIdf
  • Cuvintele din multe documente sunt penalizate

wordcloud2.png

Text Mining cu Bag-of-Words în R

Ponderarea termenilor

# Standard term weighting
tf_tdm <- TermDocumentMatrix(text_corp)
tf_tdm_m <- as.matrix(tf_dtm)
tf_tdm_m[505:510, 5:10]
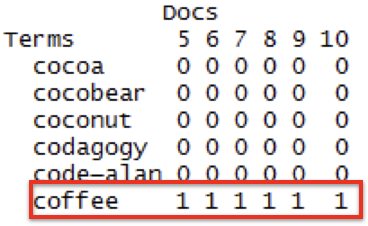
tdf.png

# TfIdf weighting
tf_idf_tdm <- TermDocumentMatrix(text_corp, 
    control = list(weighting = weightTfIdf))
tf_idf_tdm_m <- as.matrix(tf_idf_dtm)
tf_tdm_m <- as.matrix(tf_dtm)
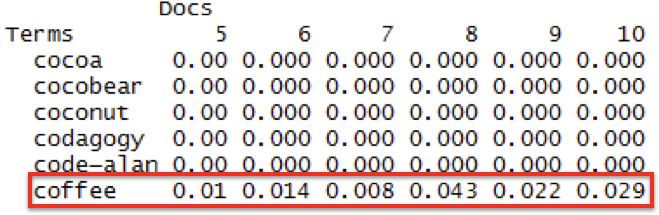
tfidf.png

Text Mining cu Bag-of-Words în R

Păstrarea metadatelor documentului

# Ensure the first 2 columns are doc_id & text
names(tweets)[1:2] <- c('doc_id','text')

# Create VCorpus including metadata
test_corpus <- VCorpus(DataframeSource(tweets))
# Clean and view results
text_corpus <- clean_corpus(text_corpus)
content(text_corpus[[1]])
$content
[1] "ayyytylerb true drink lots coffee"
meta(text_corpus[[1]])
$meta
  id      : 1
  author  : thejennagibson
  date    : 8/9/2013 2:43
  language: en
Text Mining cu Bag-of-Words în R

Să exersăm!

Text Mining cu Bag-of-Words în R

Preparing Video For Download...