Implementarea practică a algoritmului k-means

Segmentarea clienților în Python

Karolis Urbonas

Head of Data Science, Amazon

Pași principali

  • Preprocesarea datelor
  • Alegerea numărului de clustere
  • Rularea k-means pe datele preprocesate
  • Analiza valorilor medii RFM ale fiecărui cluster
Segmentarea clienților în Python

Preprocesarea datelor

Am finalizat preprocesarea și avem aceste două obiecte:

  • datamart_rfm
  • datamart_normalized
import numpy as np
datamart_log = np.log(datamart_rfm)

from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
scaler.fit(datamart_log)

datamart_normalized = scaler.transform(datamart_log)
Segmentarea clienților în Python

Metode de determinare a numărului de clustere

  • Metode vizuale - criteriul cotului
  • Metode matematice - coeficientul silhouette
  • Experimentare și interpretare
Segmentarea clienților în Python

Rularea k-means

# Import package
from sklearn.cluster import KMeans
kmeans = KMeans(n_clusters=2, random_state=1)
# Compute k-means clustering on pre-processed data
kmeans.fit(datamart_normalized)
# Extract cluster labels from labels_ attribute
cluster_labels = kmeans.labels_
Segmentarea clienților în Python

Analiza valorilor medii RFM ale fiecărui cluster

# Create a cluster label column in the original DataFrame
datamart_rfm_k2 = datamart_rfm.assign(Cluster = cluster_labels)
# Calculate average RFM values and size for each cluster
datamart_rfm_k2.groupby(['Cluster']).agg({
    'Recency': 'mean',
    'Frequency': 'mean',
    'MonetaryValue': ['mean', 'count'],
}).round(0)
Segmentarea clienților în Python

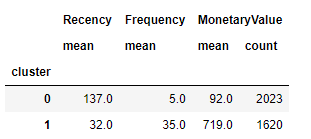
Analiza valorilor medii RFM ale fiecărui cluster

Rezultatul unei soluții simple cu 2 clustere:
Segmentarea clienților în Python

Să exersăm rularea algoritmului k-means!

Segmentarea clienților în Python

Preparing Video For Download...