Recunoașterea vorbirii și generarea audio

Modele Multi-Modale cu Hugging Face

James Chapman

Curriculum Manager, DataCamp

Vorbirea
 

Care sunt elementele importante ale formelor de undă vocală?

  • Tonalitate: frecv. medie pentru bărbați 85-180Hz, pentru femei 165-255Hz
  • Accentuare: specifică limbii, accentului și emoției
  • Ritm: influențat de context, emoție și limbă


Postare pe rețele sociale

Modele Multi-Modale cu Hugging Face

Recunoașterea automată a vorbirii

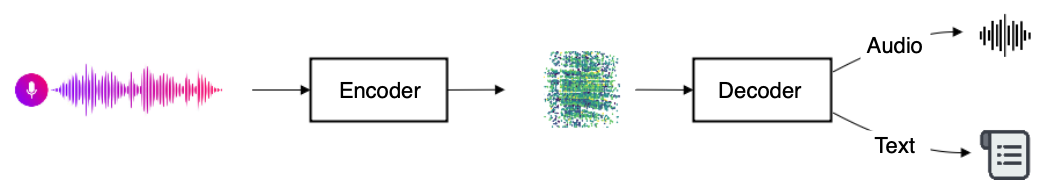
Sunetul este codificat, apoi decodificat în audio sau text.

  • Textul și sunetul sunt ambele secvențiale
  • Exemple: transcriere, traducere, text-to-speech
Modele Multi-Modale cu Hugging Face

Recunoașterea automată a vorbirii

  • Model mic: 39M parametri, dimensiune model 150MB
  • Date de antrenare: 680k ore (etichetate)
from transformers import WhisperProcessor, WhisperForConditionalGeneration
processor = WhisperProcessor.from_pretrained("openai/whisper-tiny")
model = WhisperForConditionalGeneration.from_pretrained("openai/whisper-tiny")
1 https://github.com/openai/whisper
Modele Multi-Modale cu Hugging Face

Recunoașterea automată a vorbirii

from datasets import load_dataset, Audio
dataset = load_dataset("CSTR-Edinburgh/vctk")["train"]
dataset = dataset.cast_column("audio", Audio(sampling_rate=16_000))

sample = dataset[0]["audio"]
input_preprocessed = processor(sample["array"], sampling_rate=sample["sampling_rate"], return_tensors="pt")
predicted_ids = model.generate(input_preprocessed.input_features)
transcription = processor.batch_decode(predicted_ids, skip_special_tokens=True) print(transcription)
['Please cool Stella.']
Modele Multi-Modale cu Hugging Face

Generarea audio

Trei componente pentru generarea audio:

  • Preprocesor: reeșantionare și extragere de caracteristici
  • Model: transformarea caracteristicilor
  • Vocoder: model generativ separat pentru forme de undă audio
from transformers import SpeechT5Processor, SpeechT5ForSpeechToSpeech, SpeechT5HifiGan

processor = SpeechT5Processor.from_pretrained("microsoft/speecht5_vc") model = SpeechT5ForSpeechToSpeech.from_pretrained("microsoft/speecht5_vc") vocoder = SpeechT5HifiGan.from_pretrained("microsoft/speecht5_hifigan")
Modele Multi-Modale cu Hugging Face

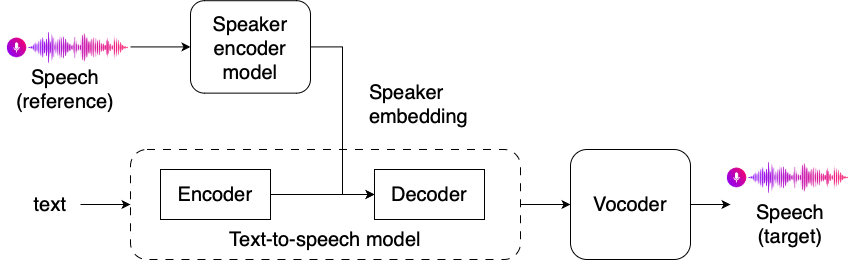
Embeddings vocale

Diagrama modului în care un embedding vocal se integrează într-un pipeline de generare a vorbirii

Modele Multi-Modale cu Hugging Face

Generarea embeddings-urilor vocale

  • Encoder pre-antrenat: tablou de formă de undă audio → tablou codificat (de regulă 512 dimensiuni)
from speechbrain.inference.speaker import EncoderClassifier
speaker_model = EncoderClassifier.from_hparams(source="speechbrain/spkrec-xvect-voxceleb")
speaker_embeddings = speaker_model.encode_batch(torch.tensor(dataset[0]["audio"]["array"]))

speaker_embeddings = torch.nn.functional.normalize(speaker_embeddings, dim=2).unsqueeze(0)
Modele Multi-Modale cu Hugging Face

Generarea audio

inputs = processor(audio=dataset[0]["audio"], 
                   sampling_rate=dataset[0]["audio"]["sampling_rate"], 
                   return_tensors="pt")


speech = model.generate_speech(inputs["input_values"], speaker_embedding, vocoder=vocoder)
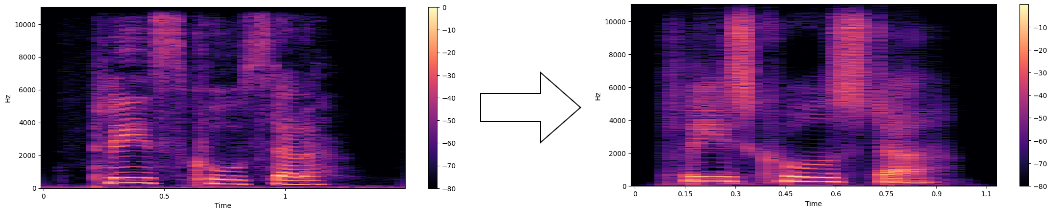
Spectrogram înainte și după

Modele Multi-Modale cu Hugging Face

Să exersăm!

Modele Multi-Modale cu Hugging Face

Preparing Video For Download...