Clasificare zero-shot a imaginilor

Modele Multi-Modale cu Hugging Face

James Chapman

Curriculum Manager, DataCamp

CLIP
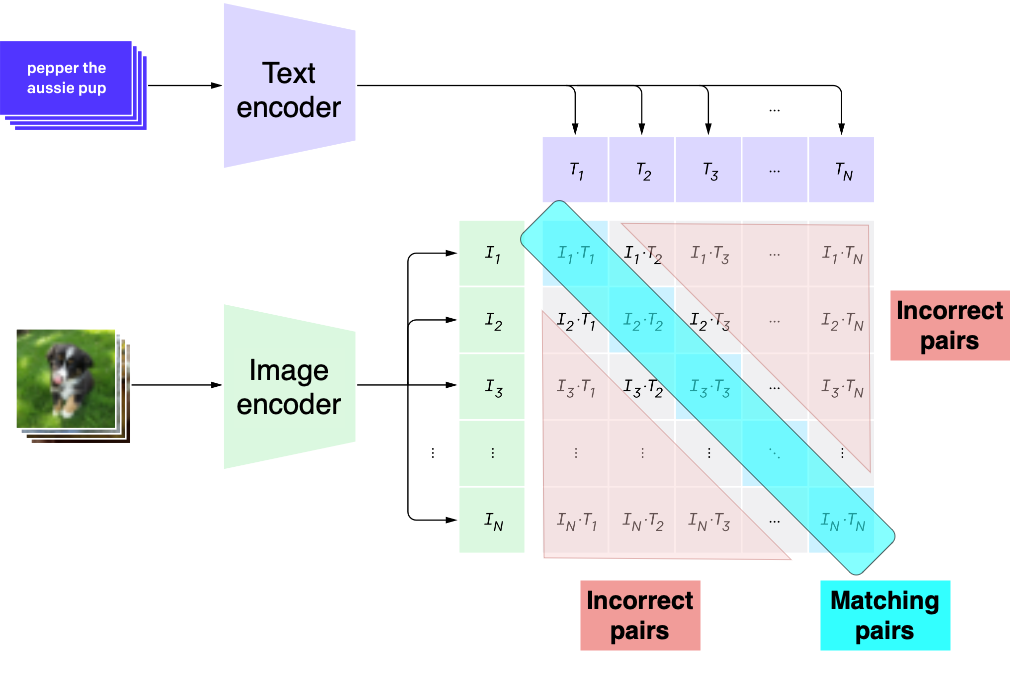
  • Contrastive Language-Image Pre-training
  • Calculează similaritatea dintre imagini și text
  • Antrenat pe 400M perechi imagine-text
  • Doi encoderi:
    • Encoder vizual
    • Encoder de text
  • Perechile imagine-text similare produc vectori apropiați

Diagramă de codificare text și imagine cu CLIP

1 https://openai.com/index/clip/
Modele Multi-Modale cu Hugging Face

Învățare zero-shot

  • Efectuarea de sarcini pentru care modelul nu a fost antrenat
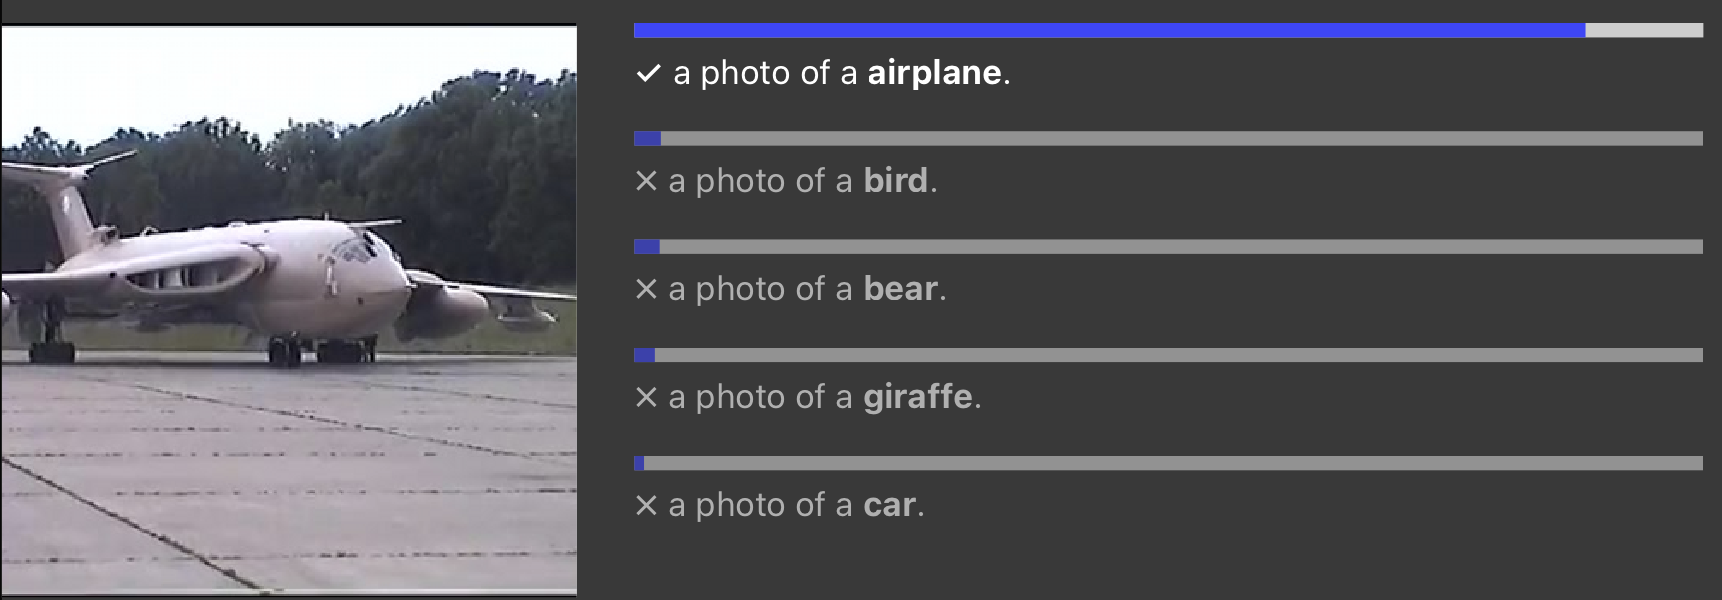
Clasificare zero-shot a unui avion

1 https://openai.com/index/clip/
Modele Multi-Modale cu Hugging Face

Caz de utilizare: categorizarea produselor
from datasets import load_dataset
import matplotlib.pyplot as plt

dset = "rajuptvs/ecommerce_products_clip"
dataset = load_dataset(dset)

print(dataset["train"][0]["Description"])
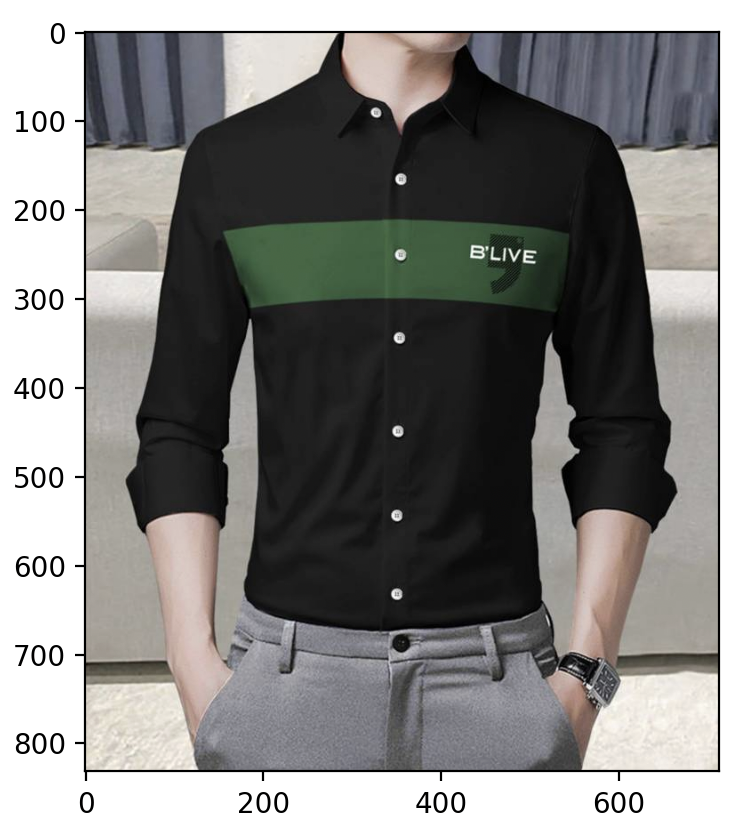
plt.imshow(dataset["train"][0]["image"]) plt.show()
Blive High quality premium Full sleeves printed 
Shirt direct from the manufacturers.Gives you 
a clean and classy look while also 
making you feel comfortable.Trusted 
brand online and no compromise on quality.

Imagine cu un tricou din set de date

Modele Multi-Modale cu Hugging Face

Învățare zero-shot cu CLIP

model = CLIPModel.from_pretrained("openai/clip-vit-base-patch32")
processor = CLIPProcessor.from_pretrained("openai/clip-vit-base-patch32")


categories = ["shirt", "trousers", "shoes", "dress", "hat", "bag", "watch"]
inputs = processor(text=categories, images=dataset["train"][0]["image"], return_tensors="pt", padding=True) outputs = model(**inputs)
probs = outputs.logits_per_image.softmax(dim=1)
categories[probs.argmax().item()]
shirt
Modele Multi-Modale cu Hugging Face

Scorul CLIP

  • Similaritatea dintre imaginea codificată și descrierea codificată
  • Interval de la 100 (acord perfect) la 0 (niciun acord)
from torchmetrics.functional.multimodal import clip_score


image = dataset["train"][0]["image"] description = dataset["train"][0]["Description"]
from torchvision.transforms import ToTensor image = ToTensor()(image)*255
score = clip_score(image, description, "openai/clip-vit-base-patch32")
print(f"CLIP score: {score}")
CLIP score: 28.495952606201172
Modele Multi-Modale cu Hugging Face

Să exersăm!

Modele Multi-Modale cu Hugging Face

Preparing Video For Download...