Preprocesarea diferitelor modalități

Modele Multi-Modale cu Hugging Face

James Chapman

Curriculum Manager, DataCamp

Preprocesarea textului
Un exemplu de șir de text.

  • Tokenizer: mapează text → intrare model
Modele Multi-Modale cu Hugging Face

Preprocesarea textului

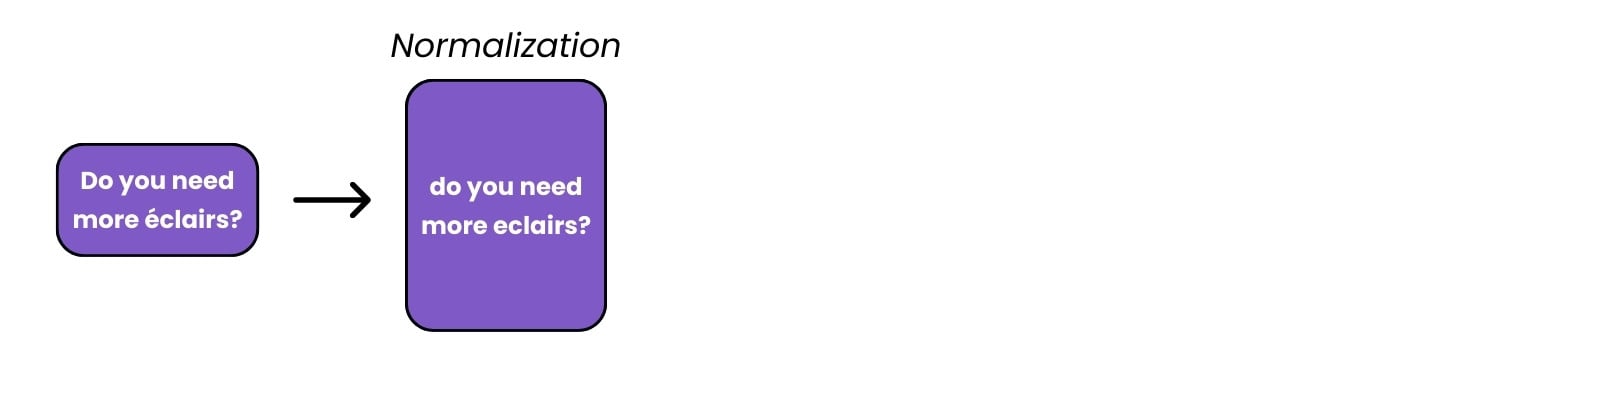
Diagramă flux a preprocesării textului până la normalizare

  • Tokenizer: mapează text → intrare model
    • Normalizare: litere mici, eliminarea caracterelor speciale, eliminarea spațiilor în plus
Modele Multi-Modale cu Hugging Face

Preprocesarea textului

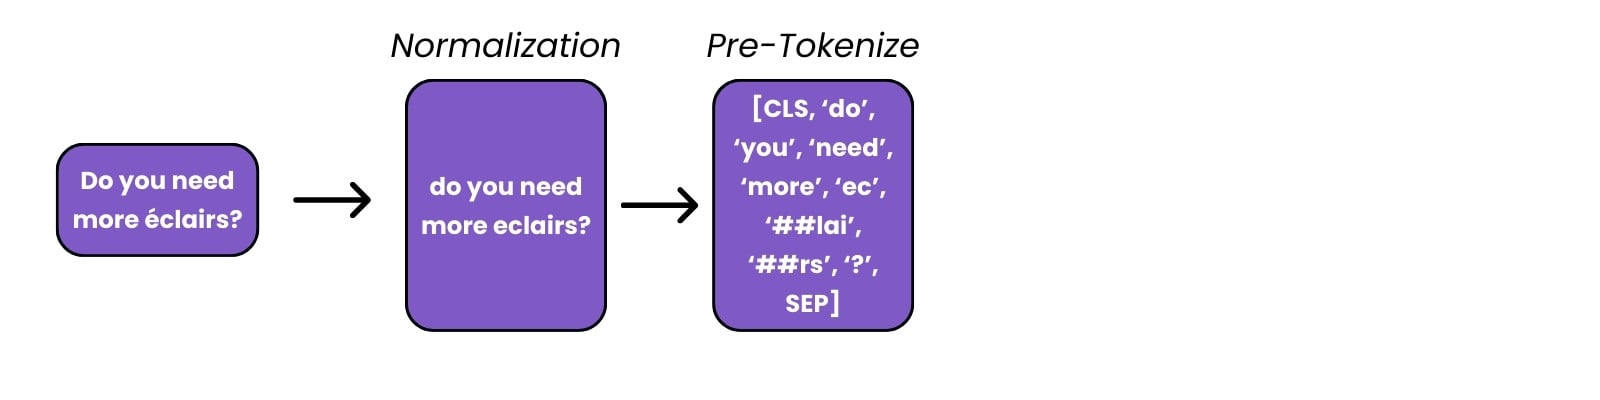
Continuarea diagramei flux până la tokenizare

  • Tokenizer: mapează text → intrare model
    • Normalizare: litere mici, eliminarea caracterelor speciale, eliminarea spațiilor în plus
    • (Pre-)tokenizare: împărțirea textului în cuvinte/subcuvinte
Modele Multi-Modale cu Hugging Face

Preprocesarea textului

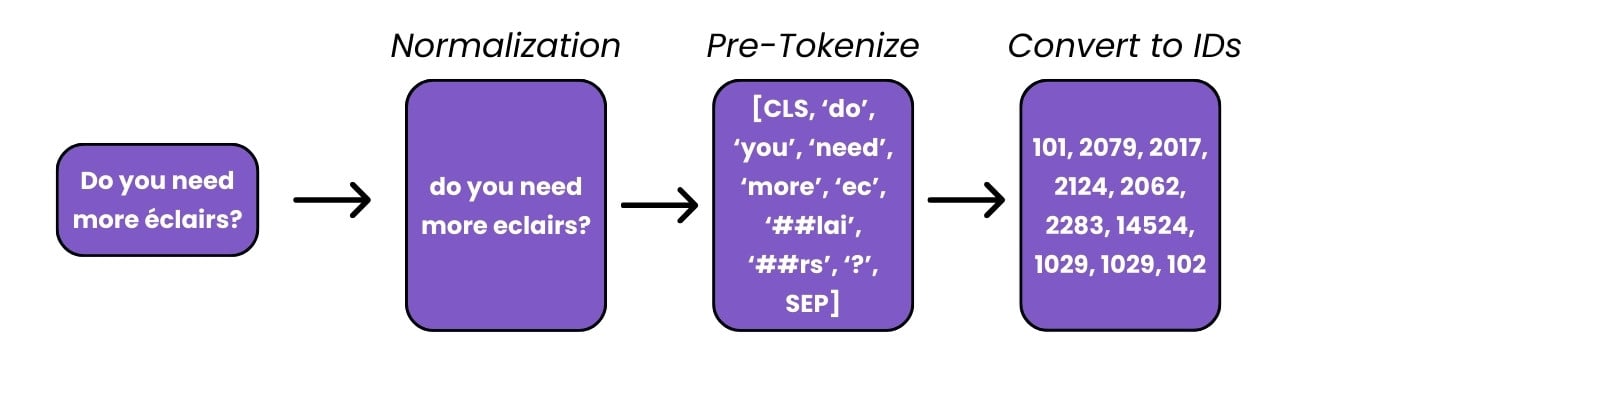
Continuarea diagramei flux până la conversia în ID și padding

  • Tokenizer: mapează text → intrare model
    • Normalizare: litere mici, eliminarea caracterelor speciale, spații
    • (Pre-)tokenizare: împărțirea textului în cuvinte/subcuvinte
    • Conversie ID: maparea tokenilor la numere întregi printr-un vocabular
Modele Multi-Modale cu Hugging Face

Preprocesarea textului

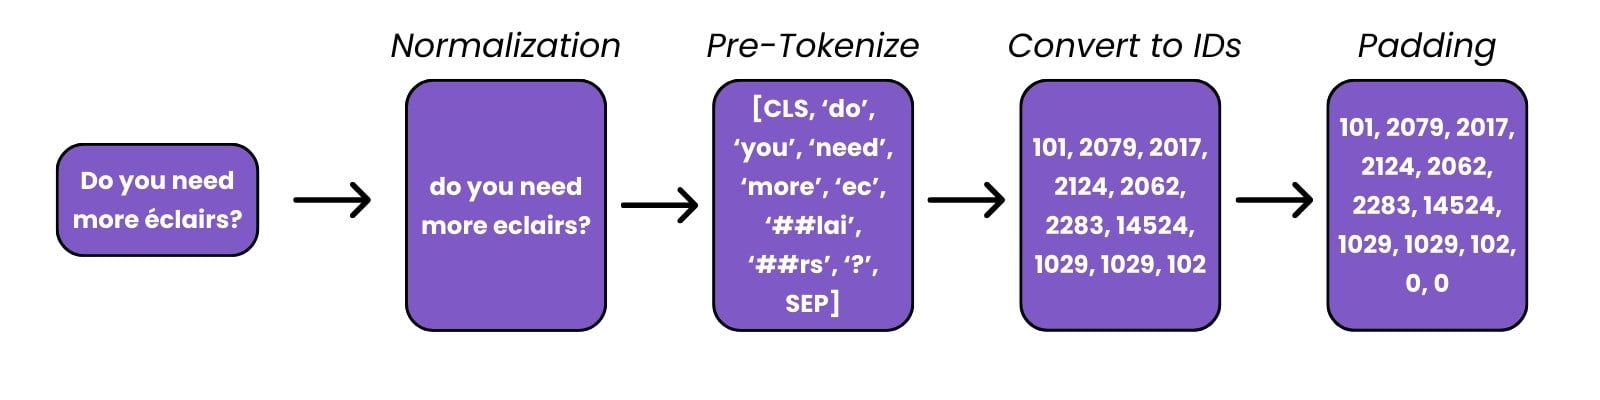
preprocessing_text5.jpg

  • Tokenizer: mapează text → intrare model
    • Normalizare: litere mici, eliminarea caracterelor speciale, spații
    • (Pre-)tokenizare: împărțirea textului în cuvinte/subcuvinte
    • Conversie ID: maparea tokenilor la numere întregi printr-un vocabular
    • Padding: adăugarea de tokeni suplimentari pentru lungime uniformă
Modele Multi-Modale cu Hugging Face

Preprocesarea textului

from transformers import AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained('distilbert/distilbert-base-uncased')

text = "Do you need more éclairs?"
print(tokenizer.backend_tokenizer.normalizer.normalize_str(text))
do you need more eclairs
tokenizer(text, return_tensors='pt', padding=True)
{'input_ids': tensor([[  101,  ..., 102]]), ...}
Modele Multi-Modale cu Hugging Face

Preprocesarea imaginilor

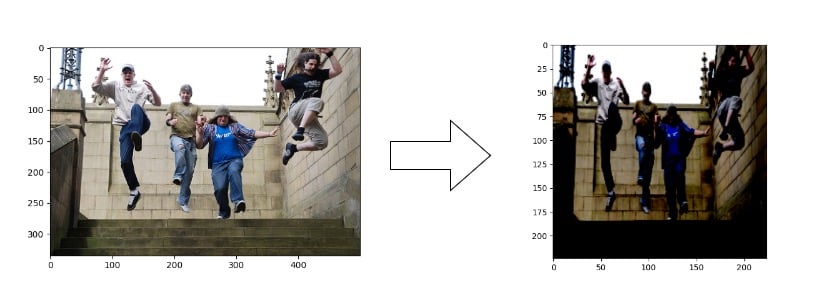
  • Normalizare: actualizarea intensității pixelilor
  • Redimensionare: potrivire cu stratul de intrare al modelului
  • Regulă generală → utilizați preprocesarea modelului original

imagini ale unui grup de persoane sărind, înainte și după preprocesarea imaginii

1 https://huggingface.co/datasets/nlphuji/flickr30k
Modele Multi-Modale cu Hugging Face

Preprocesarea imaginilor

Sarcinile multimodale necesită preprocesare consecventă:

from transformers import BlipProcessor, BlipForConditionalGeneration

checkpoint = "Salesforce/blip-image-captioning-base"
model = BlipForConditionalGeneration.from_pretrained(checkpoint) processor = BlipProcessor.from_pretrained(checkpoint)

Codează imaginea → transformă în codificare text → decodează textul

image = load_dataset("nlphuji/flickr30k")['test'][11]["image"]
inputs = processor(images=image, return_tensors="pt")

output = model.generate(**inputs)
print(processor.decode(output[0]))
[{'generated_text': 'a group of people jumping'}]
Modele Multi-Modale cu Hugging Face

Preprocesarea audio

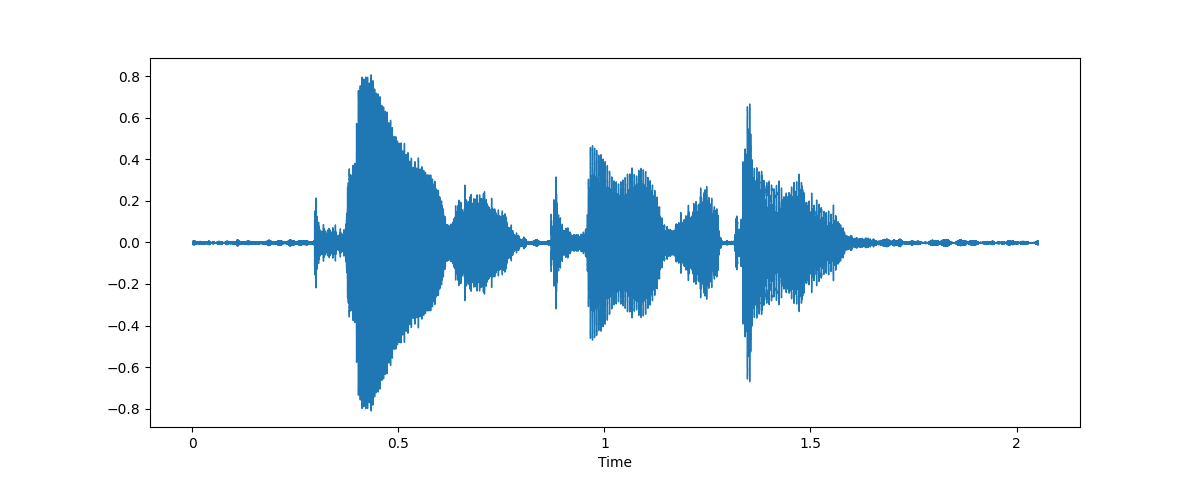
Spectru audio

  • Preprocesarea audio:
    • Array secvențial → filtrare/padding
    • Frecvență de eșantionare → reeșantionare

Extragerea caracteristicilor ca intrare model (spectrogramă)
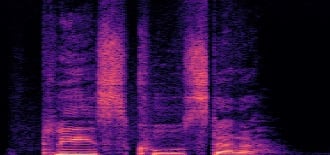
spectro

Modele Multi-Modale cu Hugging Face

Preprocesarea audio

from datasets import load_dataset, Audio

dataset = load_dataset("CSTR-Edinburgh/vctk")["train"] dataset = dataset.cast_column("audio", Audio(sampling_rate=16_000))
  • Preprocesoarele complete specifice modelului ar trebui să fie disponibile:
from transformers import AutoProcessor
processor = AutoProcessor.from_pretrained("openai/whisper-small")
audio_pp = processor(dataset[0]["audio"]["array"], 
                     sampling_rate=16_000, return_tensors="pt")
  • Frecvența de eșantionare trebuie să corespundă cerințelor modelului
1 https://huggingface.co/datasets/CSTR-Edinburgh/vctk
Modele Multi-Modale cu Hugging Face

Să exersăm!

Modele Multi-Modale cu Hugging Face

Preparing Video For Download...