Pipeline-uri de învățare supervizată
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Dr. Chris Anagnostopoulos
Honorary Associate Professor
Date etichetate
- Variabile caracteristici (prescurtat:
X) - Etichete sau clasă (prescurtat:
y)
credit_scoring.head(4)
  checking_status  duration  ...  foreign_worker class
0            '<0'         6  ...             yes  good
1      '0<=X<200'        48  ...             yes   bad
2   'no checking'        12  ...             yes  good
3            '<0'        42  ...             yes  good
Ingineria caracteristicilor
- Majoritatea clasificatorilor necesită caracteristici numerice
- Coloanele text trebuie convertite în numere
Preprocesat cu LabelEncoder din sklearn.preprocessing:
le = LabelEncoder()
le.fit_transform(credit_scoring['checking_status'])[:4]
array([1, 0, 3, 1])
Antrenarea modelului
.fit(features, labels).predict(features)
features, labels = credit_scoring.drop('class', 1), credit_scoring['class']model_nb = GaussianNB() model_nb.fit(features, labels) model_nb.predict(features.head(5))
['good' 'bad' 'good' 'bad' 'good']
Acuratețe de 60% pe primele 5 exemple.
Selecția modelului
.fit()optimizează parametrii modelului dat- Ce alte modele pot fi folosite?
AdaBoostClassifier depășește GaussianNB pe primele cinci puncte de date:
model_ab = AdaBoostClassifier()
model_ab.fit(features, labels)
model_ab.predict(features.head(5))
numpy.array(labels[0:5])
['good' 'bad' 'good' 'good' 'bad']
['good' 'bad' 'good' 'good' 'bad']
Evaluarea performanței
Eșantioane mai mari $\Rightarrow$ estimări mai precise ale acurateței:
from sklearn.metrics import accuracy_score
accuracy_score(labels, model_nb.predict(features)) # naive bayes
0.706
accuracy_score(labels, model_ab.predict(features)) # adaboost
0.802
Ce este greșit în acest calcul?
Supraajustare și împărțirea datelor
Supraajustare: un model va performa întotdeauna mai bine pe datele de antrenament decât pe date noi.
Antrenare pe X_train, y_train, evaluare pe X_test, y_test:
from sklearn.model_selection import train_test_split X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)GaussianNB().fit(X_train, y_train).predict(X_test)
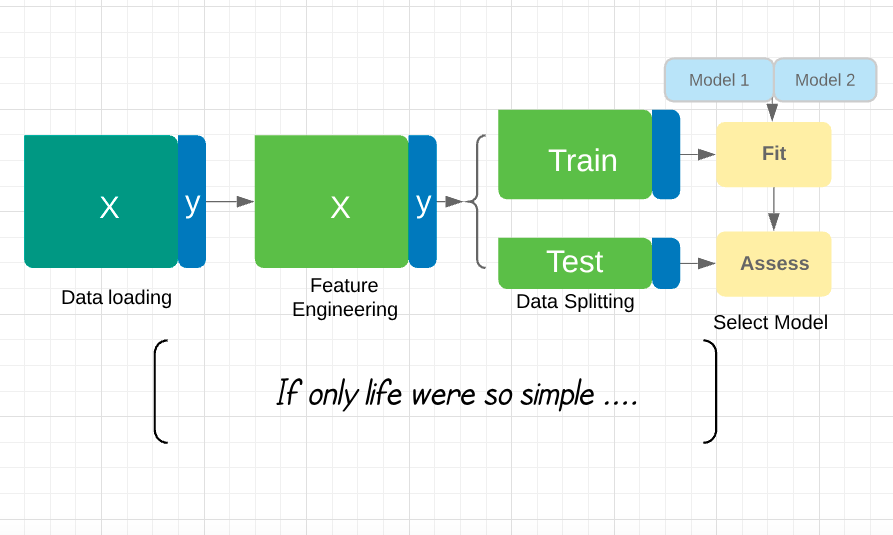
Despre ce este acest curs?
- Metode scalabile de ajustare a pipeline-ului.
- Asigurarea relevanței predicțiilor prin implicarea experților din domeniu.
- Menținerea performanței modelului în timp.
- Antrenarea modelelor când nu există suficiente etichete.
Ați fi putut preveni criza creditelor ipotecare?
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

