Ingineria caracteristicilor și supraajustarea

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Dr. Chris Anagnostopoulos

Honorary Associate Professor

Extragerea caracteristicilor din date non-tabulare
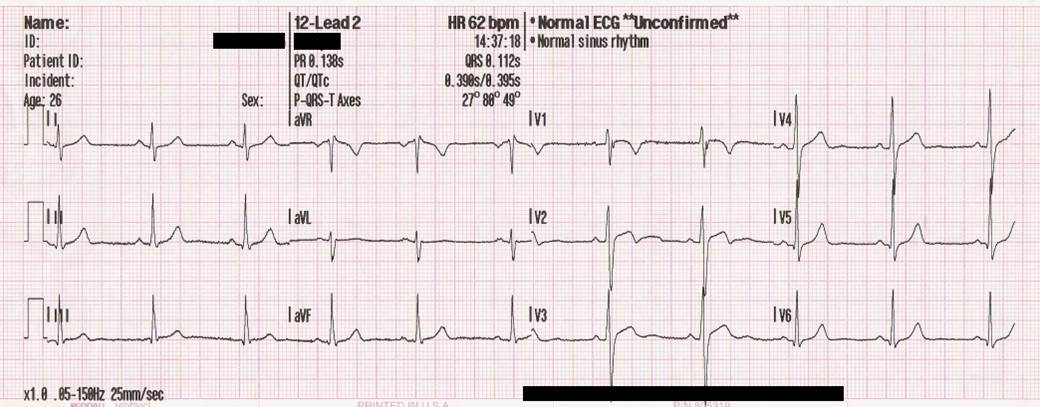
ECG-ul unui pacient este înregistrat de obicei pe hârtie ca serie temporală.

arrhythmias.head()
   age  sex  height  weight  ...    chV6_TwaveAmp  chV6_QRSA  chV6_QRSTA  class
0   75    0     190      80  ...              2.9       23.3        49.4      0
1   56    1     165      64  ...              2.1       20.4        38.8      0
2   54    0     172      95  ...              3.4       12.3        49.0      0
3   55    0     175      94  ...              2.6       34.6        61.6      1
4   75    0     190      80  ...              3.9       25.4        62.8      0
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Codificarea etichetelor pentru variabile categorice
numpy.unique(credit_scoring['purpose'])
array(['business', 'buy_domestic_appliance', 'buy_furniture_equipment',
       'buy_new_car', 'buy_radio_tv', 'buy_used_car', 'education',
       'other', 'repairs', 'retraining'], dtype=object)
numpy.unique(LabelEncoder().fit_transform(credit_scoring['purpose']))
array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9])
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Codificarea etichetelor pentru variabile categorice
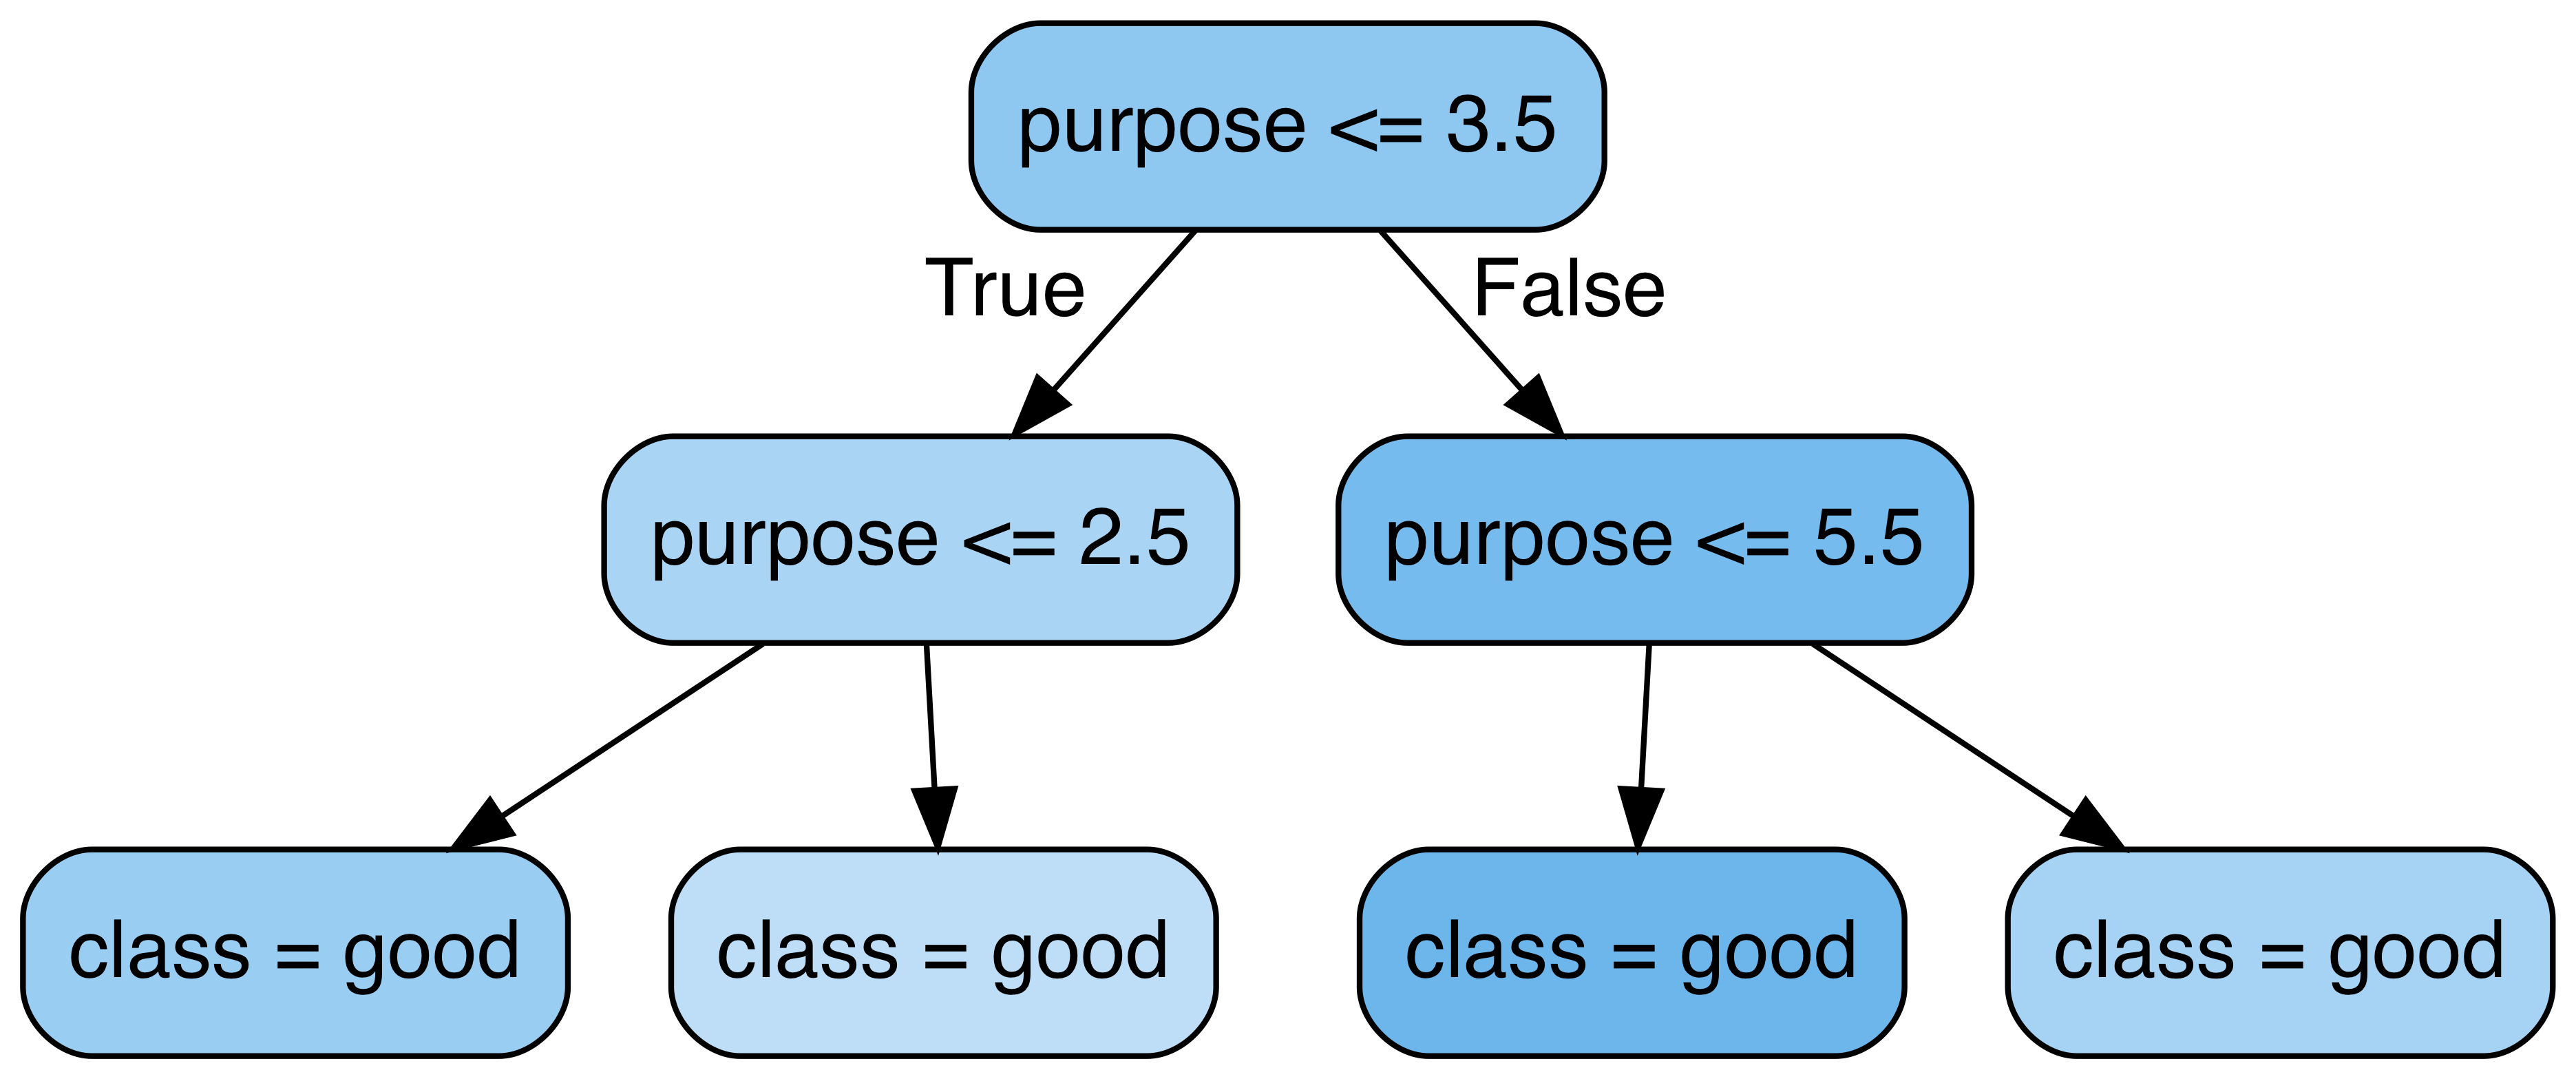
Un arbore de decizie care împarte variabila scop din credit în intervale continue arbitrare de numere, unde numerele codifică categoria subiacentă.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Codificarea one-hot pentru variabile categorice

pd.get_dummies(credit_scoring['purpose']).iloc[1]
purpose_business                   0
purpose_buy_domestic_appliance     0
purpose_buy_furniture_equipment    0
purpose_buy_new_car                0
purpose_buy_radio_tv               1
purpose_buy_used_car               0
purpose_education                  0
purpose_other                      0
purpose_repairs                    0
purpose_retraining                 0
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Codificarea cuvintelor cheie pentru variabile categorice

from sklearn.feature_extraction.text import CountVectorizer
vec = CountVectorizer()

credit_scoring['purpose'] = credit_scoring['purpose'].apply( lambda s: ' '.join(s.split('_')), 0)
dummy_matrix = vec.fit_transform(credit_scoring['purpose']).toarray()
pd.DataFrame(dummy_matrix, columns=vec.get_feature_names()).head()
      appliance  business  buy  car  ...   repairs  retraining  tv  used
0          0         0    1    0  ...         0           0   1     0
1          0         0    1    0  ...         0           0   1     0
2          0         0    0    0  ...         0           0   0     0
3          0         0    1    0  ...         0           0   0     0
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Dimensionalitate și ingineria caracteristicilor

Variabile categorice în credit:

  • Codificare etichetă: 1 coloană.
  • Codificare one-hot: 10 coloane.
  • Codificare cuvinte cheie: 15 coloane.

Caracteristici ECG în arrhythmias:

  • Peste 250 de caracteristici
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

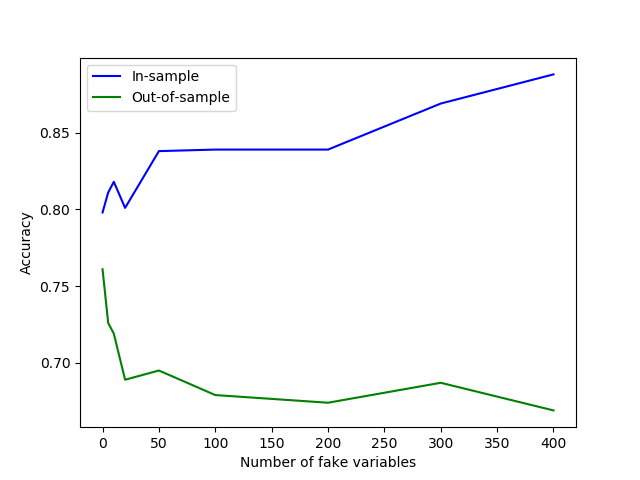
Acuratețea pe eșantionul de antrenament este de 0,8 la 0 coloane adăugate și crește aproape până la 1,0 pe măsură ce adăugăm coloane false. Acuratețea pe eșantionul de test scade imediat ce sunt adăugate coloane false.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Selecția caracteristicilor

from np.random import uniform
fakes = pd.DataFrame(
    uniform(low=0.0, high=1.0, size=n * 100).reshape(X.shape[0], 100),
    columns=['fake_' + str(j) for j in range(100)]
)
X_with_fakes = pd.concat([X, fakes], 1)
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Selecția caracteristicilor

from sklearn.feature_selection import chi2, SelectKBest
sk = SelectKBest(chi2, k=20)
which_selected = sk.fit(X_with_fakes, y).get_support()
X_with_fakes.columns[which_selected]
['checking_status', 'duration', 'credit_history', 'purpose',
    'credit_amount', 'savings_status', 'installment_commitment',
    'personal_status', 'property_magnitude', 'age', 'other_payment_plans',
    'job', 'own_telephone', 'fake_28', 'fake_46', 'fake_51', 'fake_60',
    'fake_83', 'fake_95', 'fake_99']
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Compromisuri la tot pasul!

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Preparing Video For Download...