Funcții de pierdere Partea I

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Dr. Chris Anagnostopoulos

Honorary Associate Professor

Setul de date KDD '99 Cup

kdd.iloc[0]
kdd.iloc[0]
duration                         51
protocol_type                   tcp
service                        smtp
flag                             SF
src_bytes                      1169
dst_bytes                       332
land                              0
...
dst_host_rerror_rate              0
dst_host_srv_rerror_rate          0
label                          good
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Fals pozitive vs. fals negative

Binarizați eticheta:

kdd['label'] = kdd['label'] == 'bad'

Antrenați un clasificator Gaussian Naive Bayes:

clf = GaussianNB().fit(X_train, y_train)
predictions = clf.predict(X_test)
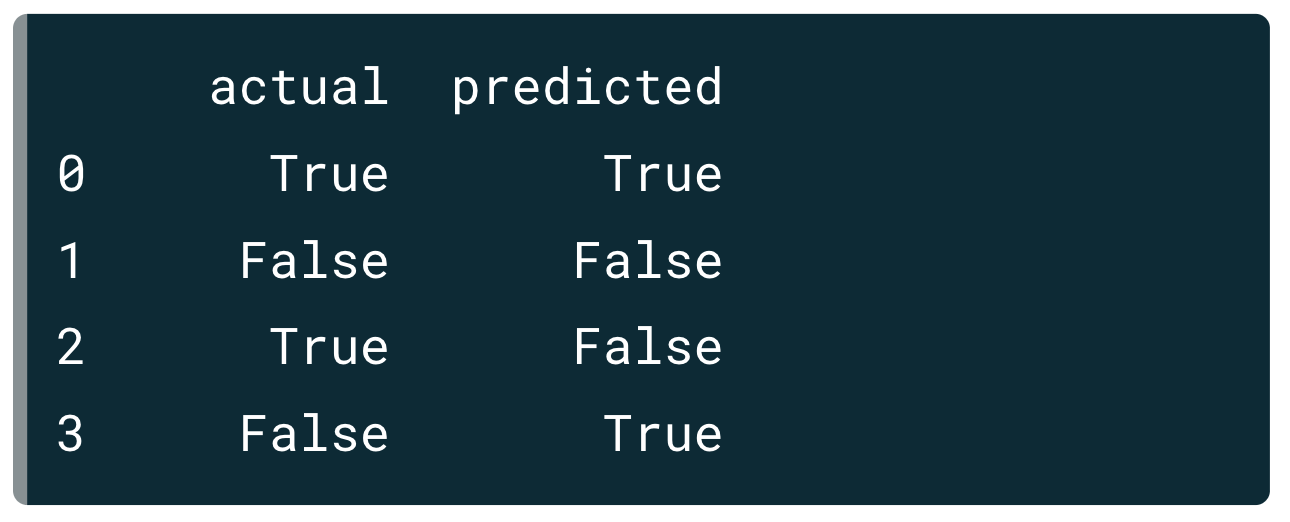
results = pd.DataFrame({
    'actual': y_test,
    'predicted': predictions
})

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Fals pozitive vs. fals negative

Binarizați eticheta:

kdd['label'] = kdd['label'] == 'bad'

Antrenați un clasificator Gaussian Naive Bayes:

clf = GaussianNB().fit(X_train, y_train)
predictions = clf.predict(X_test)
results = pd.DataFrame({
    'actual': y_test,
    'predicted': predictions
})

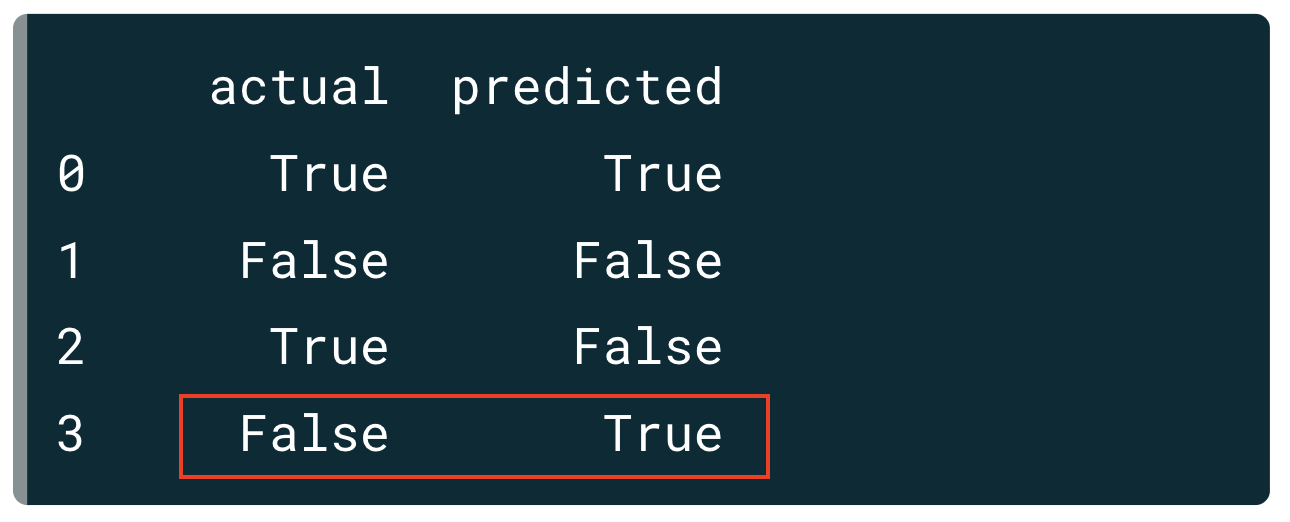
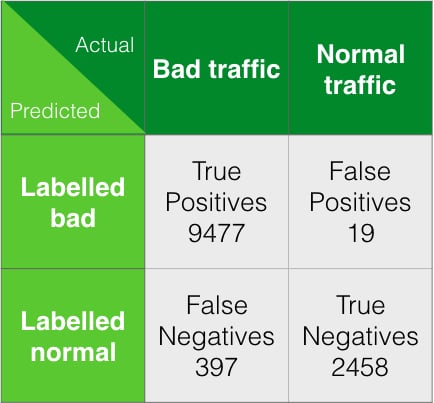
Există patru configurații posibile ale etichetelor față de predicții: ambele True, ambele False, etichetă True cu predicție False și etichetă False cu predicție True. Ultima combinație este evidențiată aici.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Fals pozitive vs. fals negative

Binarizați eticheta:

kdd['label'] = kdd['label'] == 'bad'

Antrenați un clasificator Gaussian Naive Bayes:

clf = GaussianNB().fit(X_train, y_train)
predictions = clf.predict(X_test)
results = pd.DataFrame({
    'actual': y_test,
    'predicted': predictions
})

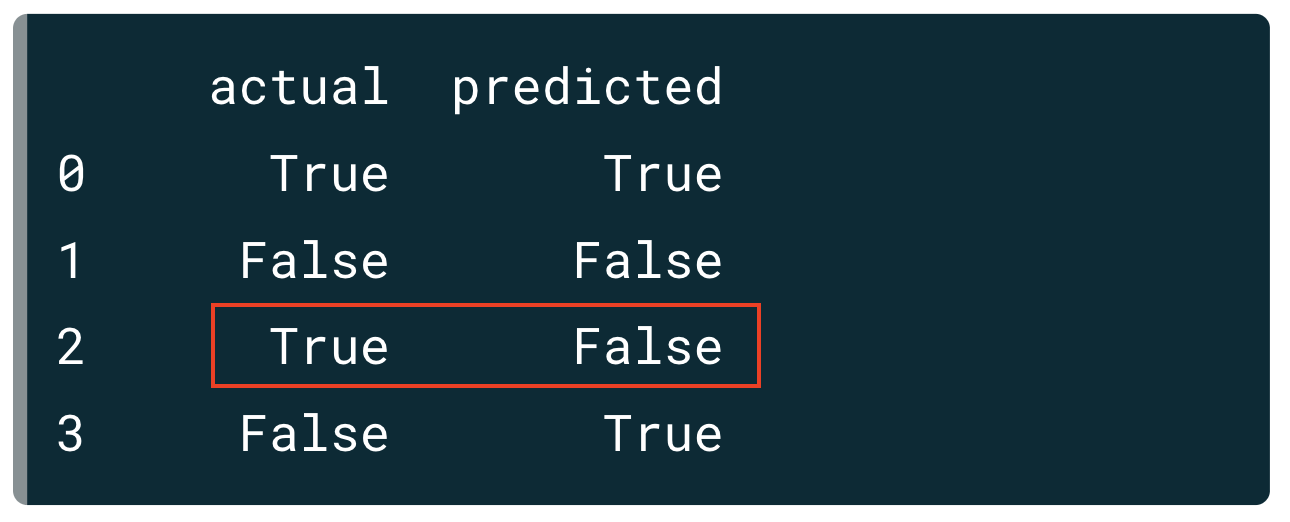
Acum este evidențiată combinația etichetei True cu predicția False.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Fals pozitive vs. fals negative

Binarizați eticheta:

kdd['label'] = kdd['label'] == 'bad'

Antrenați un clasificator Gaussian Naive Bayes:

clf = GaussianNB().fit(X_train, y_train)
predictions = clf.predict(X_test)
results = pd.DataFrame({
    'actual': y_test,
    'predicted': predictions
})

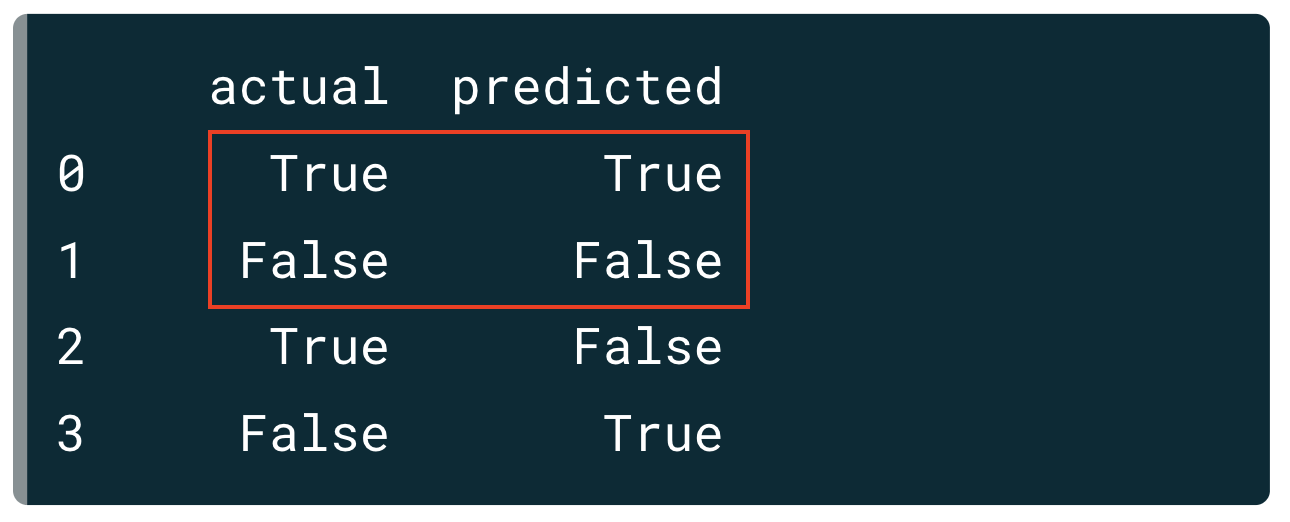
Sunt evidențiate acum cele două cazuri în care predicția coincide cu etichetele.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Matricea de confuzie

conf_mat = confusion_matrix(
    ground_truth, predictions)
array([[9477,   19],
       [ 397, 2458]])
tn, fp, fn, tp = conf_mat.ravel()
(fp, fn)
(19, 397)

O matrice de confuzie care numără cazurile pentru fiecare dintre cele patru combinații menționate anterior pentru acest set de date.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Metrici scalare de performanță

accuracy = 1-(fp + fn)/len(ground_truth)

recall = tp/(tp+fn)
fpr = fp/(tn+fp)
precision = tp/(tp+fp)
f1 = 2*(precision*recall)/(precision+recall)
accuracy_score(ground_truth, predictions)
recall_score(ground_truth, predictions)
precision_score(ground_truth, predictions)
f1_score(ground_truth, predictions)
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Fals pozitive vs. fals negative

Clasificatorul A:

tn, fp, fn, tp = confusion_matrix(
    ground_truth, predictions_A).ravel()
(fp,fn)
(3, 3)
cost = 10 * fp + fn
33

Clasificatorul B:

tn, fp, fn, tp = confusion_matrix(
    ground_truth, predictions_B).ravel()
(fp,fn)
(0, 26)

cost = 10 * fp + fn
26
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Care clasificator este mai bun?

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Preparing Video For Download...