Implementarea modelului

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Dr. Chris Anagnostopoulos

Honorary Associate Professor
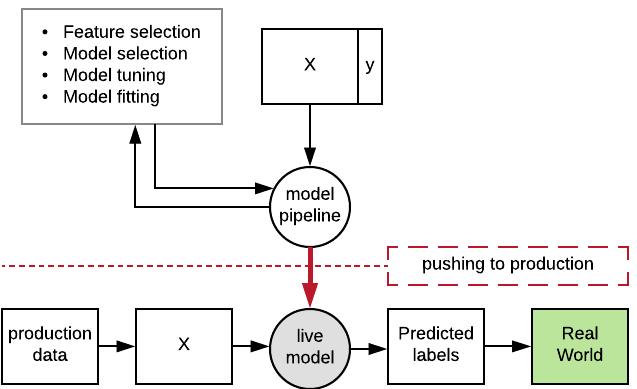
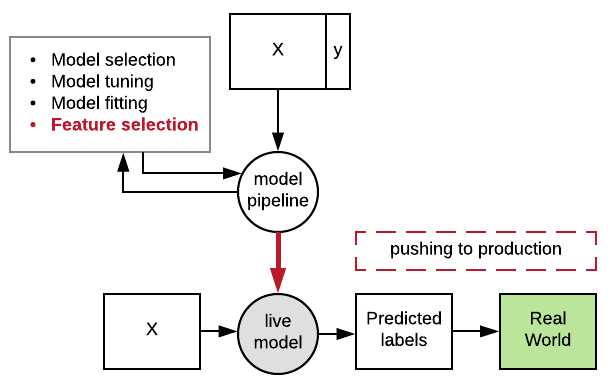
Un obiect pipeline de model care conține selecția caracteristicilor, selecția modelului, ajustarea și antrenarea acestuia este transferat într-un pipeline de producție care folosește pipeline-ul antrenat pentru predicții.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Serializarea modelului

Salvarea unui clasificator în fișier:

import pickle
clf = RandomForestClassifier().fit(X_train, y_train)
with open('model.pkl', 'wb') as file:
    pickle.dump(clf, file=file)

Încărcarea din fișier:

with open('model.pkl', 'rb') as file:
    clf2 = pickle.load(file)
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Serializarea pipeline-ului

Mediul de dezvoltare:

vt = SelectKBest(f_classif).fit(
    X_train, y_train)
clf = RandomForestClassifier().fit(
    vt.transform(X_train), y_train)
with open('vt.pkl', 'wb') as file: 
     pickle.dump(vt)
with open('clf.pkl', 'wb') as file: 
     pickle.dump(clf)

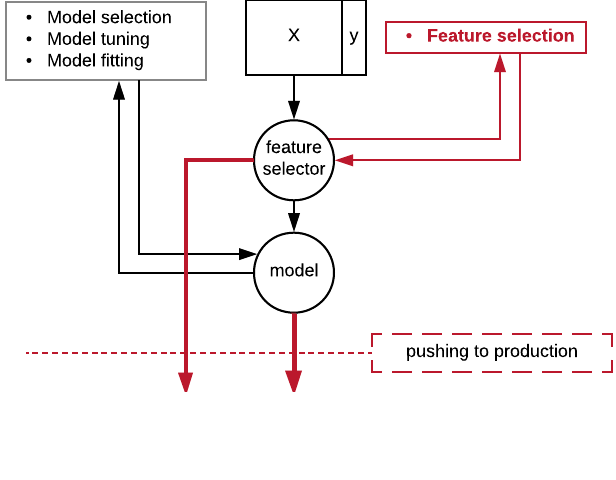
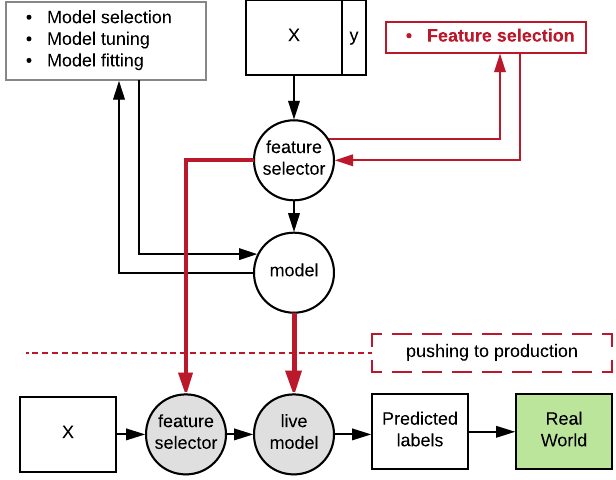
Un flux de lucru în care obiectul de selecție a caracteristicilor și modelul antrenat trebuie transferate separat în producție.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Serializarea pipeline-ului

Mediul de producție:

with open('vt.pkl', 'rb') as file: 
    vt = pickle.load(vt)
with open('clf.pkl', 'rb') as file: 
    clf = pickle.load(clf)
clf.predict(vt.transform(X_new))

Un flux de lucru în care obiectul de selecție a caracteristicilor și modelul antrenat trebuie transferate separat în producție.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Serializarea pipeline-ului

Mediul de dezvoltare:

pipe = Pipeline([
    ('fs', SelectKBest(f_classif)), 
    ('clf', RandomForestClassifier())
])
params = dict(fs__k=[2, 3, 4],
    clf__max_depth=[5, 10, 20])
gs = GridSearchCV(pipe, params)
gs = gs.fit(X_train, y_train)

with open('pipe.pkl', 'wb') as file: pickle.dump(gs, file)

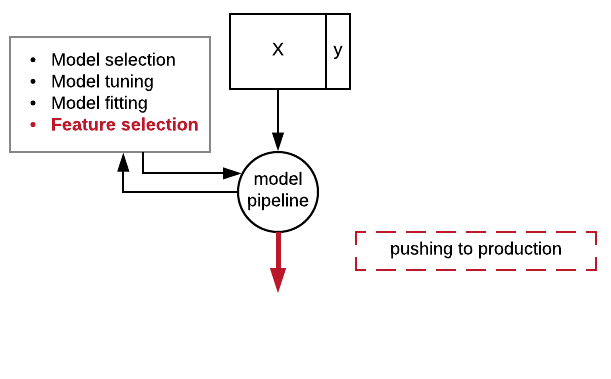
Un flux de lucru optimizat în care atât selecția caracteristicilor, cât și antrenarea modelului sunt conținute într-un singur obiect pipeline.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Serializarea pipeline-ului

Mediul de producție:

with open('pipe.pkl', 'rb') as file:
   gs = pickle.dump(gs, file)
gs.predict(X_test)

Un flux de lucru optimizat în care atât selecția caracteristicilor, cât și antrenarea modelului sunt conținute într-un singur obiect pipeline.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Transformări personalizate ale caracteristicilor

   checking_status  duration       ...        own_telephone  foreign_worker
0                1         6       ...                    1               1
1                0        48       ...                    0               1
def negate_second_column(X):
    Z = X.copy()
    Z[:,1] = -Z[:,1]
    return Z
pipe = Pipeline([('ft', FunctionTransformer(negate_second_column)), 
    ('clf', RandomForestClassifier())])
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Pregătit pentru producție!

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Preparing Video For Download...