Fuziunea datelor

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Dr. Chris Anagnostopoulos

Honorary Associate Professor

Calculatoare, porturi și protocoale
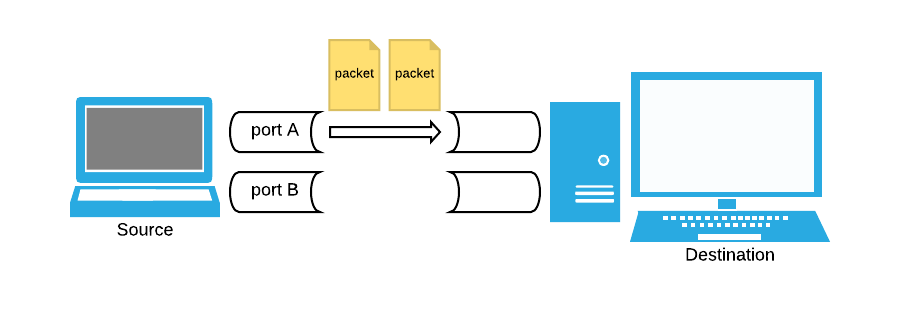
Traficul de rețea este transmis în pachete de pe un port al calculatorului sursă către un port al calculatorului destinație.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Setul de date LANL cyber

flows: Fluxurile sunt sesiuni de transfer continuu de date între un port al calculatorului sursă și un port al calculatorului destinație, urmând un anumit protocol.

flows.iloc[1]
time                    471692
duration                     0
source_computer          C5808
source_port              N2414
destination_computer    C26871
destination_port        N19148
protocol                     6
packet_count                 1
byte_count                  60
1 https://csr.lanl.gov/data/cyber1/
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Setul de date LANL cyber

attack: informații despre anumite atacuri efectuate de echipa de securitate în cadrul unui test.

attacks.head()
     time user@domain source_computer destination_computer
0  151036   U748@DOM1          C17693                 C305
1  151648   U748@DOM1          C17693                 C728
2  151993  U6115@DOM1          C17693                C1173
3  153792   U636@DOM1          C17693                 C294
4  155219   U748@DOM1          C17693                C5693

Cum putem construi exemple etichetate din aceste date?

1 https://csr.lanl.gov/data/cyber1/
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Etichetarea evenimentelor versus etichetarea calculatoarelor

Un singur eveniment nu poate fi etichetat cu ușurință. O singură tranzacție între o sursă infectată și un calculator destinație.
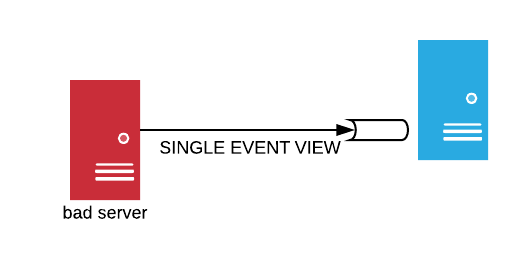
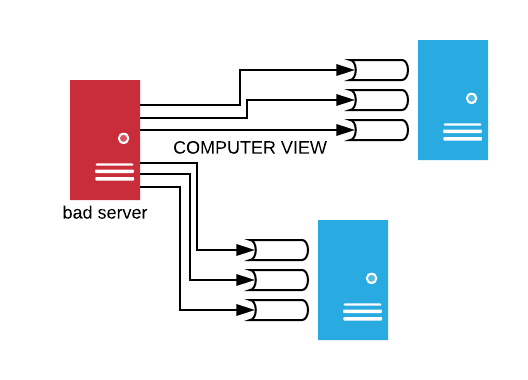
Însă un calculator în ansamblu este fie infectat, fie nu. O sursă infectată încearcă să comunice cu toate porturile posibile ale două calculatoare diferite.
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Grupare și extragere de caracteristici

Unitate de analiză = destination_computer

flows_grouped = flows.groupby('destination_computer')

list(flows_grouped)[0]
('C10047',         
        time  duration    ...     packet_count byte_count
2791  471694         0    ...               12       6988
2792  471694         0    ...                1        193
...
2846  471694        38    ...              157      84120
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Grupare și extragere de caracteristici

De la un DataFrame per calculator, la un vector de caracteristici per calculator.

def featurize(df):
    return {
        'unique_ports': len(set(df['destination_port'])),
        'average_packet': np.mean(df['packet_count']),
        'average_duration': np.mean(df['duration'])
    }
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Grupare și extragere de caracteristici

out = flows.groupby('destination_computer').apply(featurize)
X = pd.DataFrame(list(out), index=out.index)

X.head()
                      average_duration      ...       unique_ports
destination_computer                        ...                   
C10047                        7.538462      ...                 13
C10054                        0.000000      ...                  1
C10131                       55.000000      ...                  1
...
[5 rows x 3 columns]
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Set de date etichetat

bads = set(attacks['source_computer'].append(attacks['destination_computer']))
y = [x in bads for x in X.index]

Perechea (X, y) reprezintă acum un set de date de clasificare etichetat standard.

X_train, X_test, y_train, y_test = train_test_split(X, y)
clf = AdaBoostClassifier()
accuracy_score(y_test, clf.fit(X_train, y_train).predict(X_test))
0.92
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Gata să prindeți un hacker?

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Preparing Video For Download...