Etichete, etichete slabe și adevăr

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Dr. Chris Anagnostopoulos

Honorary Associate Professor

Etichetele nu sunt întotdeauna perfecte

Grade de certitudine:

  • Adevăr de referință
    • calculatorul se blochează și apare un mesaj de răscumpărare
  • Etichetare de către experți
    • analistul inspectează jurnalele și identifică comportamente neautorizate
  • Etichetare euristică
    • prea multe porturi au primit trafic într-un interval foarte scurt
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Etichetele nu sunt întotdeauna perfecte

Etichete fără zgomot sau puternice:

  • Adevăr de referință
  • Etichetare de către experți

Etichete zgomotoase sau slabe:

  • Etichetare euristică

Ingineria caracteristicilor:

  • Caracteristici folosite în euristici
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Caracteristici și euristici

Media porturilor unice vizitate de fiecare gazdă infectată:

np.mean(X[y]['unique_ports'])
15.11

Media porturilor unice vizitate per gazdă, fără etichete:

np.mean(X['unique_ports'])
11.23
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

De la caracteristici la etichete

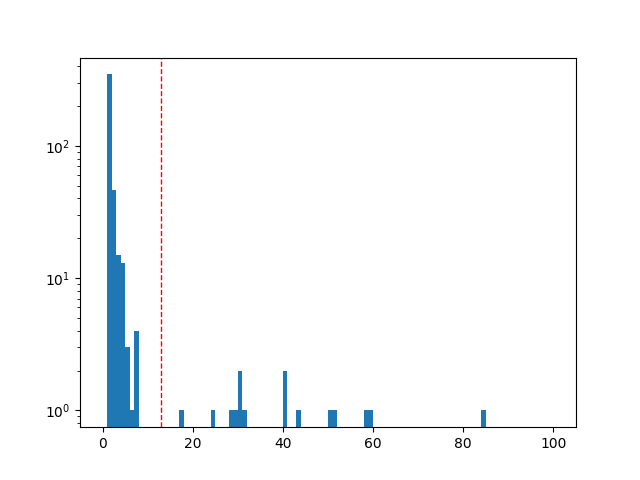
Conversia unei caracteristici într-o euristică de etichetare:

X_train, X_test, y_train, y_test = train_test_split(X, y)
y_weak_train = X_train['unique_ports'] > 15
hist_cropped.png

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

De la caracteristici la etichete

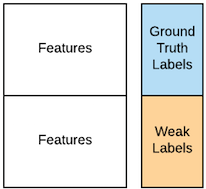
Două copii ale matricei de caracteristici stivuite una peste alta. Una conține etichete produse de experți, cealaltă este etichetată euristic.

X_train_aug = pd.concat([X_train, X_train])
y_train_aug = pd.concat([pd.Series(y_train), pd.Series(y_weak_train)])
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

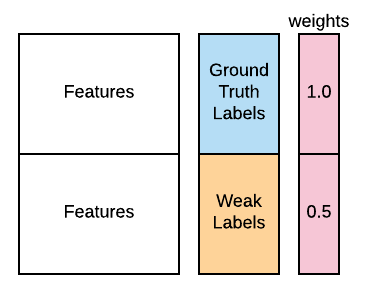
Datele sunt stivuite la fel ca în diapozitivul anterior, dar etichetelor originale li se atribuie o pondere de 1,0, iar celor produse euristic, o pondere de 0,5.

weights = [1.0]*len(y_train) + [0.1]*len(y_weak_train)
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Acuratețe folosind doar adevărul de referință:

0.91

Adevăr de referință și etichete slabe fără ponderi:

accuracy_score(y_test, clf.fit(X_train_aug, y_train_aug).predict(X_test))
0.93

Adăugare ponderi:

accuracy_score(y_test, clf.fit(X_train_aug, y_train_aug, sample_weight=weights).predict(X_test))
0.95
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Etichetele nu trebuie să fie perfecte!

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Preparing Video For Download...