Complexitatea modelului și supraajustarea

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Dr. Chris Anagnostopoulos

Honorary Associate Professor

Ce este complexitatea modelului?

RandomForestClassifier() acceptă argumente suplimentare, precum max_depth:

help(RandomForestClassifier)
Help on class RandomForestClassifier in module sklearn.ensemble.forest:
...
 |  max_depth : integer or None, optional (default=None)
 |      The maximum depth of the tree. If None, then nodes are expanded until
 |      all leaves are pure or until all leaves contain less than
 |      min_samples_split samples.
Proiectarea fluxurilor de lucru pentru Machine Learning în Python
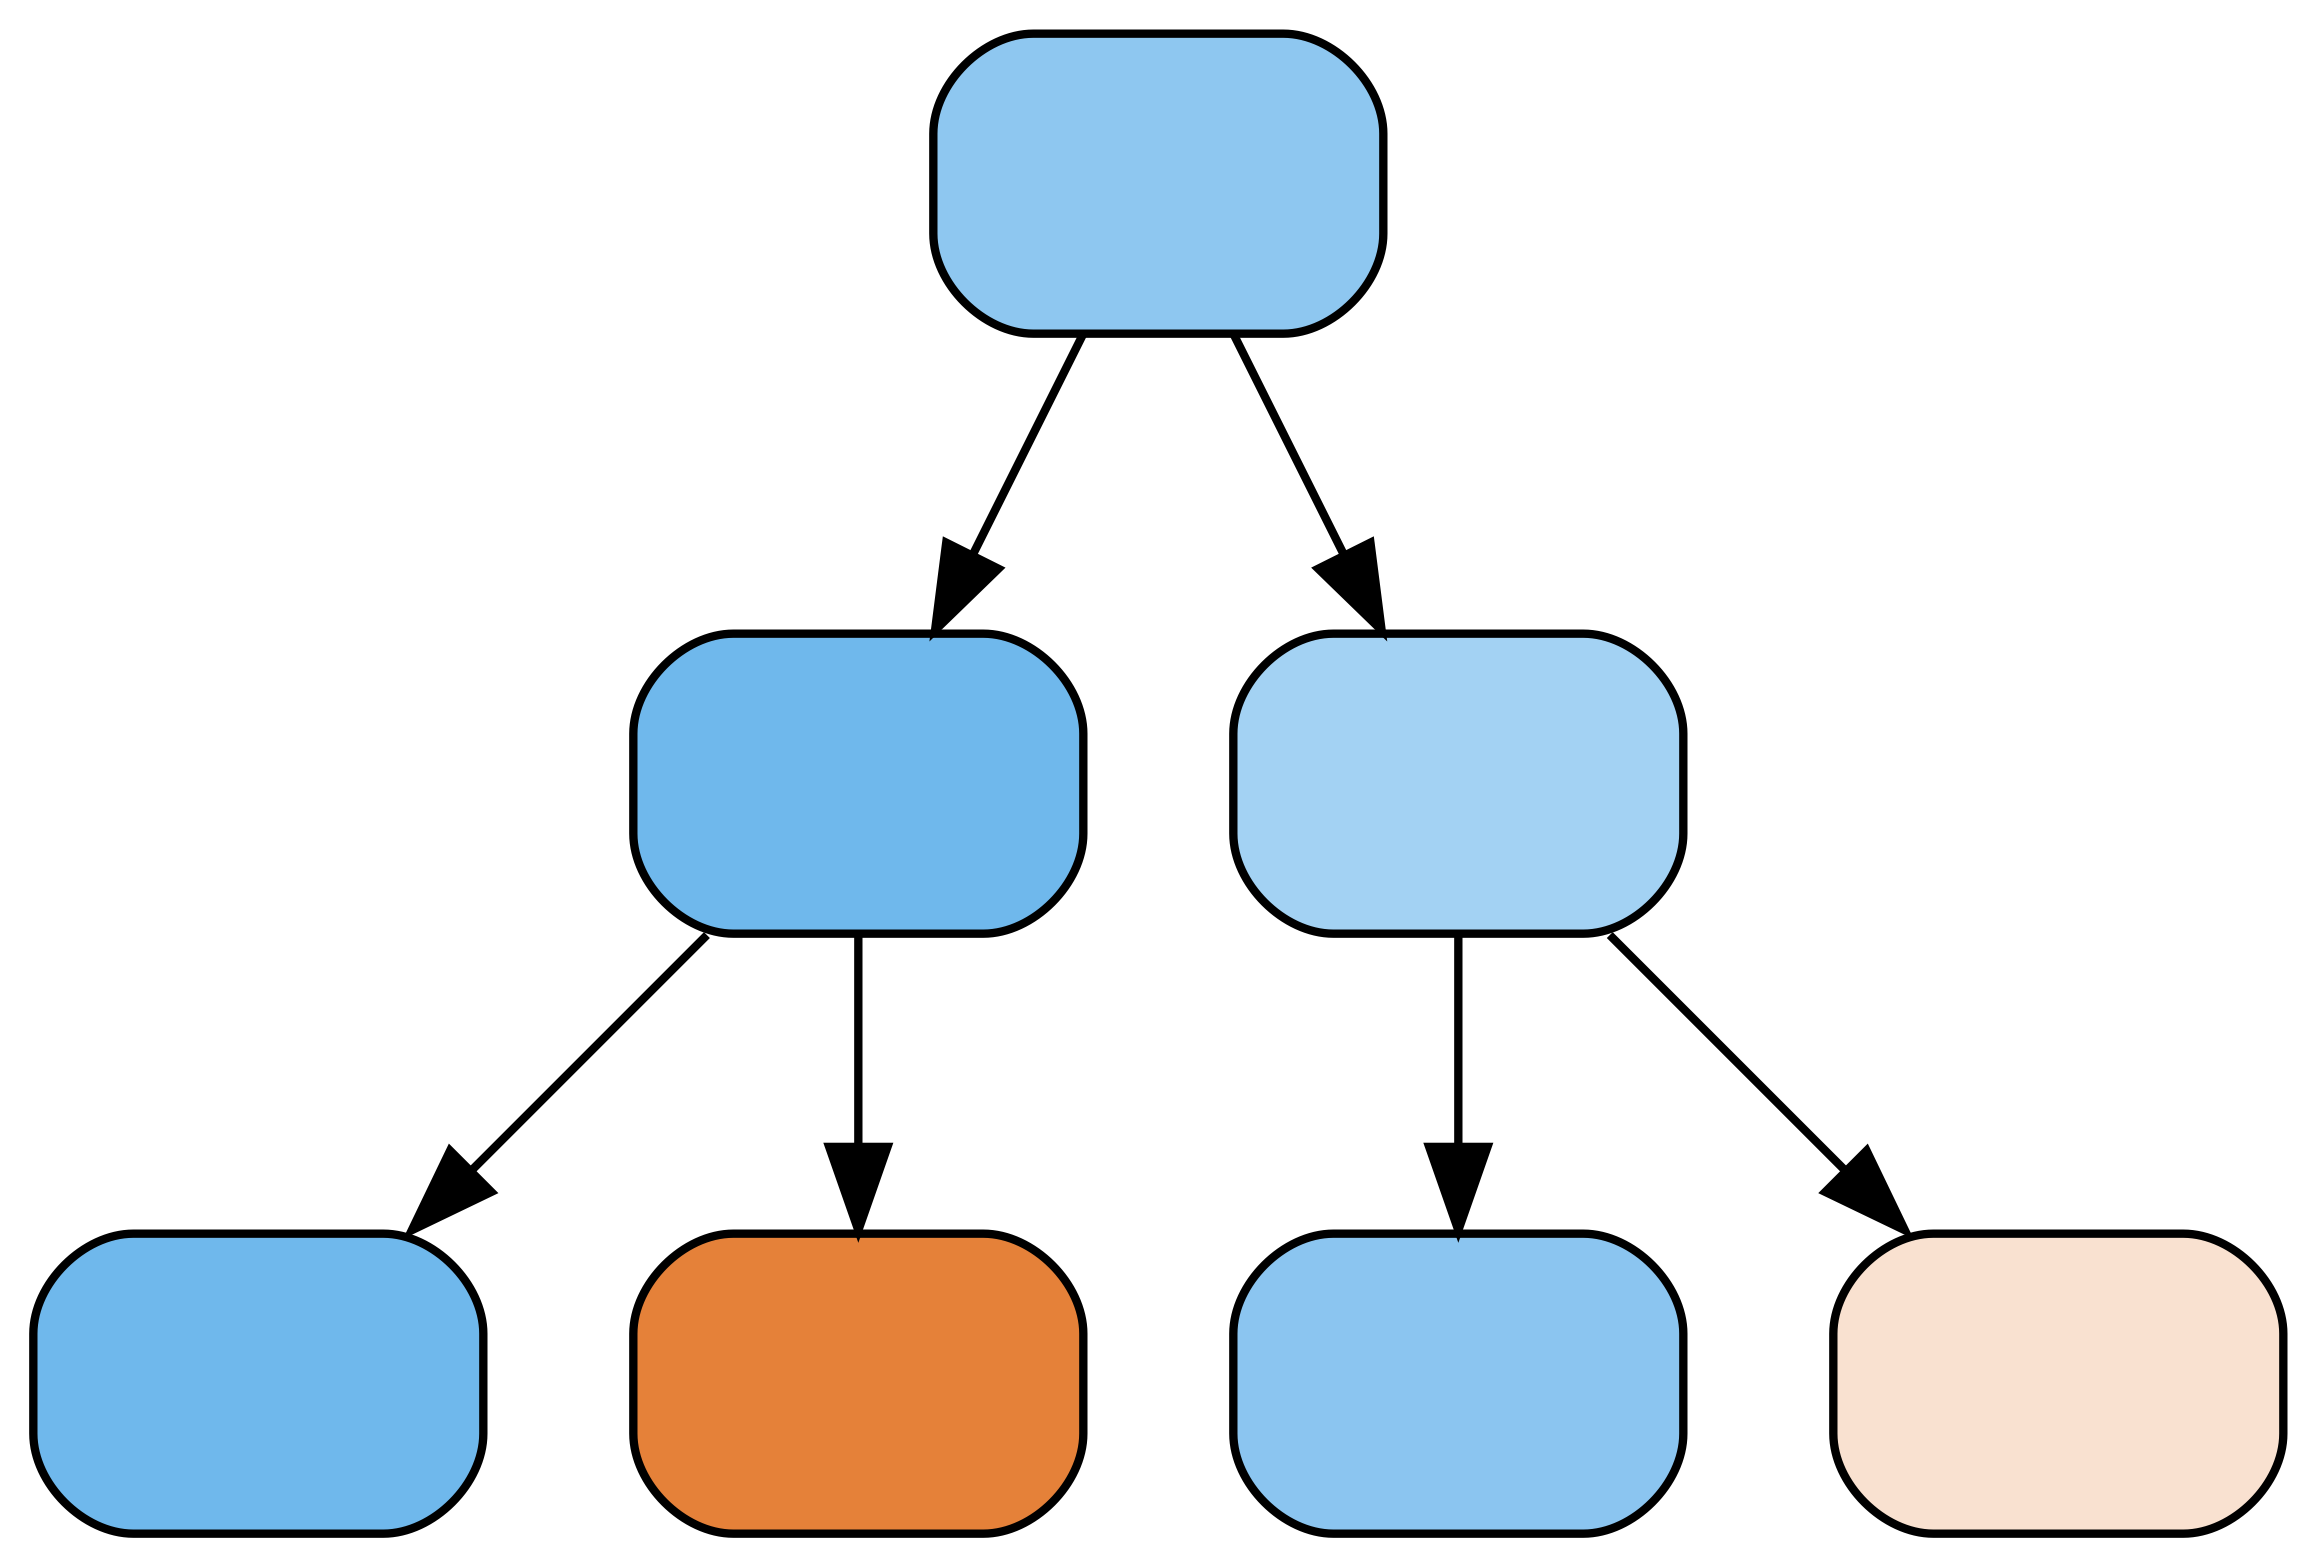
m2 = RandomForestClassifier(
    max_depth=2)
m2.fit(X_train, y_train)

m2.estimators_[0]

Un arbore de decizie cu adâncimea 2.

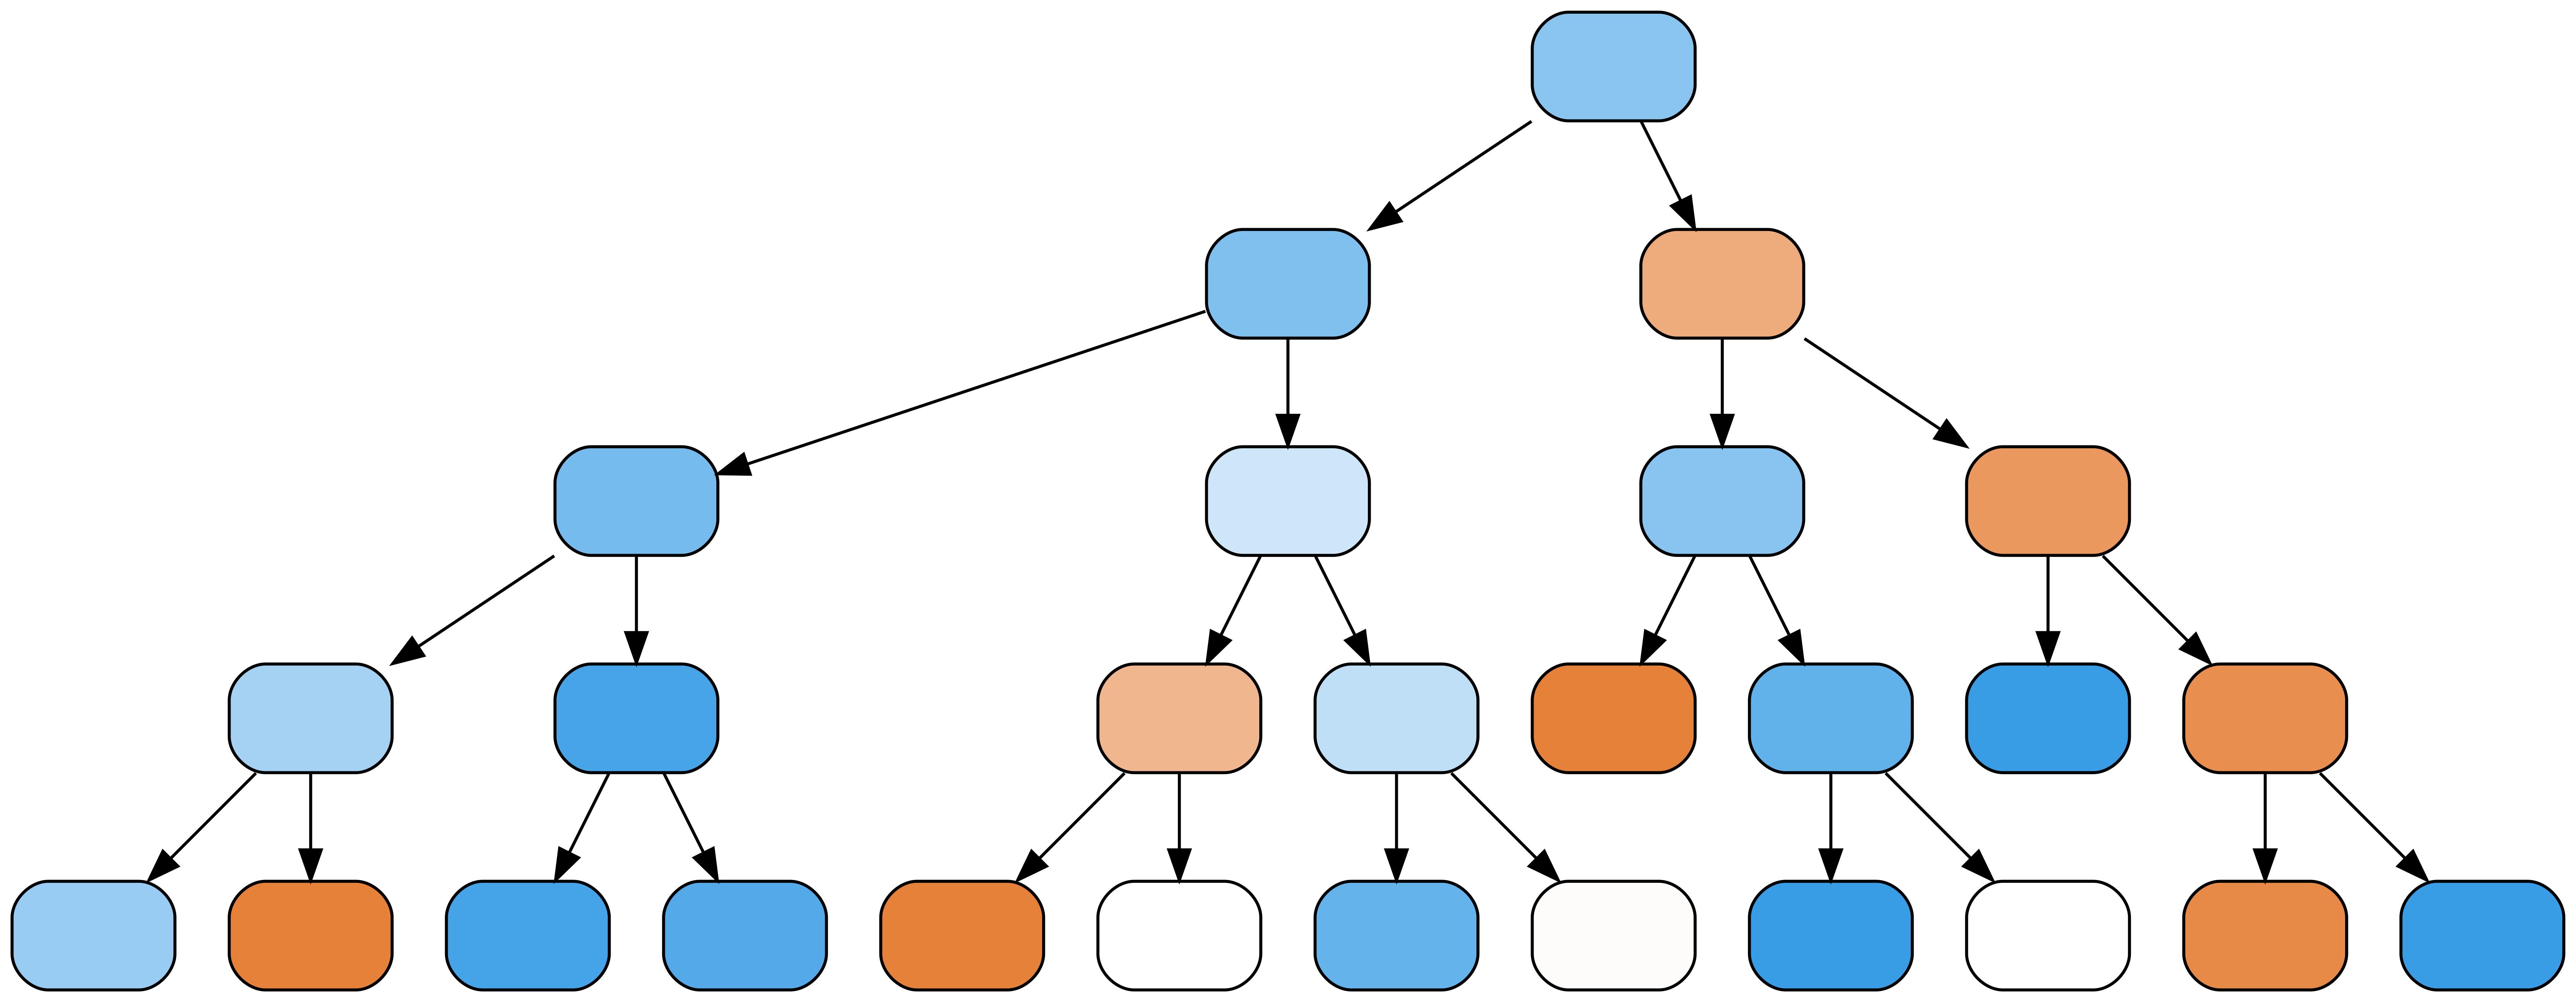
m4 = RandomForestClassifier(
    max_depth=4)
m4.fit(X_train, y_train)

m4.estimators_[0]

Un arbore de decizie cu adâncimea 4.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

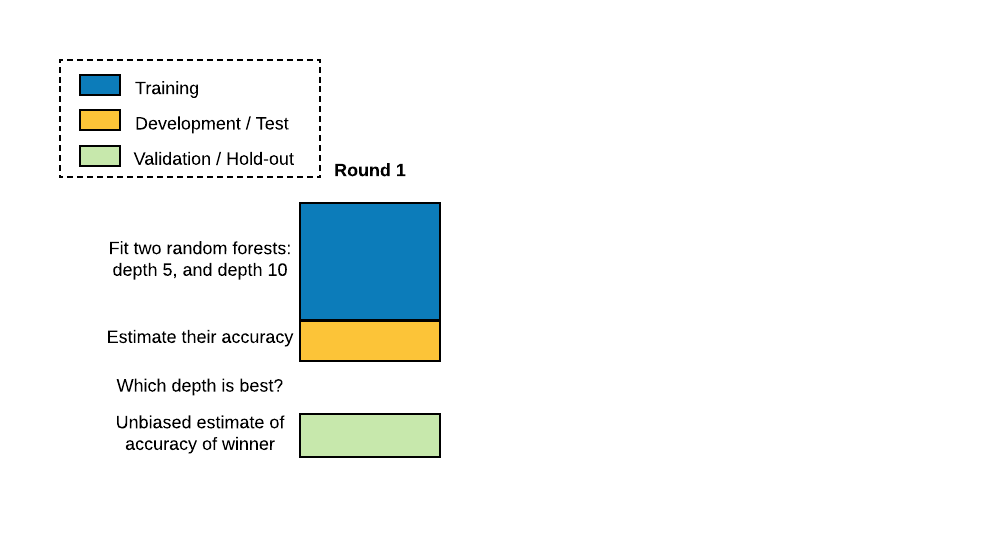
Practica standard constă în împărțirea datelor în seturi de antrenare, testare (sau dezvoltare) și validare (sau hold-out).

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

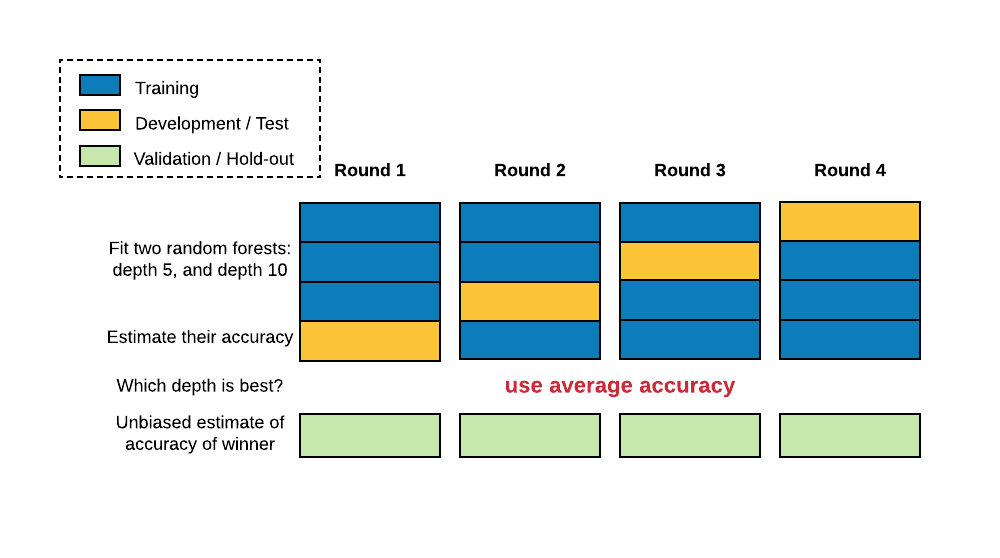
În validarea încrucișată, împărțirea antrenare-testare se repetă de mai multe ori. Setul de date este divizat în N segmente, iar de fiecare dată N-1 dintre ele sunt folosite pentru antrenare, iar cel rămas pentru testare.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Validare încrucișată

Evaluați acuratețea cu cross_val_score():

from sklearn.model_selection import cross_val_score

cross_val_score(RandomForestClassifier(), X, y)
array([0.7218 , 0.7682, 0.7866])
numpy.mean(cross_val_score(RandomForestClassifier(), X, y))
0.7589
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Reglarea complexității modelului

Reglați adâncimea arborelui cu GridSearchCV():

from sklearn.model_selection import GridSearchCV
param_grid = {'max_depth':[5,10,20]}
grid = GridSearchCV(RandomForestClassifier(), param_grid)
grid.fit(X,y)
grid._best_params
{'max_depth': 10}
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

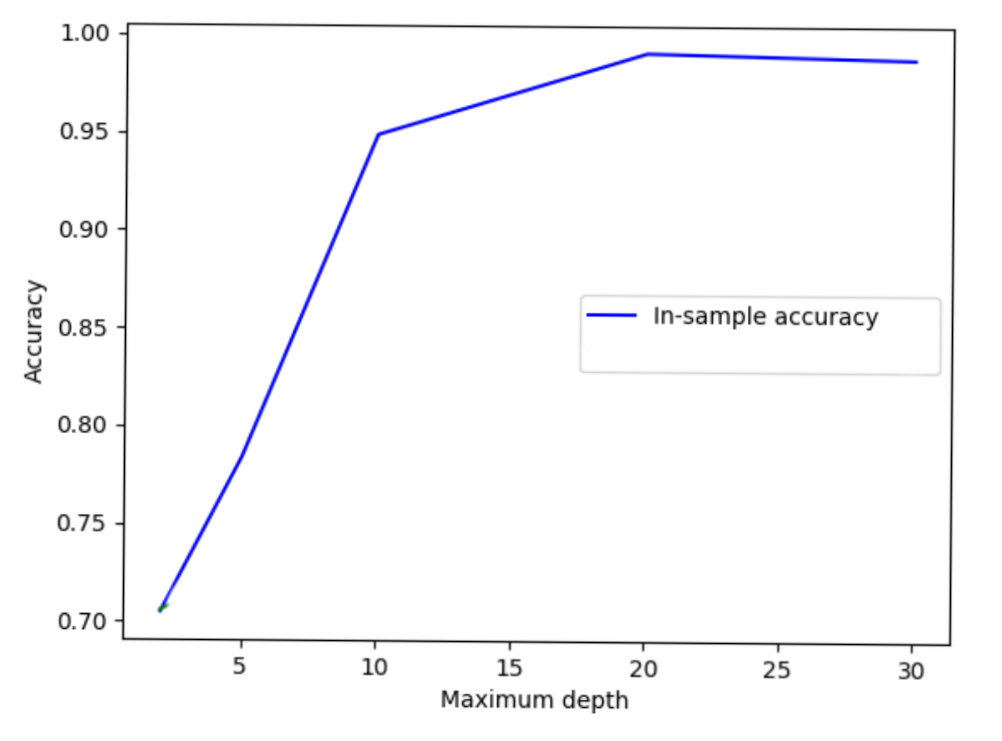
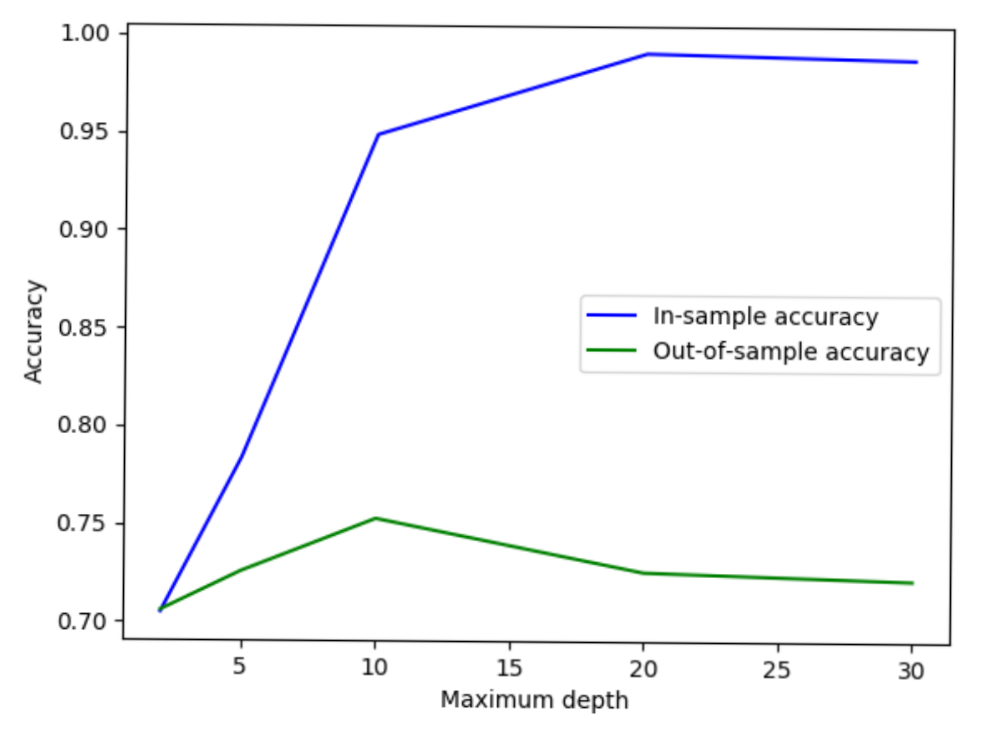
Acuratețea pe datele de antrenare pornește de la 0,7 pentru o adâncime maximă de 3 și crește aproape până la 1,0 pe măsură ce adâncimea ajunge la 30.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

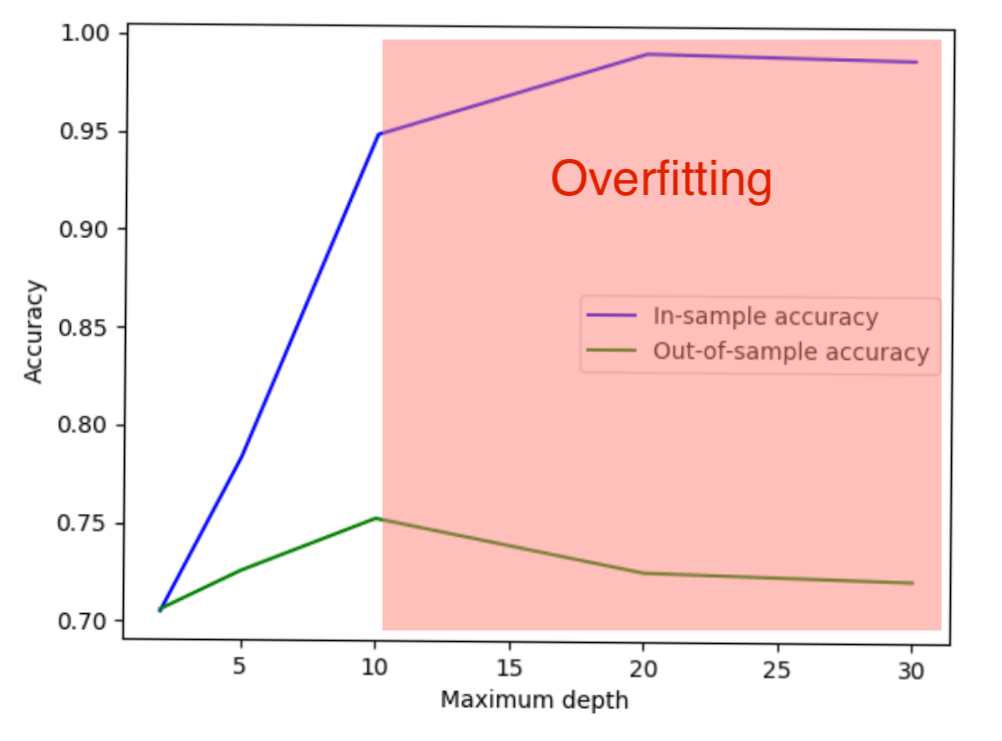
Acuratețea pe datele de test pornește tot de la 0,7, atinge maximul de 0,75 la adâncimea 10, apoi scade înapoi la 0,7 pentru adâncimi mai mari.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Intervalul de la adâncimea 10 în sus este marcat cu roșu, indicând supraajustarea.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Mai complex nu înseamnă mai bun!

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Preparing Video For Download...