De la fluxuri la pipeline-uri

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Dr. Chris Anagnostopoulos

Honorary Associate Professor

Recapitularea fluxului de lucru

from sklearn.ensemble import RandomForestClassifier as rf
X_train, X_test, y_train, y_test = train_test_split(X, y)
grid_search = GridSearchCV(rf(), param_grid={'max_depth': [2, 5, 10]})
grid_search.fit(X_train, y_train)
depth = grid_search.best_params_['max_depth']
vt = SelectKBest(f_classif, k=3).fit(X_train, y_train)
clf = rf(max_depth=best_value).fit(vt.transform(X_train), y_train)
accuracy_score(clf.predict(vt.transform(X_test), y_test))
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Puterea căutării pe grilă

Optimizați max_depth:

pg = {'max_depth': [2,5,10]}
gs = GridSearchCV(rf(),  
   param_grid=pg)
gs.fit(X_train, y_train)
depth = gs.best_params_['max_depth']

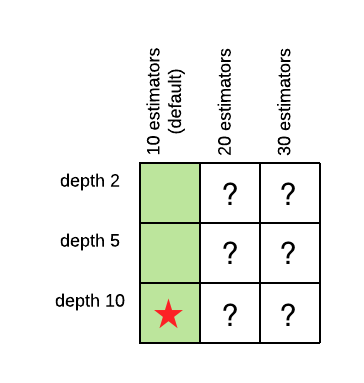
Un tabel cu toate combinațiile posibile de valori pentru adâncime și numărul de estimatori, arătând că trei valori au fost explorate și una a fost găsită ca optimă.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Puterea căutării pe grilă

Apoi optimizați n_estimators:

pg = {'n_estimators': [10,20,30]}
gs = GridSearchCV(
   rf(max_depth=depth),  
   param_grid=pg)
gs.fit(X_train, y_train)
n_est = gs.best_params_[
    'n_estimators']

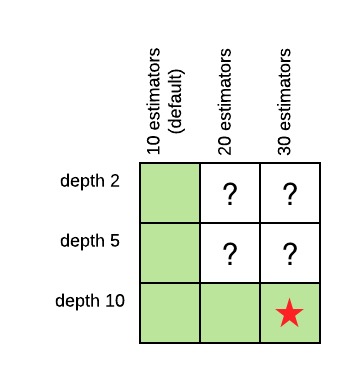
Un tabel cu toate combinațiile posibile de valori pentru adâncime și numărul de estimatori, arătând că cinci valori au fost explorate și alta a fost găsită ca optimă.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Puterea căutării pe grilă

Simultan max_depth și n_estimators:

pg = {
   'max_depth': [2,5,10],
   'n_estimators': [10,20,30]
}
gs = GridSearchCV(rf(),  
   param_grid=pg)
gs.fit(X_train, y_train)
print(gs.best_params_) 

{'max_depth': 10, 'n_estimators': 20}

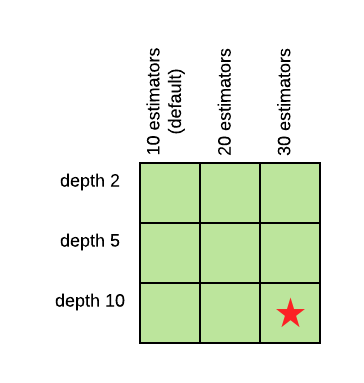
Un tabel cu toate combinațiile posibile de valori pentru adâncime și numărul de estimatori, arătând că toate valorile au fost explorate și aceeași a fost găsită ca optimă.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Pipeline-uri

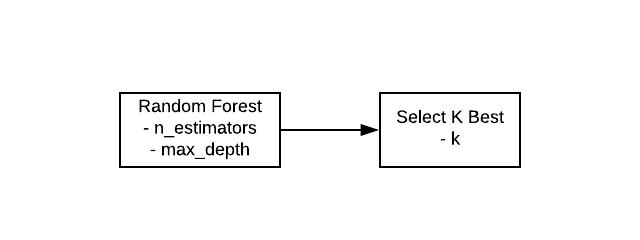
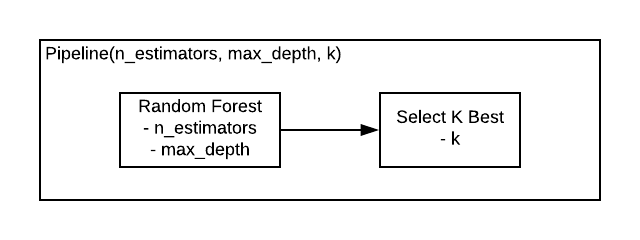
În această diagramă, random forest, cu doi hiperparametri, este conectat cu selectorul de caracteristici, care are un hiperparametru, printr-o săgeată.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Pipeline-uri

Ambele obiecte sunt încapsulate într-o singură casetă.

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Pipeline-uri

from sklearn.pipeline import Pipeline
pipe = Pipeline([
    ('feature_selection', SelectKBest(f_classif)), 
    ('classifier', RandomForestClassifier())
])

params = dict( feature_selection__k=[2, 3, 4], classifier__max_depth=[5, 10, 20] )
grid_search = GridSearchCV(pipe, param_grid=params) gs = grid_search.fit(X_train, y_train).best_params_
{'classifier__max_depth': 20, 'feature_selection__k': 4}
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Personalizarea pipeline-ului

from sklearn.metrics import roc_auc_score, make_scorer
auc_scorer = make_scorer(roc_auc_score)

grid_search = GridSearchCV(pipe, param_grid=params, scoring=auc_scorer)
Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Nu exagerați

params = dict(
    feature_selection__k=[2, 3, 4], 
    clf__max_depth=[5, 10, 20], 
    clf__n_estimators=[10, 20, 30] 
)
grid_search = GridSearchCV(pipe, params, cv=10)

3 x 3 x 3 x 10 = 270 antrenări ale clasificatorului!

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Fluxuri de lucru potențate

Proiectarea fluxurilor de lucru pentru Machine Learning în Python

Preparing Video For Download...