Introducere și motivație

Detecția fraudelor în R

Bart Baesens

Professor Data Science at KU Leuven

Instructori
picture_Bart.png

Detecția fraudelor în R

Instructori

picture_BartTim.png

Detecția fraudelor în R

Instructori

picture_BartTimSebastiaan.png

Detecția fraudelor în R

Ce este frauda?

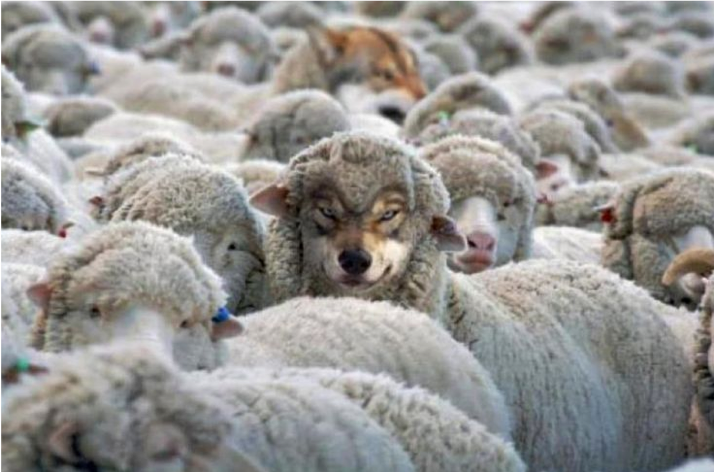
Frauda este o infracțiune rară, bine pregătită, imperceptibil disimulată, evolutivă în timp și adesea organizată cu grijă, care apare în multe tipuri și forme.
wolf_in_sheeps_clothing

Detecția fraudelor în R

Impactul fraudei

  • Frauda este foarte rară, dar costul nedetectării ei poate fi imens!
  • Exemple:
    • Organizațiile pierd 5% din veniturile anuale din cauza fraudei
    • Pierderile din fraudă în mediul de afaceri > 3,5 trilioane de dolari pe an
    • Companiile de carduri de credit pierd aproximativ 7 cenți la 100 de dolari de tranzacții din cauza fraudei
    • Frauda reprezintă 5-10% din sumele plătite pentru asigurări non-viață
Detecția fraudelor în R

Tipuri de fraudă

  • Spălare de bani
  • Fraudă prin cecuri
  • Fraudă cu carduri de credit
  • Fraudă vamală
  • Contrafacere
  • Furt de identitate
  • Fraudă în asigurări
  • Fraudă ipotecară
  • Fraudă prin nelivrare
  • Fraudă online
  • Fraudă la garanția produselor
  • Evaziune fiscală
  • Fraudă în telecomunicații
  • Furt de inventar
  • Fraudă cu bilete
  • Fraudă în transport
  • Fraudă prin transfer bancar
  • Fraudă la compensații pentru muncă
Detecția fraudelor în R

Caracteristici ale modelelor de succes în analiza fraudei
  • Acuratețe statistică

robinhood

Detecția fraudelor în R

Caracteristici ale modelelor de succes în analiza fraudei
  • Acuratețe statistică
  • Interpretabilitate

minorityreport

Detecția fraudelor în R

Caracteristici ale modelelor de succes în analiza fraudei
  • Acuratețe statistică
  • Interpretabilitate
  • Conformitate cu reglementările

regulatory

Detecția fraudelor în R

Caracteristici ale modelelor de succes în analiza fraudei
  • Acuratețe statistică
  • Interpretabilitate
  • Conformitate cu reglementările
  • Impact economic

dagobert

Detecția fraudelor în R

Caracteristici ale modelelor de succes în analiza fraudei
  • Acuratețe statistică
  • Interpretabilitate
  • Conformitate cu reglementările
  • Cost economic
  • Completarea abordărilor bazate pe expertiză cu tehnici bazate pe date

manmachine

Detecția fraudelor în R

Provocările modelului de detectare a fraudei
  • Dezechilibru
    • ex.: în frauda cu carduri de credit, de obicei < 0,5% fraude

haystack

Detecția fraudelor în R

Provocările modelului de detectare a fraudei
  • Dezechilibru
    • ex.: în frauda cu carduri de credit, de obicei < 0,5% fraude
  • Eficiență operațională
    • ex.: în frauda cu carduri de credit, timp de decizie < 8 secunde

flash

Detecția fraudelor în R

Provocările modelului de detectare a fraudei
  • Dezechilibru
    • ex.: în frauda cu carduri de credit, de obicei < 0,5% fraude
  • Eficiență operațională
    • ex.: în frauda cu carduri de credit, timp de decizie < 8 secunde
  • Evitarea deranjării clienților legitimi

goodcustomer

Detecția fraudelor în R

Date dezechilibrate

  • După o furtună majoră, o companie de asigurări a primit multe cereri de despăgubire

    • Cererile frauduloase sunt etichetate cu 1, cele legitime cu 0
  • Procentul cazurilor de fraudă din date poate fi determinat cu funcțiile

    • table() și prop.table()
  • prop.table(table(...)) pentru a determina proporția fraudelor

prop.table(table(fraud_label))
     0      1
0.9911 0.0089
Detecția fraudelor în R

Vizualizarea dezechilibrului cu diagrama circulară

labels <- c("no fraud", "fraud")
labels <- paste(labels, round(100 * prop.table(table(fraud_label)), 2), "%")
pie(table(fraud_label), labels, col = c("blue", "red"),
      main = "Pie chart of storm claims")
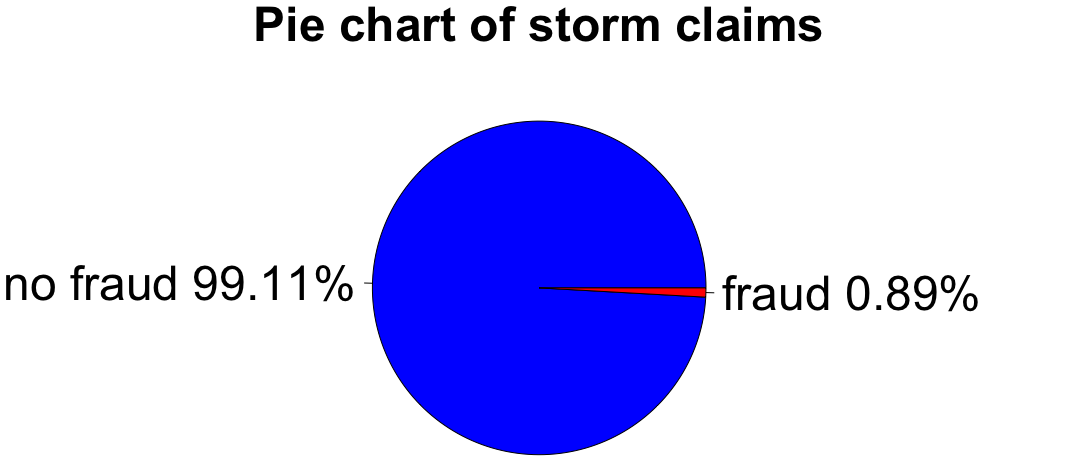
stormclaims

Detecția fraudelor în R

Matricea de confuzie

Utilizată pentru evaluarea modelului de detectare a fraudei:
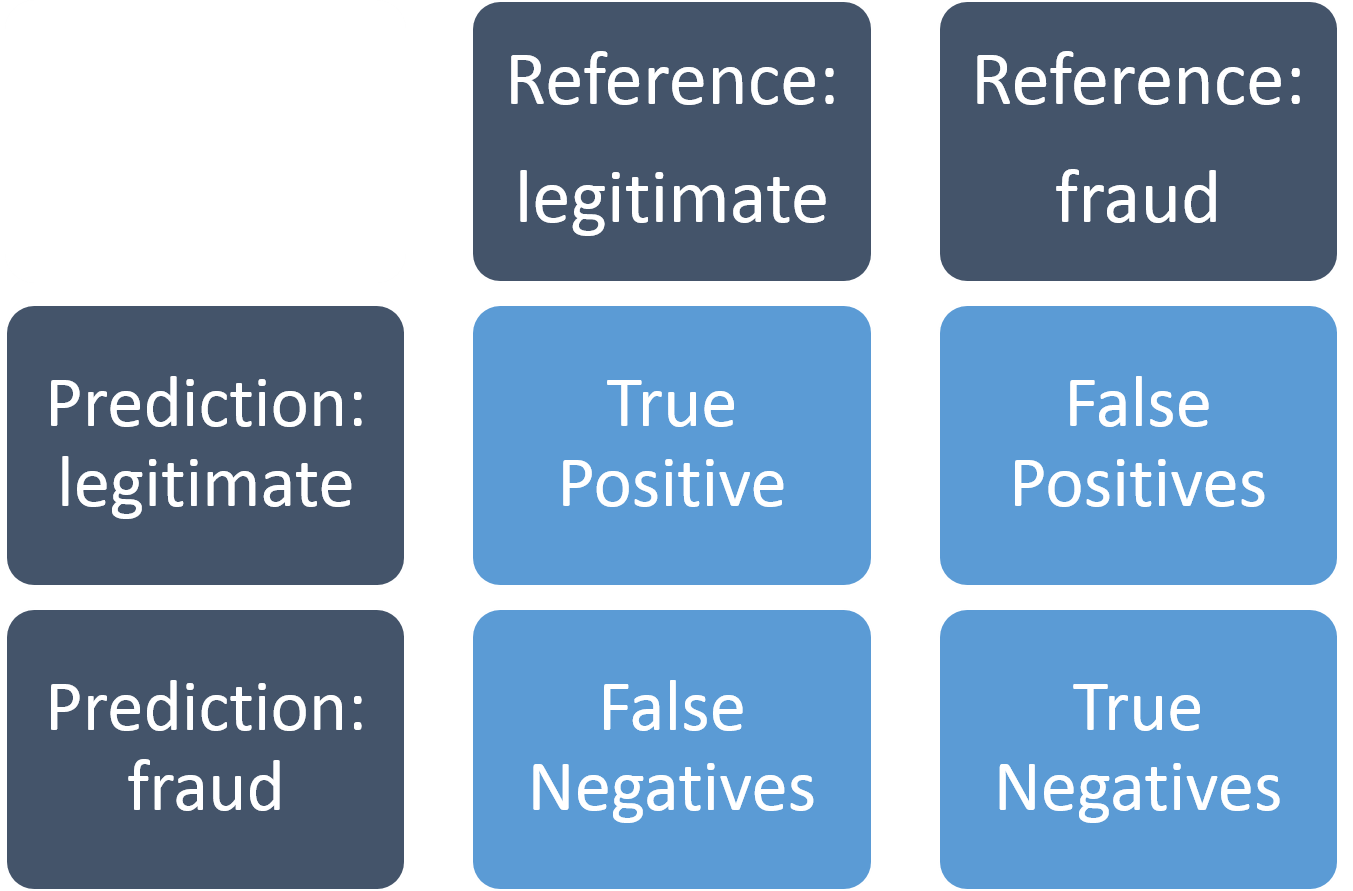
confusionmatrix

Detecția fraudelor în R
  • Să presupunem că nu se folosește niciun model de detectare, deci toate cererile sunt considerate legitime:
predictions <- rep.int(0, times = nrow(claims))
predictions <- factor(predictions, levels = c("no fraud", "fraud"))
  • Funcția confusionMatrix() din pachetul caret:
library(caret)
confusionMatrix(data = predictions, reference = fraud_label)
             Reference
 Prediction    0   1
            0 614  14
            1   0   0                                   
 Accuracy : 0.9777
Detecția fraudelor în R

Costul total al nedetectării fraudei: exemplu cu cereri de despăgubire

  • Costul total al fraudei este definit ca suma sumelor frauduloase
  • Costul total dacă nicio fraudă nu este detectată:
    > total_cost <- sum(claim_amount[fraud_label == "fraud"])
    > print(total_cost)
    
2301508
Detecția fraudelor în R

Să exersăm!

Detecția fraudelor în R

Preparing Video For Download...