Gestionarea seturilor de date dezechilibrate

Detecția fraudelor în R

Bart Baesens

Professor Data Science at KU Leuven

Seturi de date dezechilibrate
  • Provocare principală: etichetarea evenimentelor ca fraudă sau nu
    • Provocare majoră pentru metodele de clasificare și detecția anomaliilor
  • Clasificatorul tinde să favorizeze clasa majoritară (= fără fraudă)
    • eroare mare de clasificare pentru cazurile de fraudă
  • Clasificatorii învață mai bine dintr-o distribuție echilibrată

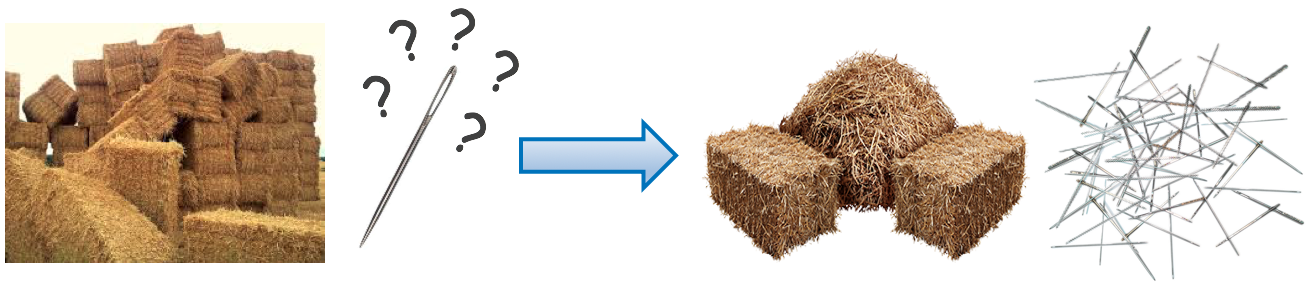
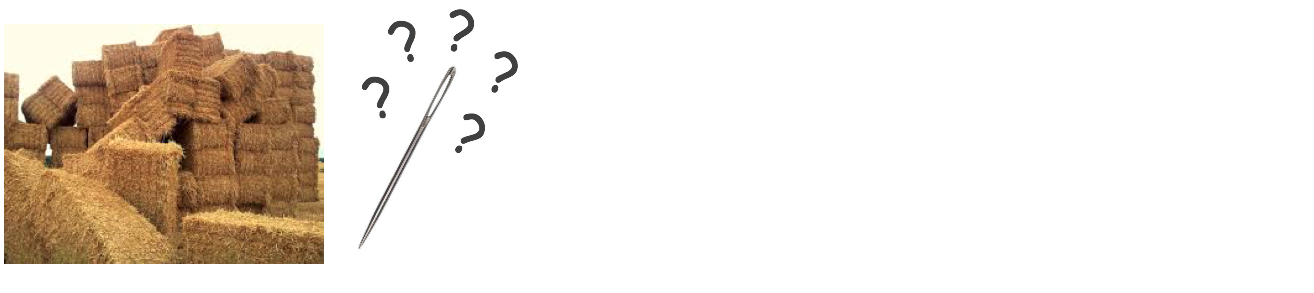
ac cu fân și ac

Detecția fraudelor în R

Seturi de date dezechilibrate

  • Provocare principală: etichetarea evenimentelor ca fraudă sau nu
    • Provocare majoră pentru metodele de clasificare și detecția anomaliilor
  • Clasificatorul tinde să favorizeze clasa majoritară (= fără fraudă)
    • eroare mare de clasificare pentru cazurile de fraudă
  • Clasificatorii învață mai bine dintr-o distribuție echilibrată
  • Soluție posibilă: modificarea distribuției claselor prin metode de eșantionare

ac în carul cu fân

Detecția fraudelor în R

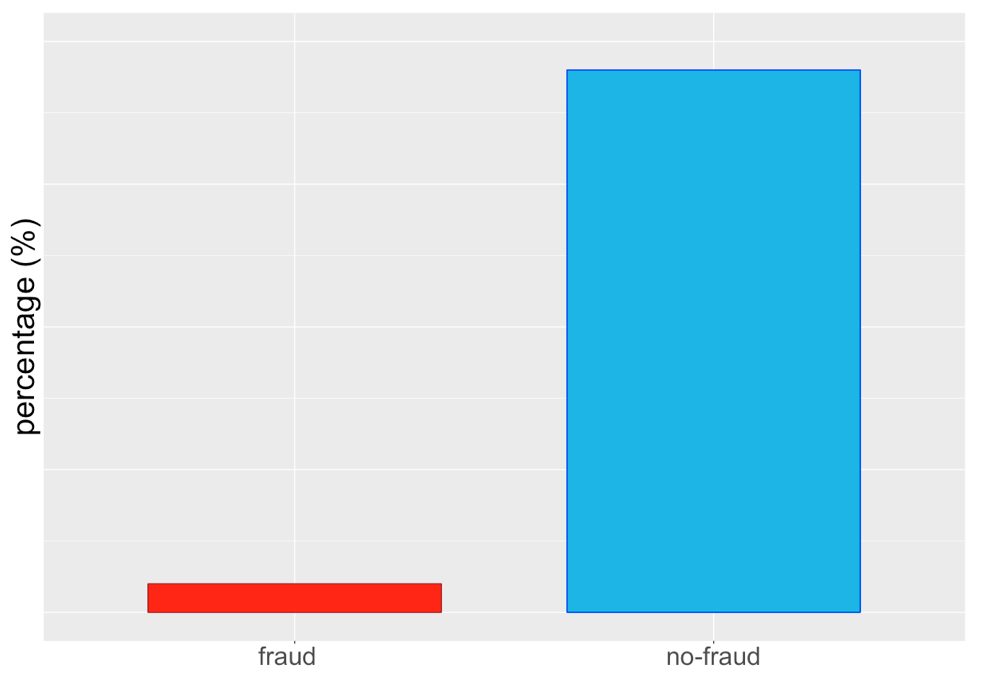
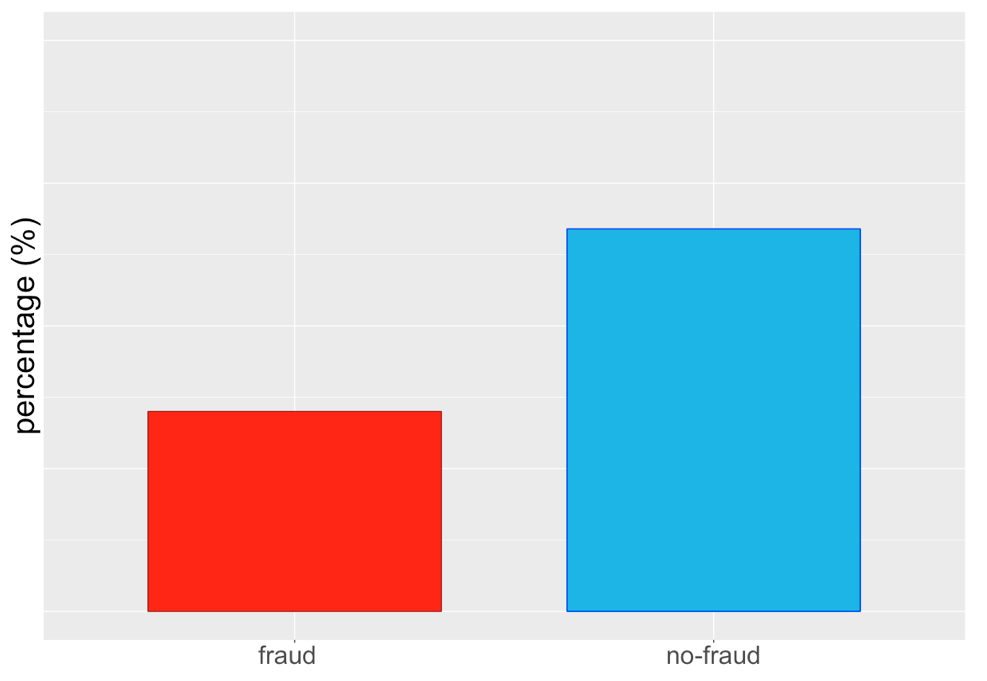
Dezechilibrul inițial

grafic de bare - dezechilibru original

Detecția fraudelor în R

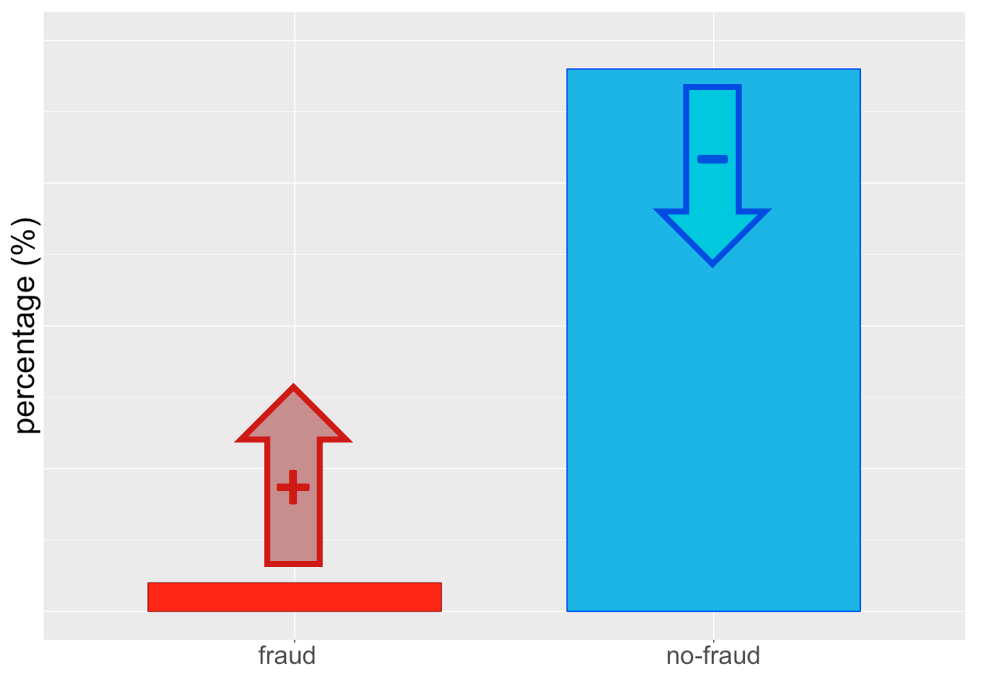
Supra-eșantionarea clasei minoritare...
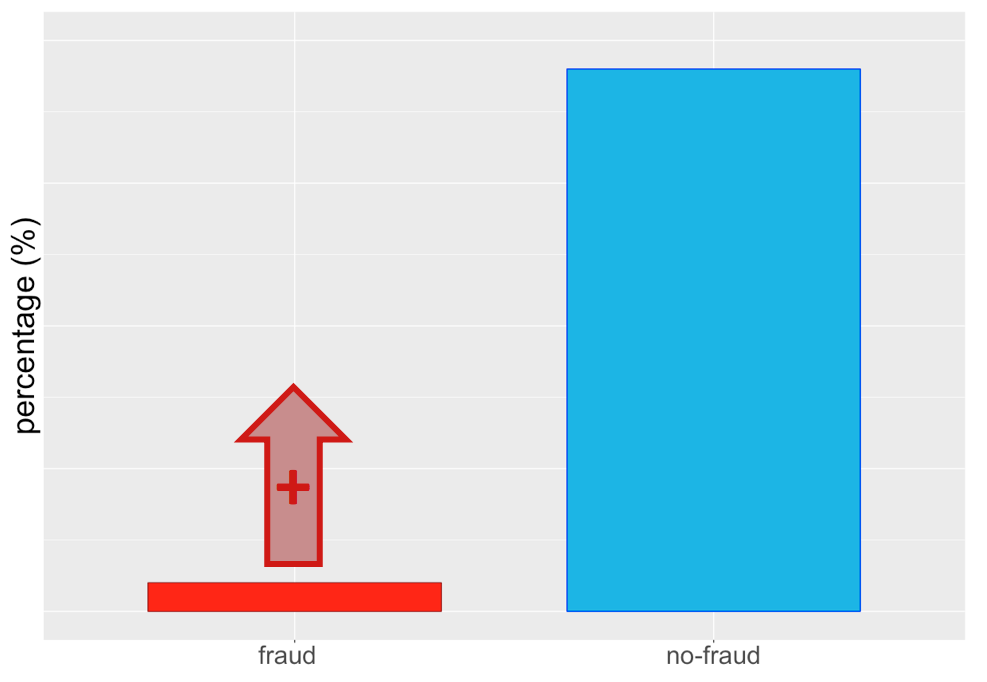
grafic de bare - supra-eșantionare

Detecția fraudelor în R

... sau sub-eșantionarea clasei majoritare ...
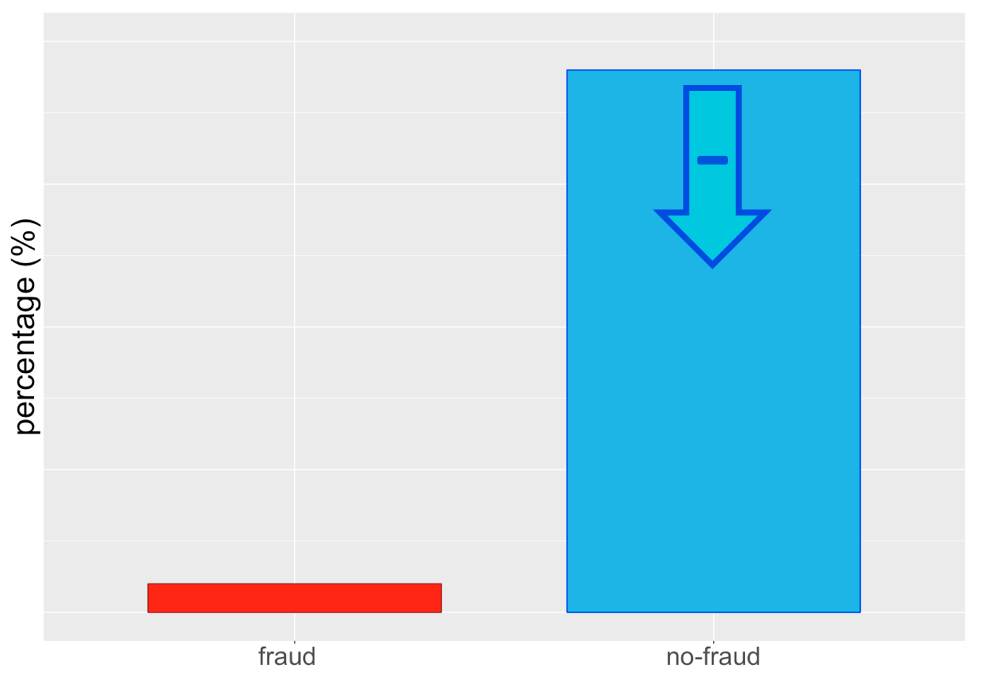
grafic de bare - sub-eșantionare

Detecția fraudelor în R

... sau ambele!

grafic de bare - ambele metode

Detecția fraudelor în R

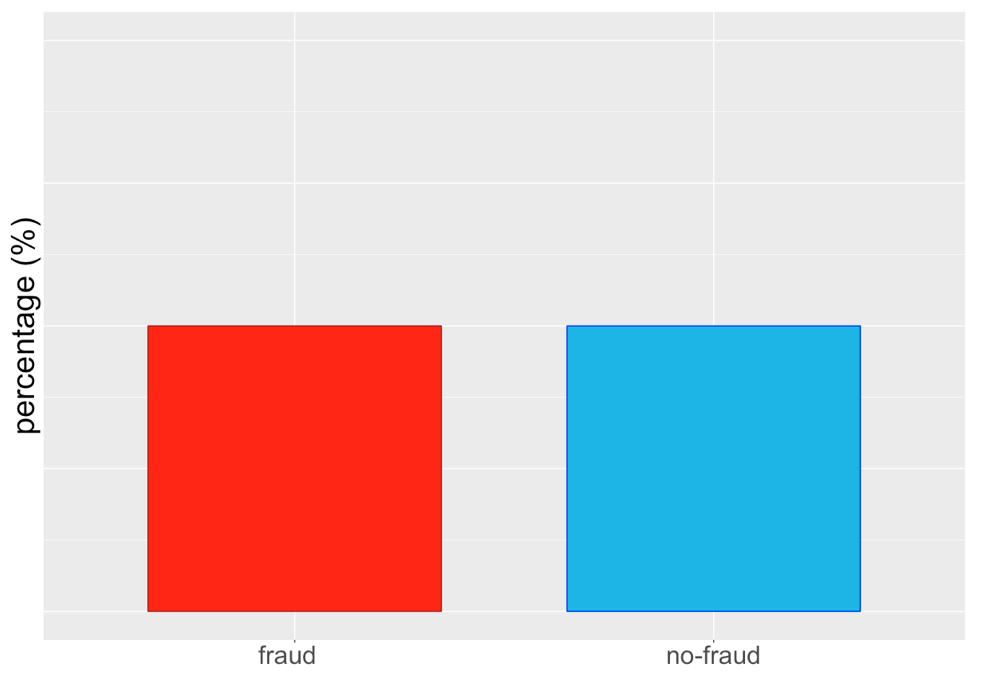
Rezultat după eșantionare...

grafic de bare - rezultat 2

Detecția fraudelor în R

... sau astfel

grafic de bare - rezultat 1

Detecția fraudelor în R

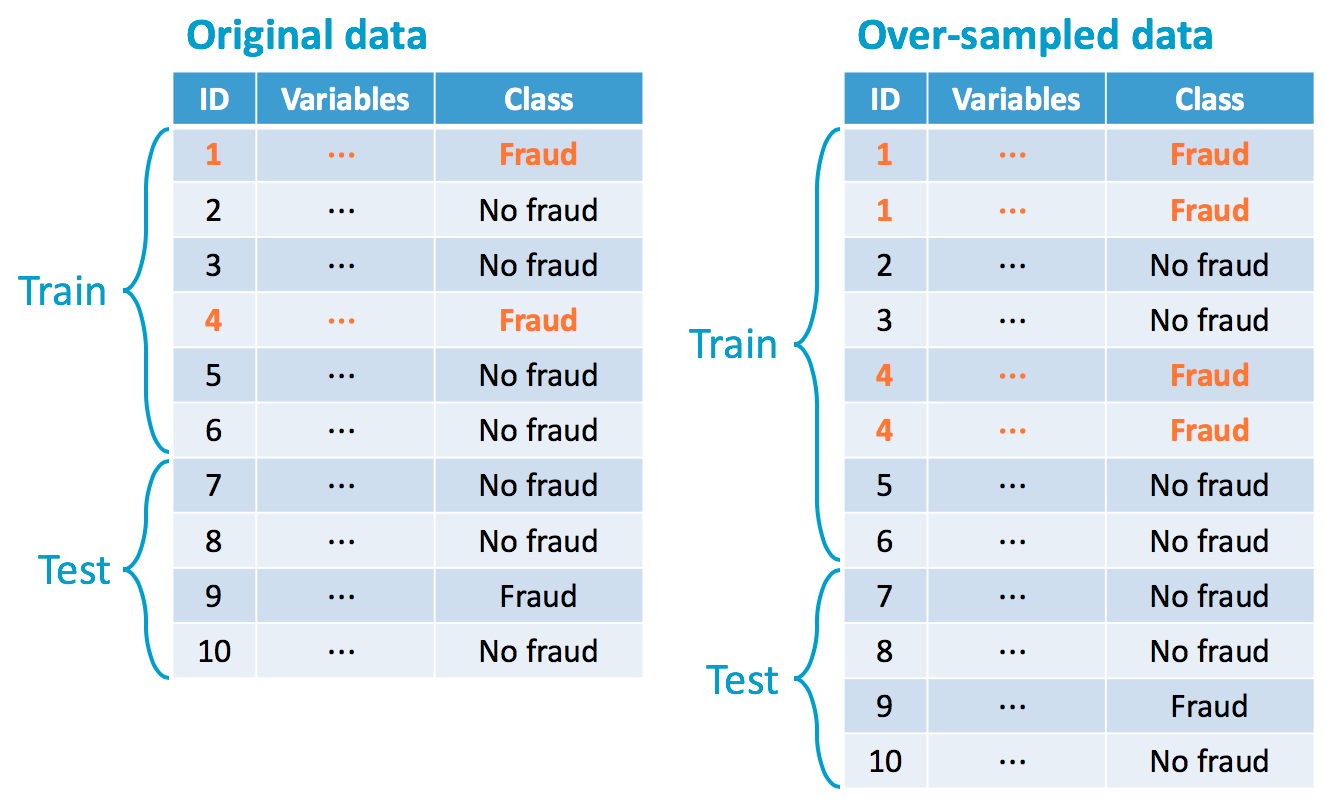
Supra-eșantionare aleatorie (ROS)
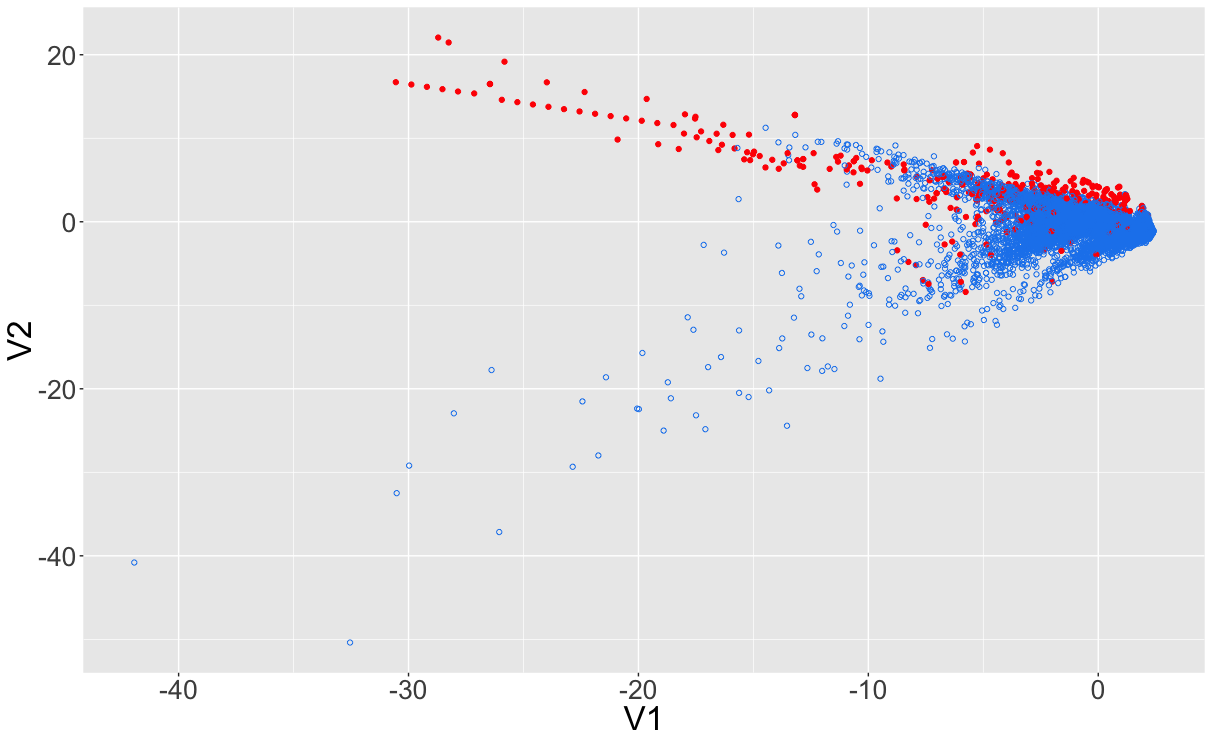
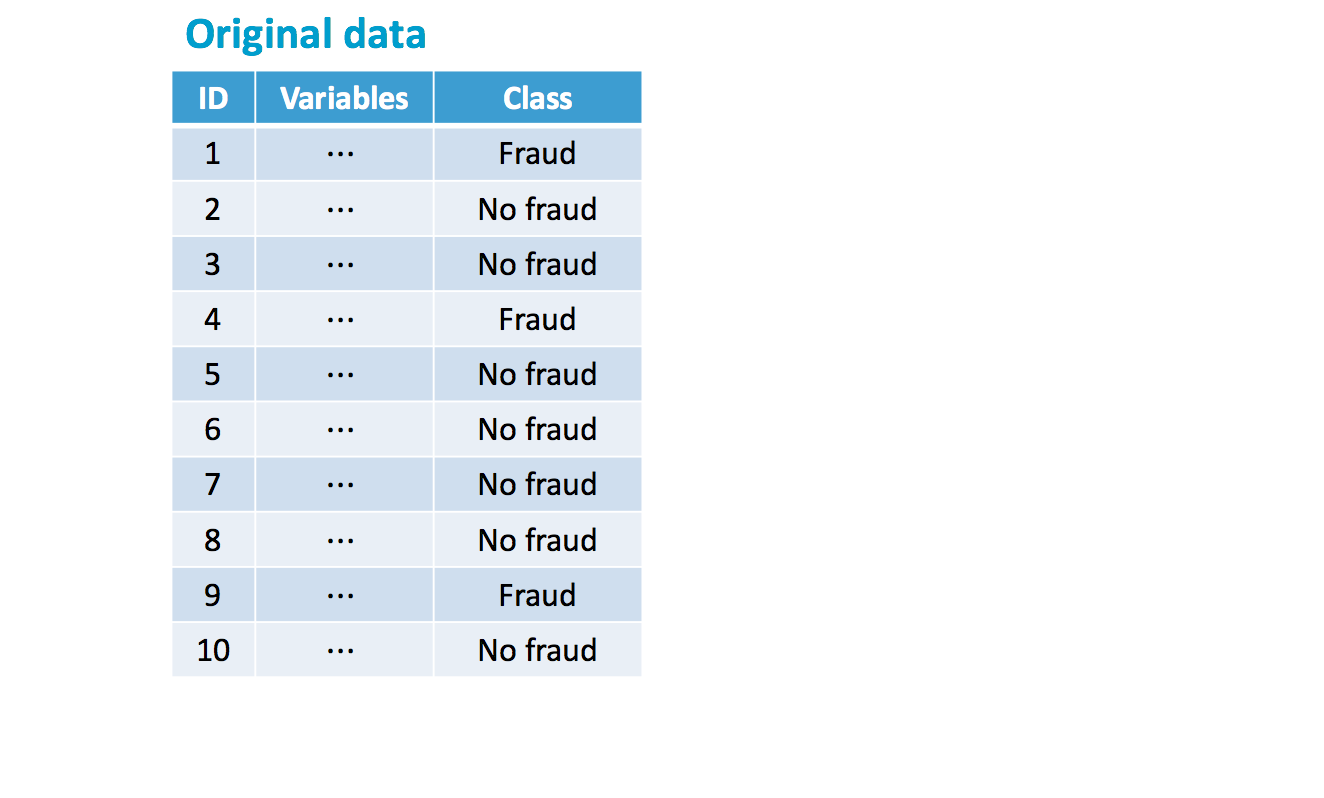
date originale

Detecția fraudelor în R

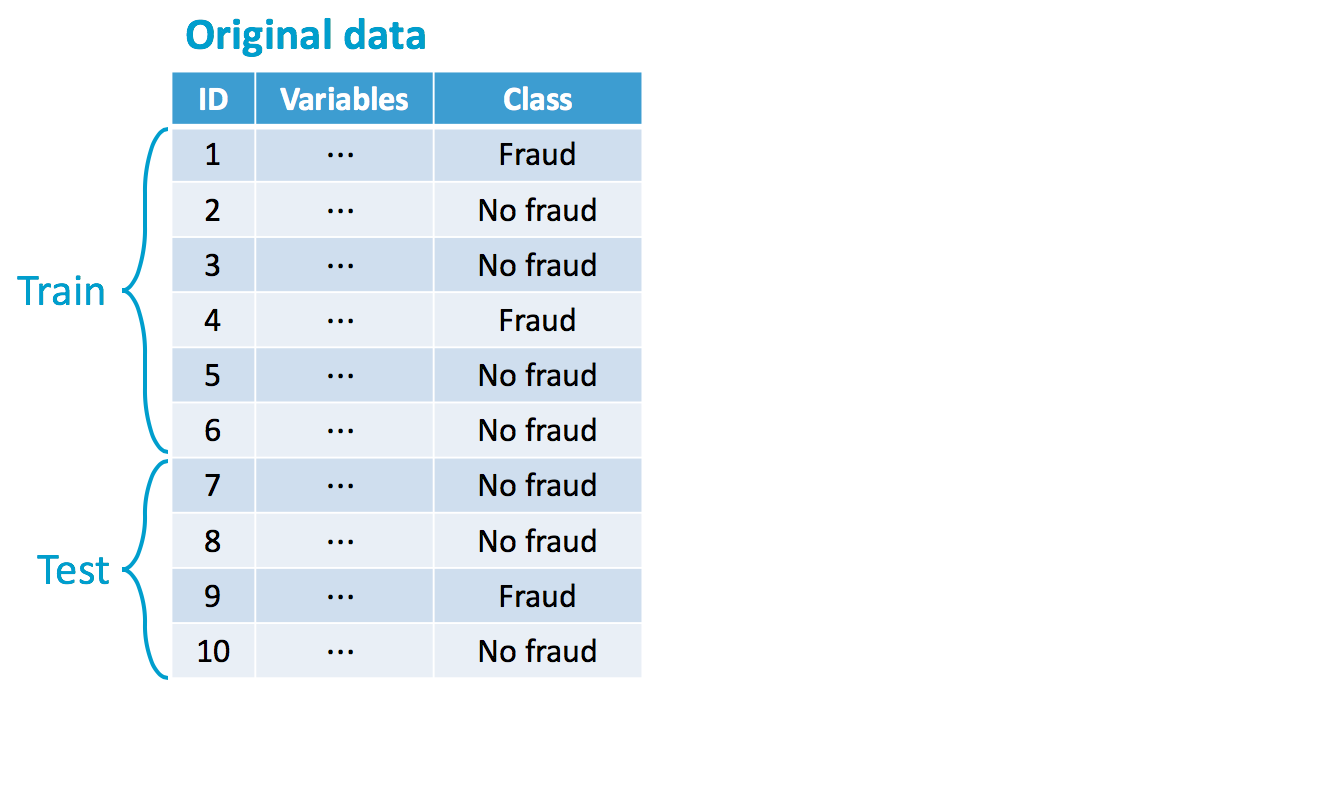
date originale - antrenare și testare

Detecția fraudelor în R

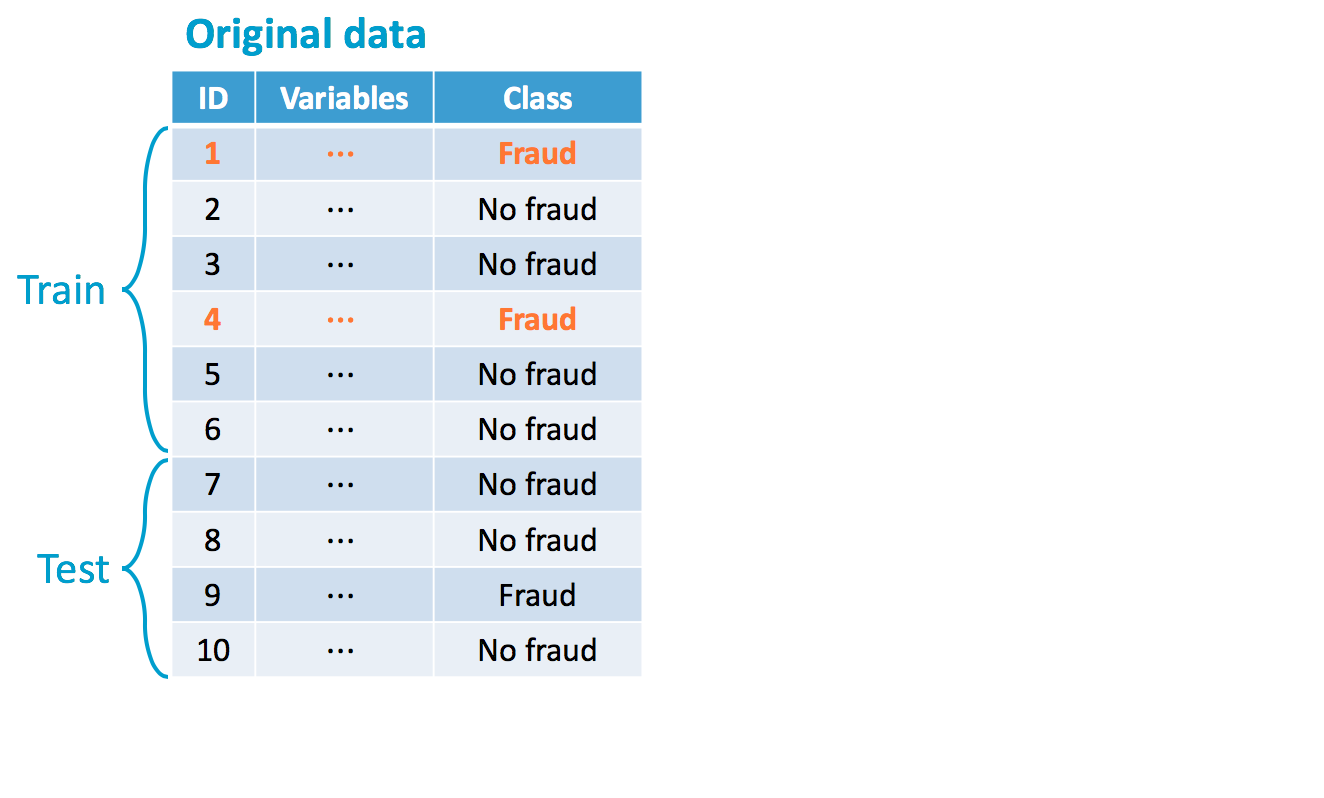
supra-eșantionare aleatorie v0

Detecția fraudelor în R

supra-eșantionare aleatorie v1

Detecția fraudelor în R

Supra-eșantionare aleatorie în practică

  • Setul de date Credit Card Fraud Detection de pe Kaggle
    • $\sim$ 300K transferuri anonimizate cu card, etichetate ca frauduloase sau legitime
  • Despre date...
    • Variabile numerice (anonimizate): V1, V2, ... , V28
    • Time = secunde scurse între fiecare transfer și primul din set
    • Amount = valoarea tranzacției
    • Class = variabilă răspuns: 1 pentru fraudă, 0 altfel
Detecția fraudelor în R

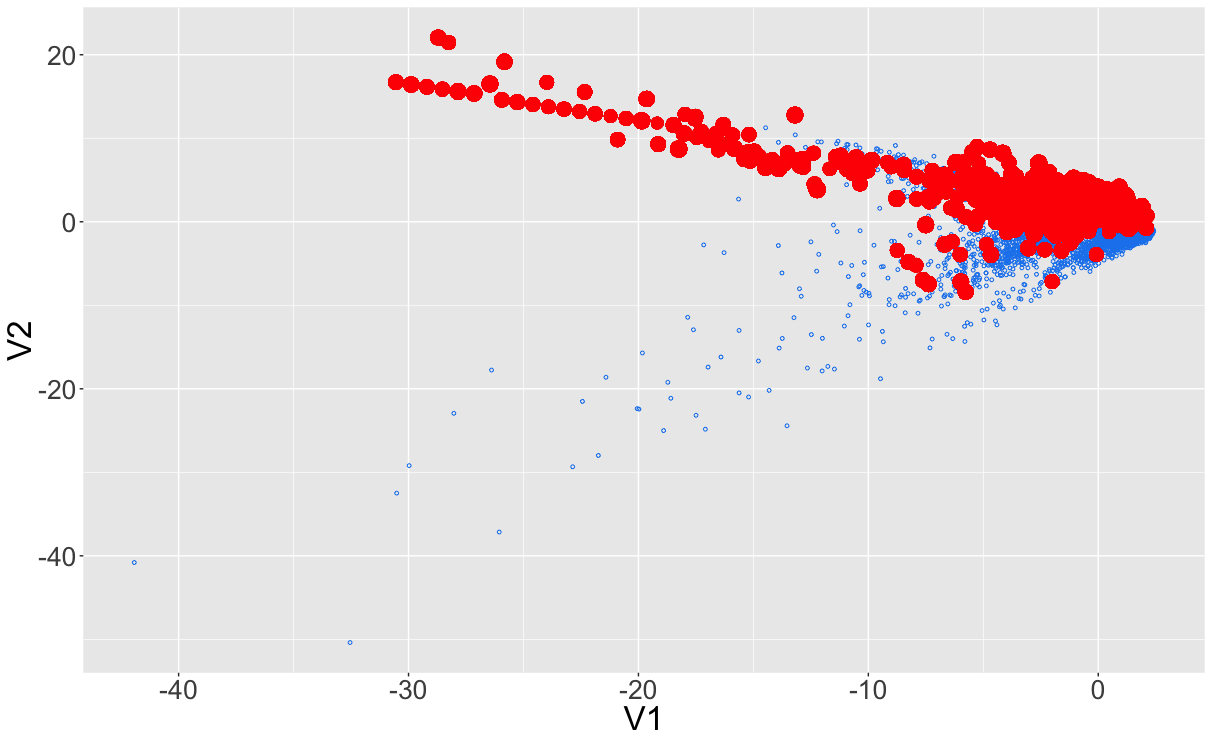
V2 față de V1 - date card de credit

Detecția fraudelor în R

Verificarea dezechilibrului

head(creditcard)
  Time         V1         V2  ...            V27         V28 Amount Class
1    0  1.1918571  0.2661507  ...  -0.0089830991  0.01472417   2.69     0
2   10  0.3849782  0.6161095  ...   0.0424724419 -0.05433739   9.99     0
3   12 -0.7524170  0.3454854  ...  -0.1809975001  0.12939406  15.99     0
4   17  0.9624961  0.3284610  ...   0.0163706433 -0.01460533  34.09     0
5   34  0.2016859  0.4974832  ...   0.1427572469  0.21923761   9.99     0
prop.table(table(creditcard$Class))
   0    1 
0.98 0.02
Detecția fraudelor în R

ovun.sample din pachetul ROSE

n_legit <- 24108
new_frac_legit <- 0.50
new_n_total <- n_legit / new_frac_legit ## = 24108 / 0.50 = 48216

library(ROSE) oversampling_result <- ovun.sample(formula = Class ~ ., data = creditcard, method = "over", N = new_n_total, seed = 2018)
oversampled_credit <- oversampling_result$data prop.table(table(oversampled_credit$Class))
  0   1 
0.5 0.5
Detecția fraudelor în R

V2 față de V1 - date supra-eșantionate

Detecția fraudelor în R

Să exersăm!

Detecția fraudelor în R

Preparing Video For Download...