De la set de date la model de detecție

Detecția fraudelor în R

Sebastiaan Höppner

PhD researcher in Data Science at KU Leuven

Plan de lucru

  • (1) Împărțiți setul de date în set de antrenament și set de test
  • (2) Alegeți un model de învățare automată
  • (3) Aplicați SMOTE pe setul de antrenament pentru a echilibra distribuția claselor
  • (4) Antrenați modelul pe setul reechilibrat
  • (5) Testați performanța pe setul de test (original)
Detecția fraudelor în R

Împărțiți setul de date în antrenament și test

  • Împărțiți setul de date în set de antrenament și set de test (ex. 50/50, 75/25, ...)
  • Asigurați-vă că ambele seturi au distribuții identice ale claselor (inițial)
  • Exemplu: 50% set de antrenament și 50% set de test
prop.table(table(train$Class))
   0    1 
0.98 0.02
prop.table(table(test$Class))
   0    1 
0.98 0.02
Detecția fraudelor în R

Alegeți și antrenați un model de învățare automată

  • Arbore de decizie, rețea neuronală artificială, mașini cu vectori suport, regresie logistică, pădure aleatorie, Naive Bayes, k-Nearest Neighbors, ...
  • Exemplu: algoritmul Classification And Regression Tree (CART)
  • Funcția rpart din pachetul rpart
library(rpart)

model1 = rpart(Class ~ ., data = train)
Detecția fraudelor în R
library(partykit)
plot(as.party(model1))
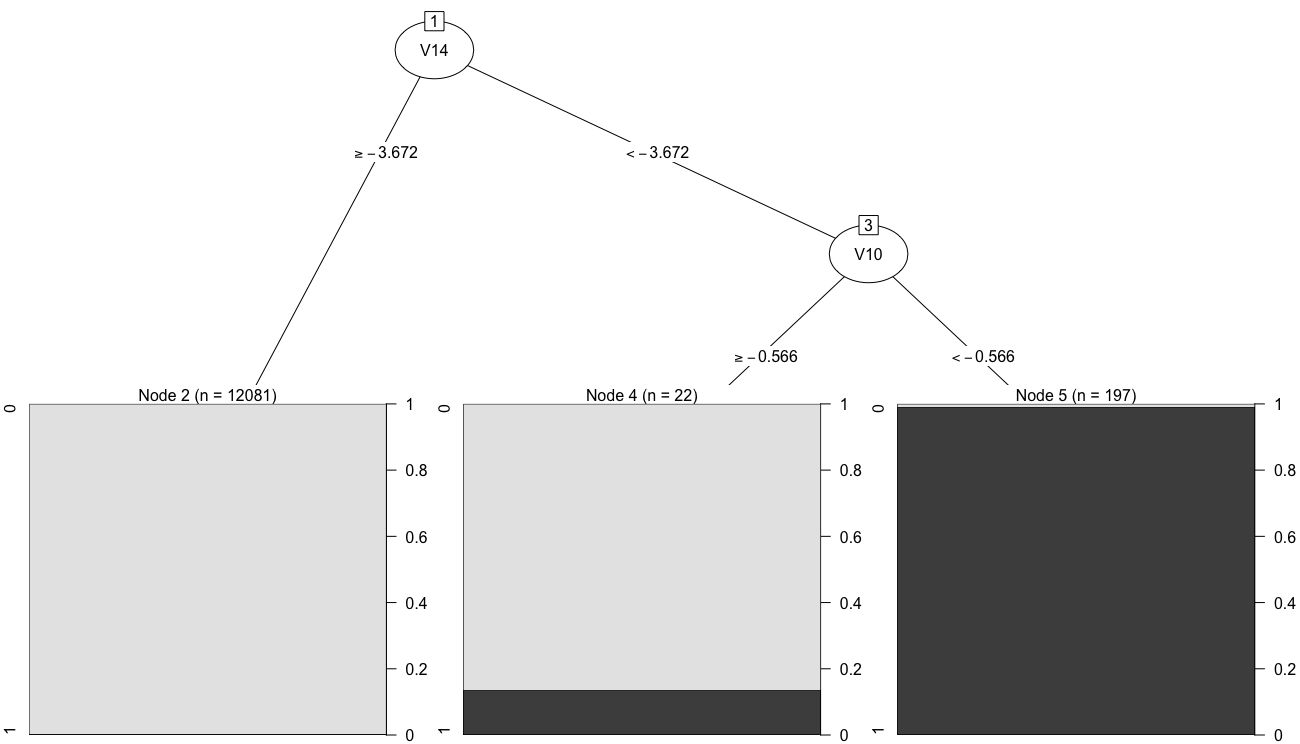
arbore1

Detecția fraudelor în R
## Predict fraud probability of test set
scores1 = predict(model1, newdata = test, type = "prob")[, 2]

## Predict class (fraud or not) of test set predicted_class1 = factor(ifelse(scores1 > 0.5, 1, 0))
## Confusion matrix & accuracy, library(caret) CM1 = confusionMatrix(data = predicted_class1, reference = test$Class)
          Reference         
Prediction     0     1
         0 12046    55
         1     8   191       Accuracy : 0.994878
library(pROC)
auc(roc(response = test$Class, predictor = scores1)) ## Area Under ROC Curve (AUC)
Area under the ROC curve: 0.8938
Detecția fraudelor în R

Aplicați SMOTE pe setul de antrenament

library(smotefamily)
set.seed(123)

smote_result = SMOTE(X = train[, -17],
                     target = train$Class,
                     K = 5,
                     dup_size = 10)

train_oversampled = smote_result$data colnames(train_oversampled)[17] = "Class"
prop.table(table(train_oversampled$Class))
        0         1 
0.8166667 0.1833333
Detecția fraudelor în R
library(rpart)
model2 = rpart(Class ~ ., data = train_oversampled)
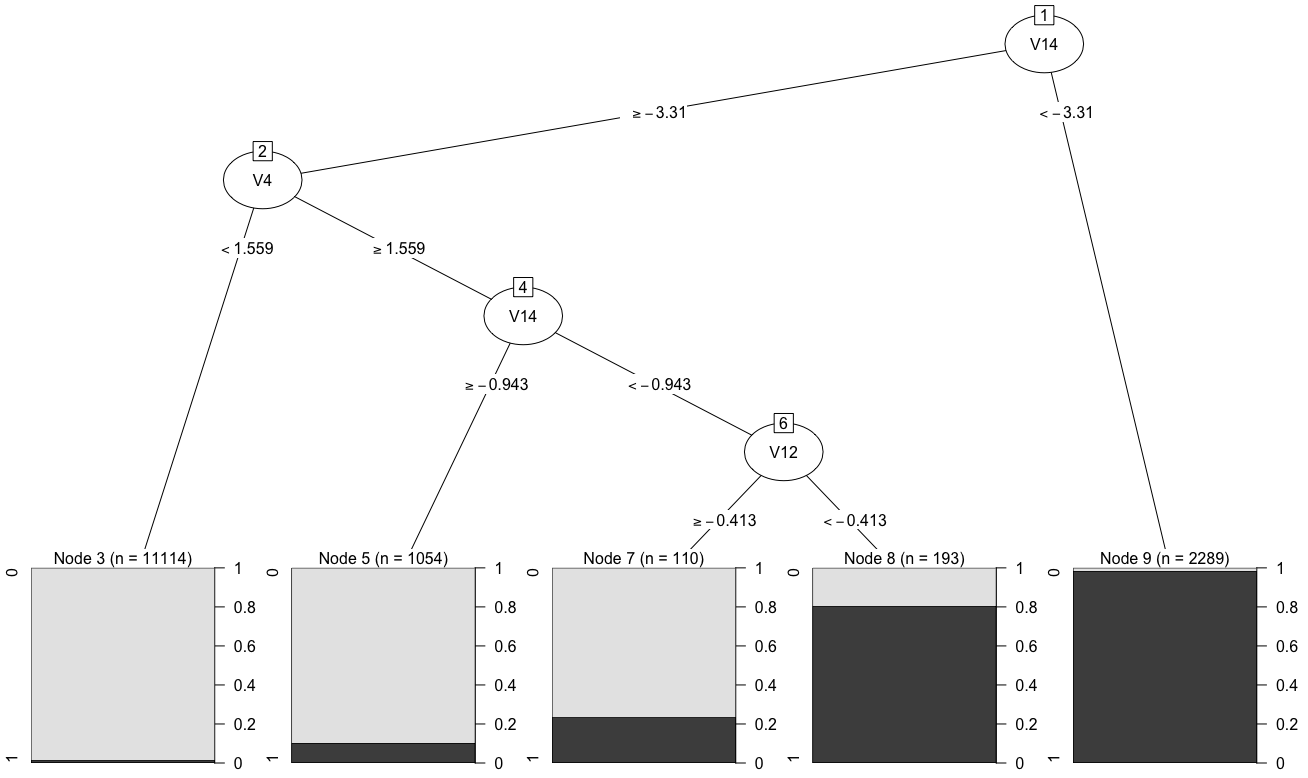
arbore2

Detecția fraudelor în R
## Predict fraud probability of test set
scores2 = predict(model2, newdata = test, type = "prob")[, 2]

## Predict class (fraud or not) of test set predicted_class2 = factor(ifelse(scores2 > 0.5, 1, 0))
## Confusion matrix & accuracy library(caret) CM2 = confusionMatrix(data = predicted_class2, reference = test$Class)
          Reference
Prediction     0     1
         0 11967    34
         1    87   212       Accuracy : 0.9901626                                
library(pROC)
auc(roc(response = test$Class, predictor = scores2)) ## Area Under ROC Curve (AUC)
Area under the curve: 0.9538
Detecția fraudelor în R

Costul implementării unui model de detecție

  • Luați în considerare costurile diferite ale detecției fraudei la evaluarea unui algoritm
  • Costurile sunt asociate cu
    • erori de clasificare (fals pozitive și fals negative) și
    • clasificări corecte (adevărat pozitive și adevărat negative)
Detecția fraudelor în R

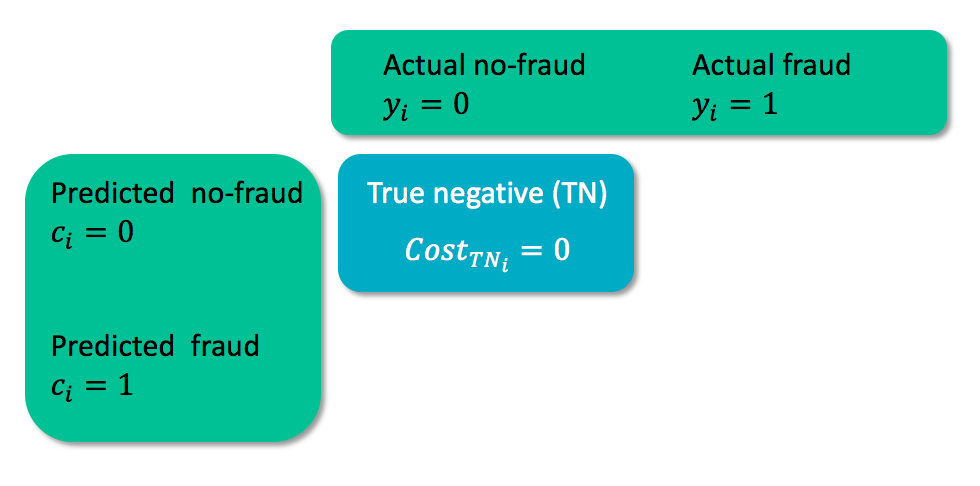
Matrice de cost

matrice_cost_1

  • $y_i$ = clasa reală a cazului $i$
  • $c_i$ = clasa prezisă pentru cazul $i$
Detecția fraudelor în R

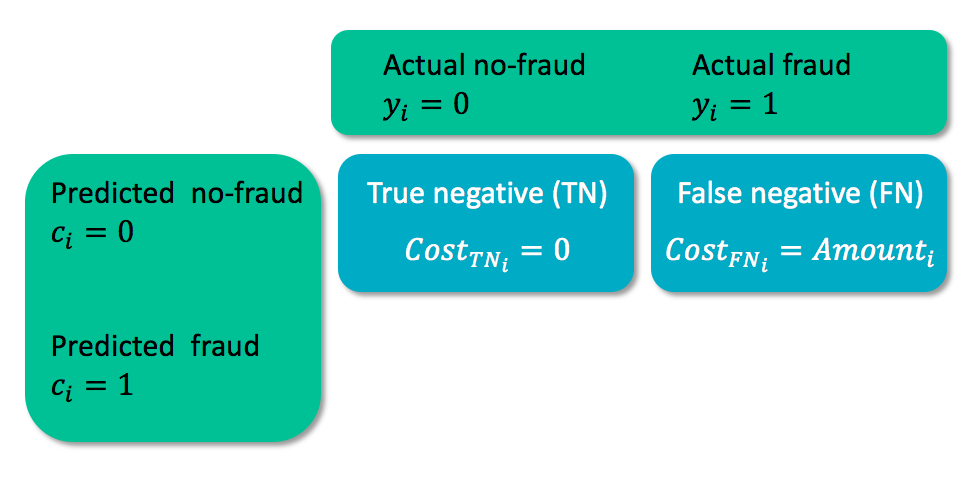
Matrice de cost

matrice_cost_2

  • $y_i$ = clasa reală a cazului $i$
  • $c_i$ = clasa prezisă pentru cazul $i$
Detecția fraudelor în R

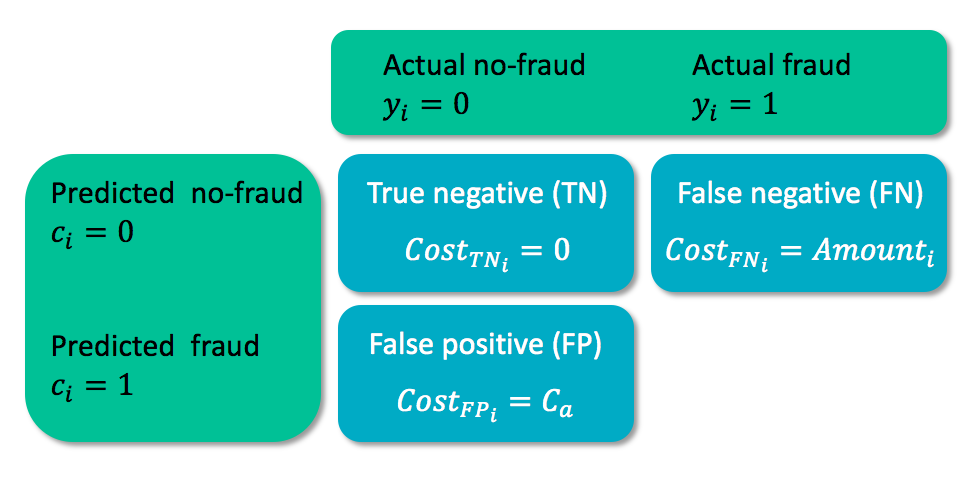
Matrice de cost

matrice_cost_3

  • $C_a$ = costul analizării cazului
Detecția fraudelor în R

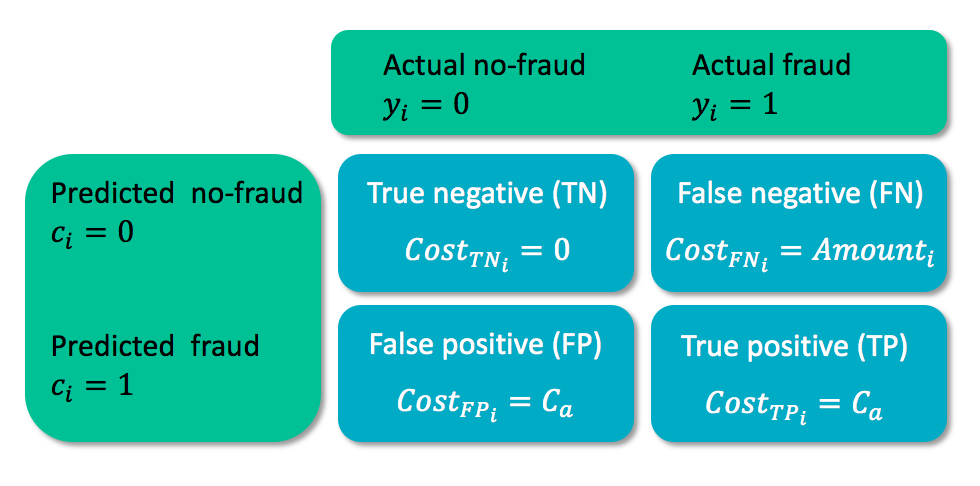
Matrice de cost

matrice_cost_4

  • $C_a$ = costul analizării cazului
Detecția fraudelor în R

Măsura de cost pentru un model de detecție

  • Luați în considerare costurile reale ale fiecărui caz: $$Cost(model)=\sum_{i=1}^{N}y_i(1-c_i)Amount_i + c_iC_a$$
    • $y_i$ = clasa reală a cazului $i$
    • $c_i$ = clasa prezisă pentru cazul $i$
cost_model = function(predicted.classes, true.classes, amounts, fixedcost) {

    cost = sum(true.classes * (1 - predicted.classes) * amounts +
               predicted.classes * fixedcost)

    return(cost)
}
Detecția fraudelor în R

Costul real al detecției fraudei

## Total cost without using SMOTE:
cost_model(predicted_class1, test$Class, test$Amount, fixedcost = 10)
10061.8
## Total cost when using SMOTE:
cost_model(predicted_class2, test$Class, test$Amount, fixedcost = 10)
7431.93
  • Pierderile scad cu 26%!
Detecția fraudelor în R

Să exersăm!

Detecția fraudelor în R

Preparing Video For Download...