Detecția fraudelor în R
Sebastiaan Höppner
PhD researcher in Data Science at KU Leuven
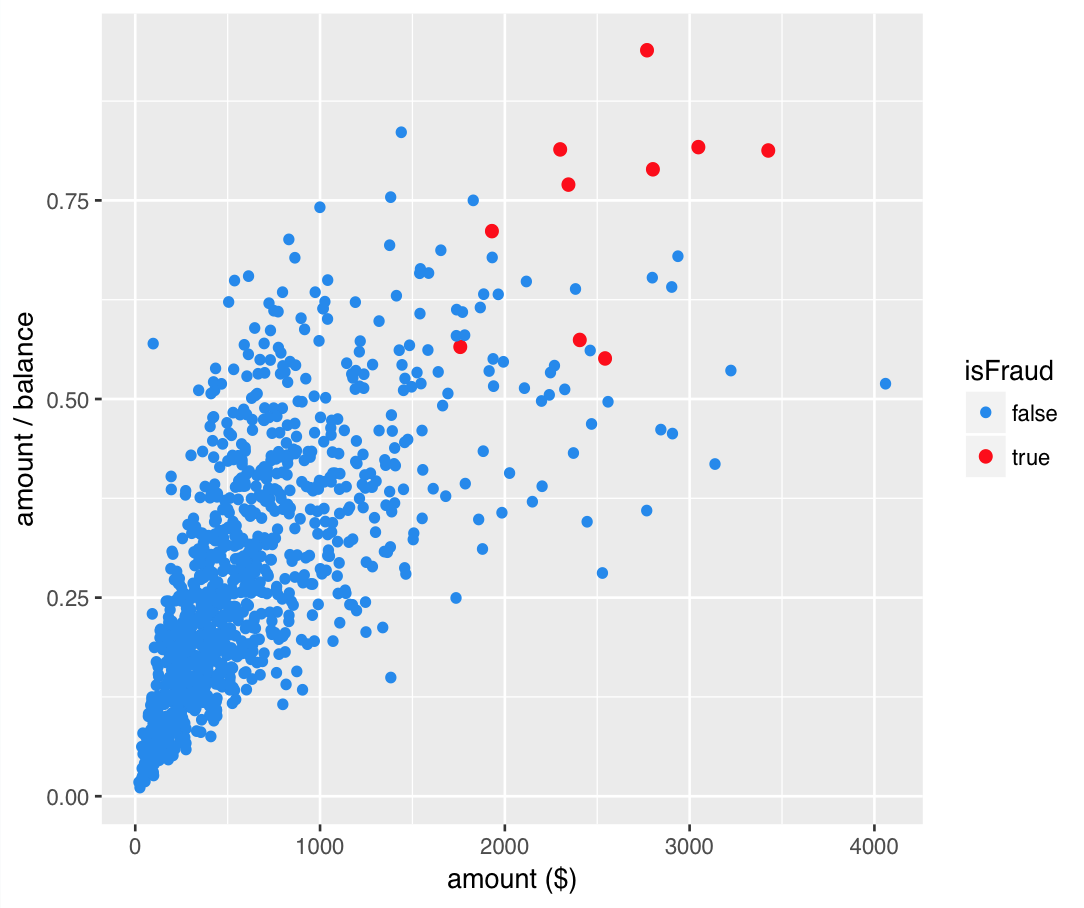
dim(transfer_data)
1000 4
head(transfer_data)
isFraud amount balance ratio
1 false 528.6840 1529.4732 0.3456641
2 false 184.0193 836.3509 0.2200265
3 false 1885.8024 2984.0684 0.6319568
4 false 732.0286 1248.7217 0.5862224
prop.table(table(transfer_data$isFraud))
false true
0.99 0.01


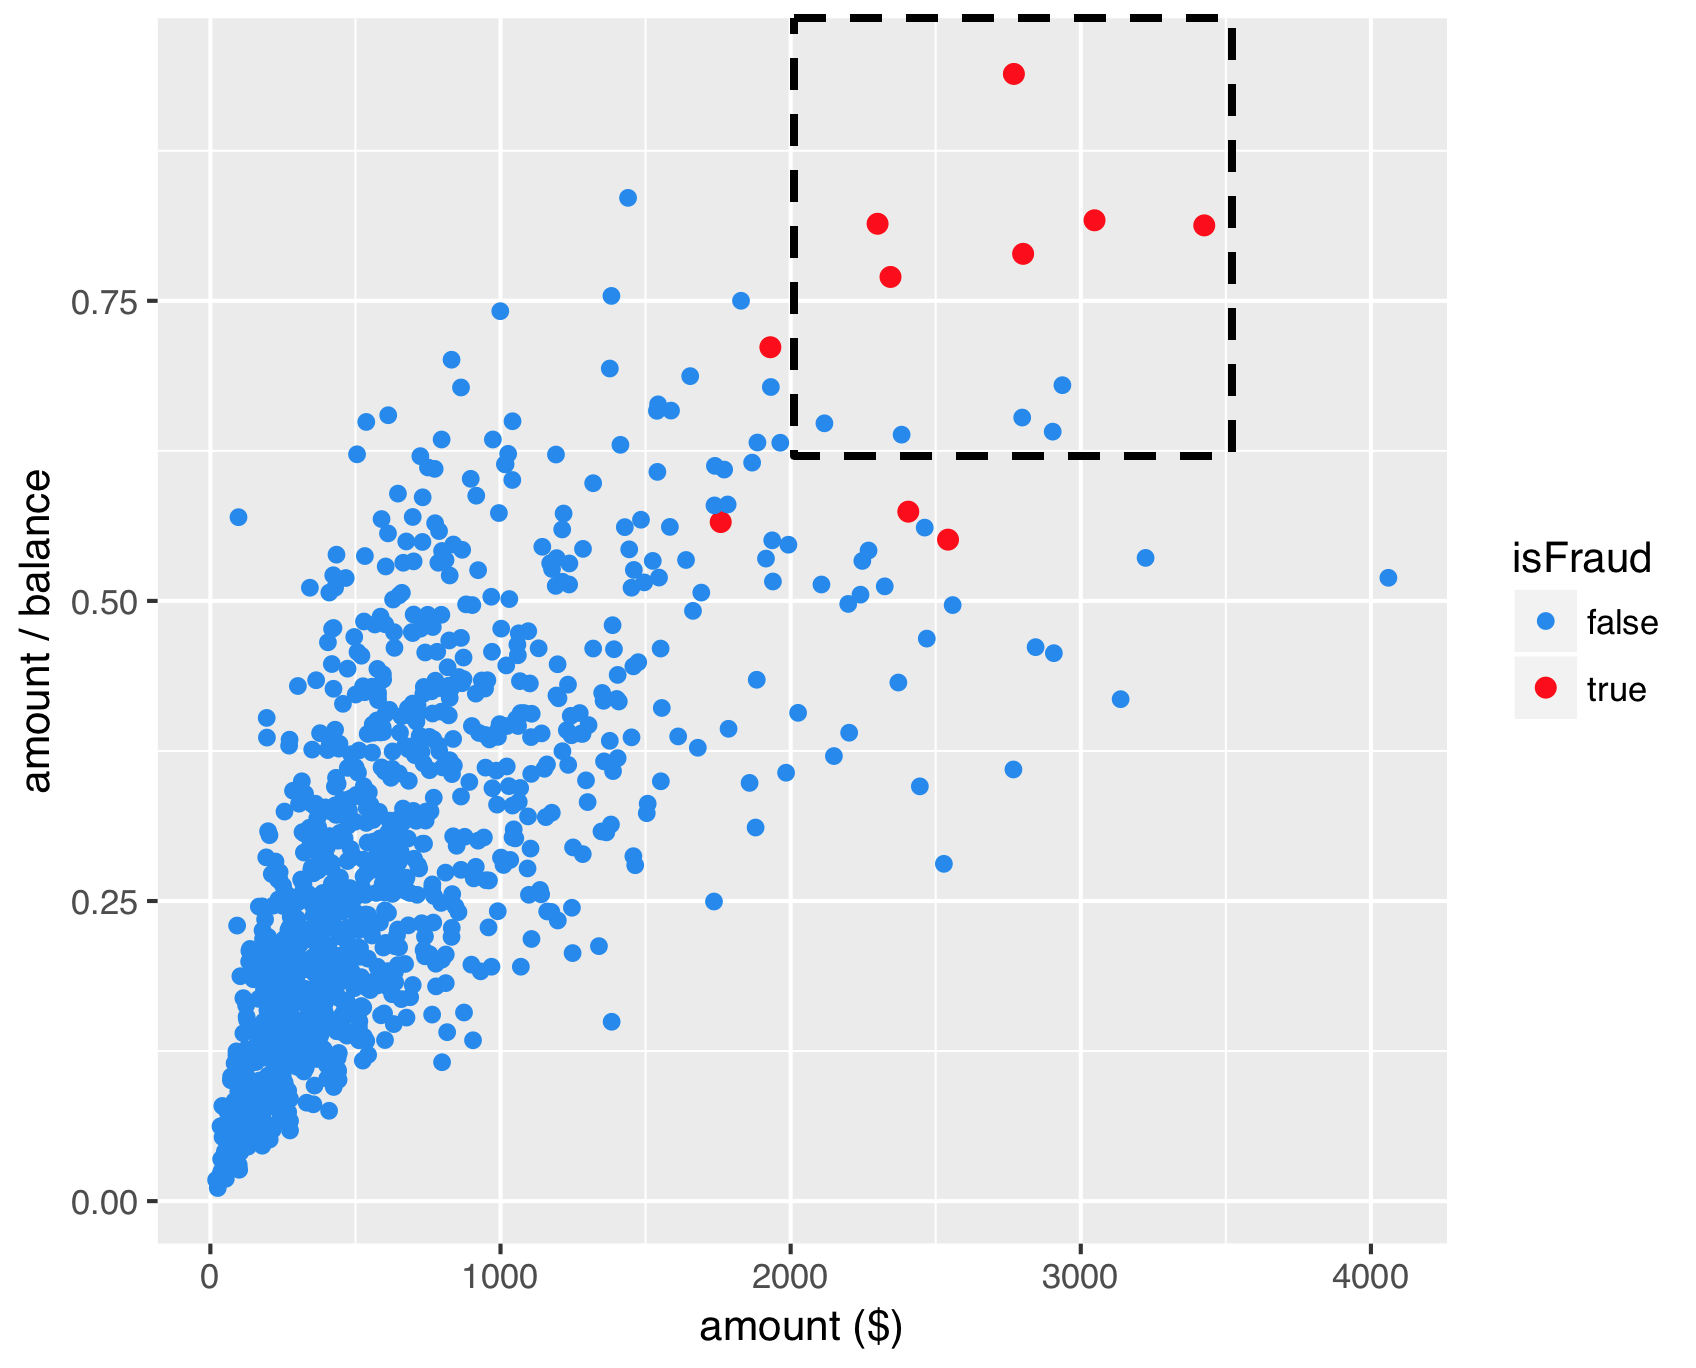
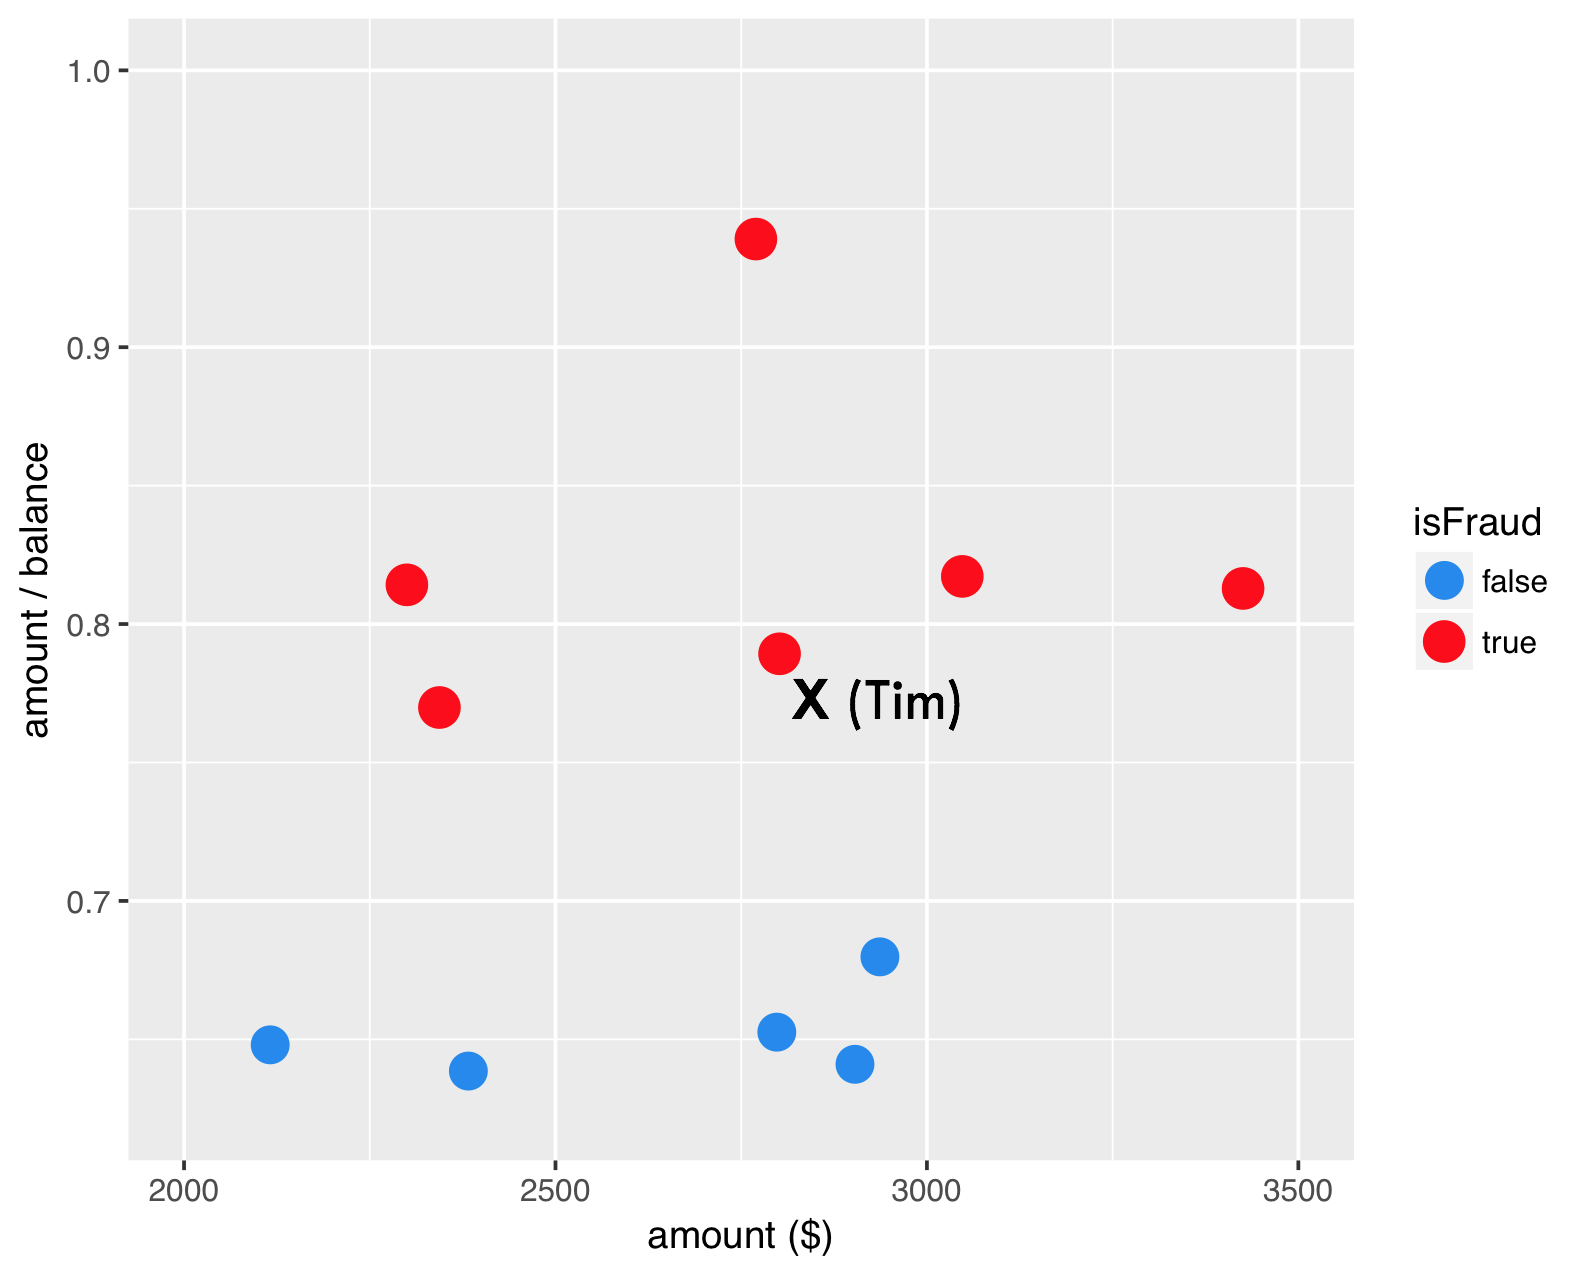
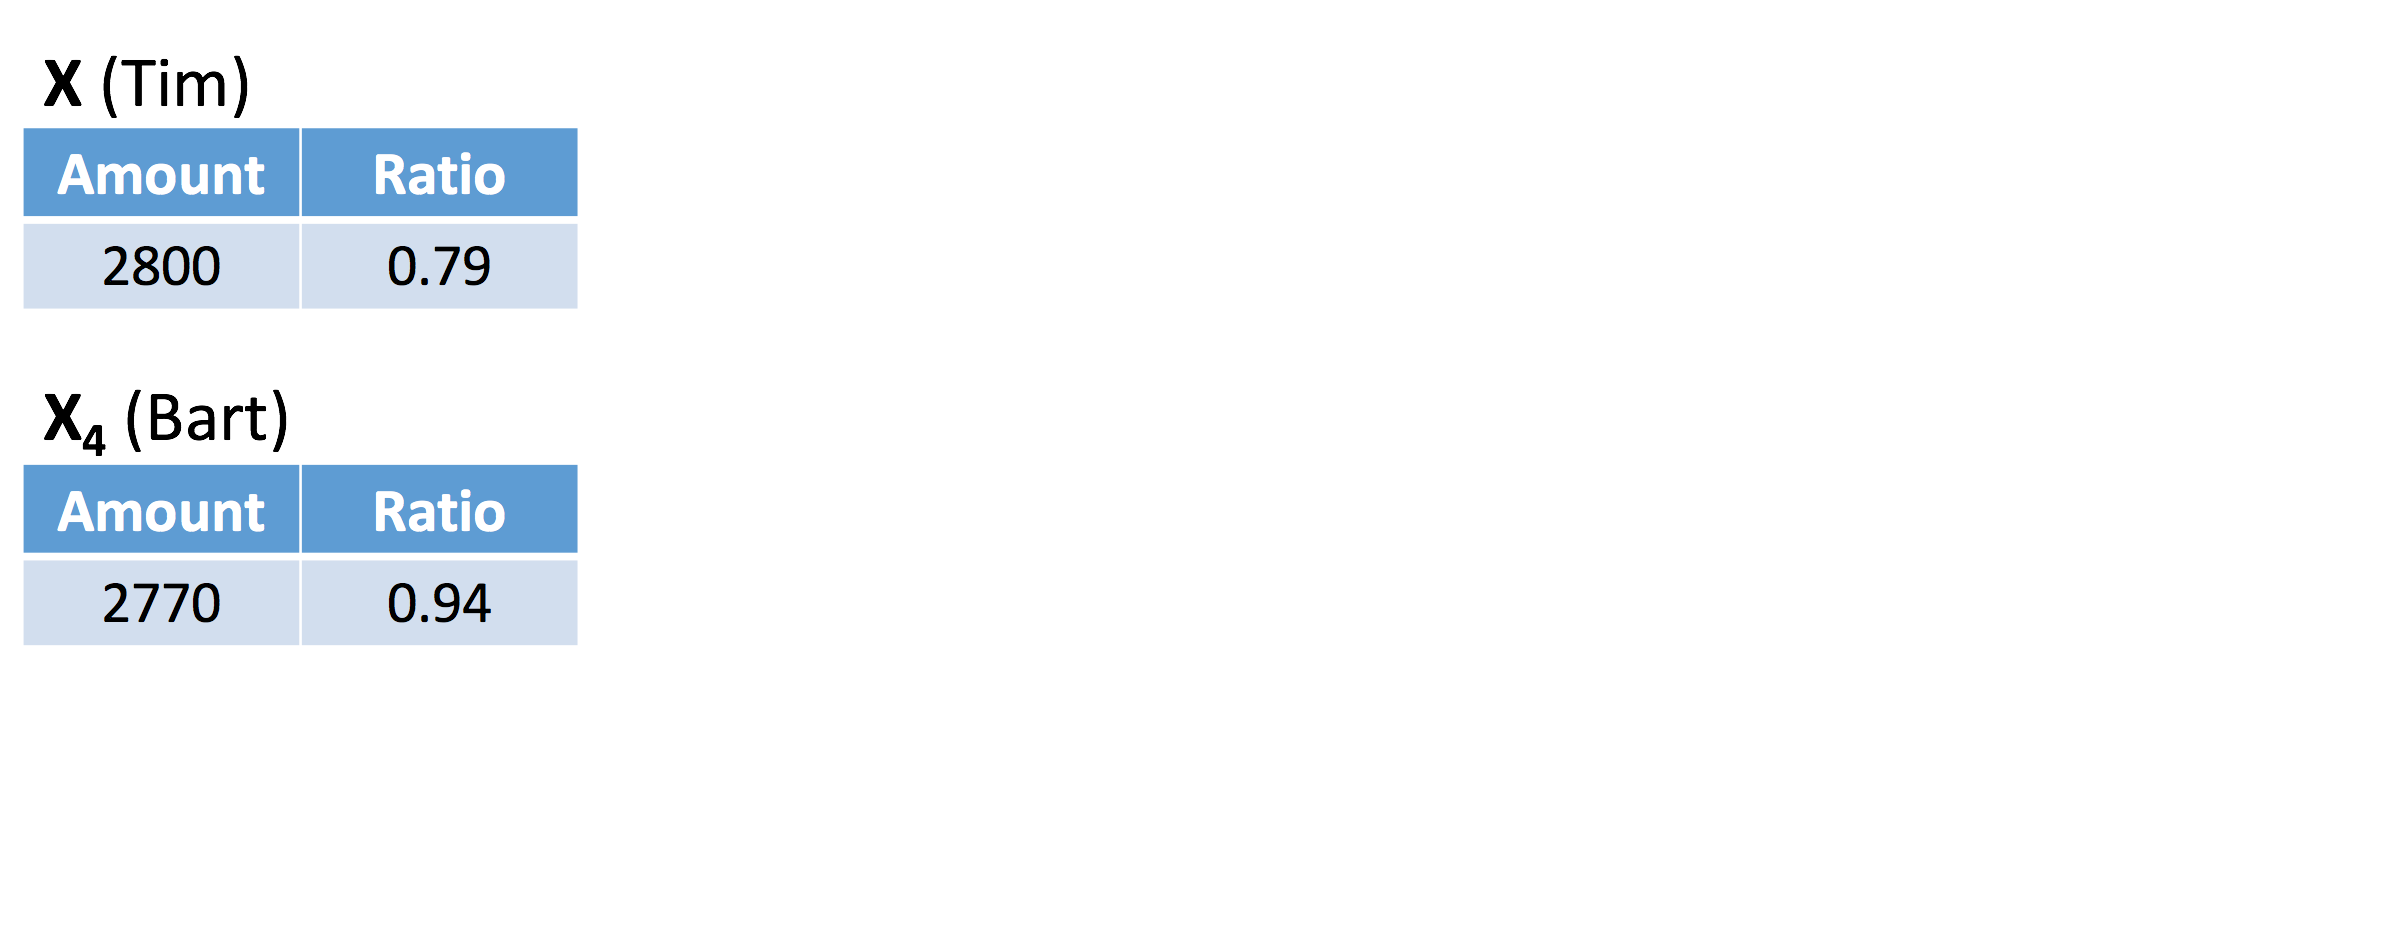
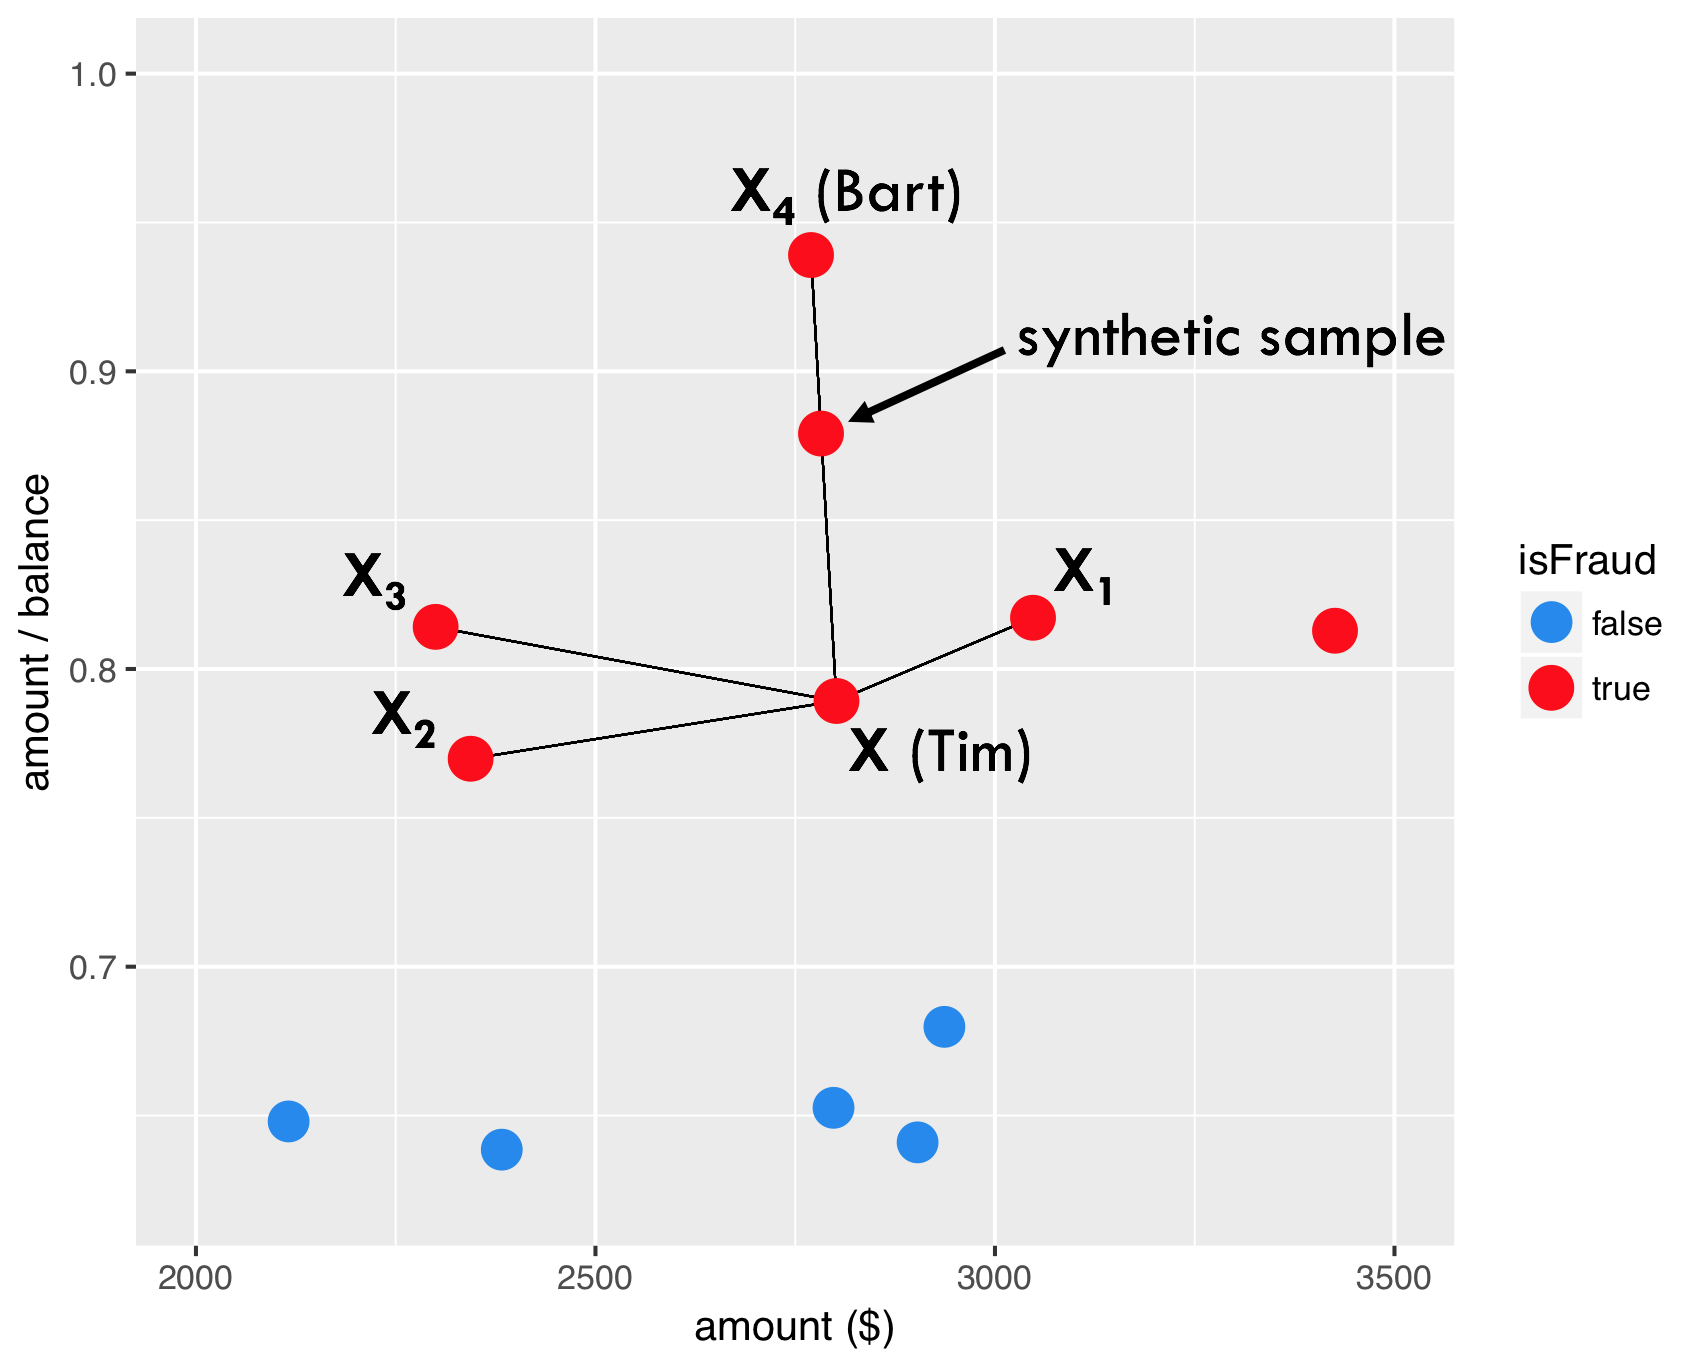
Să selectăm un caz de fraudă X (Tim)

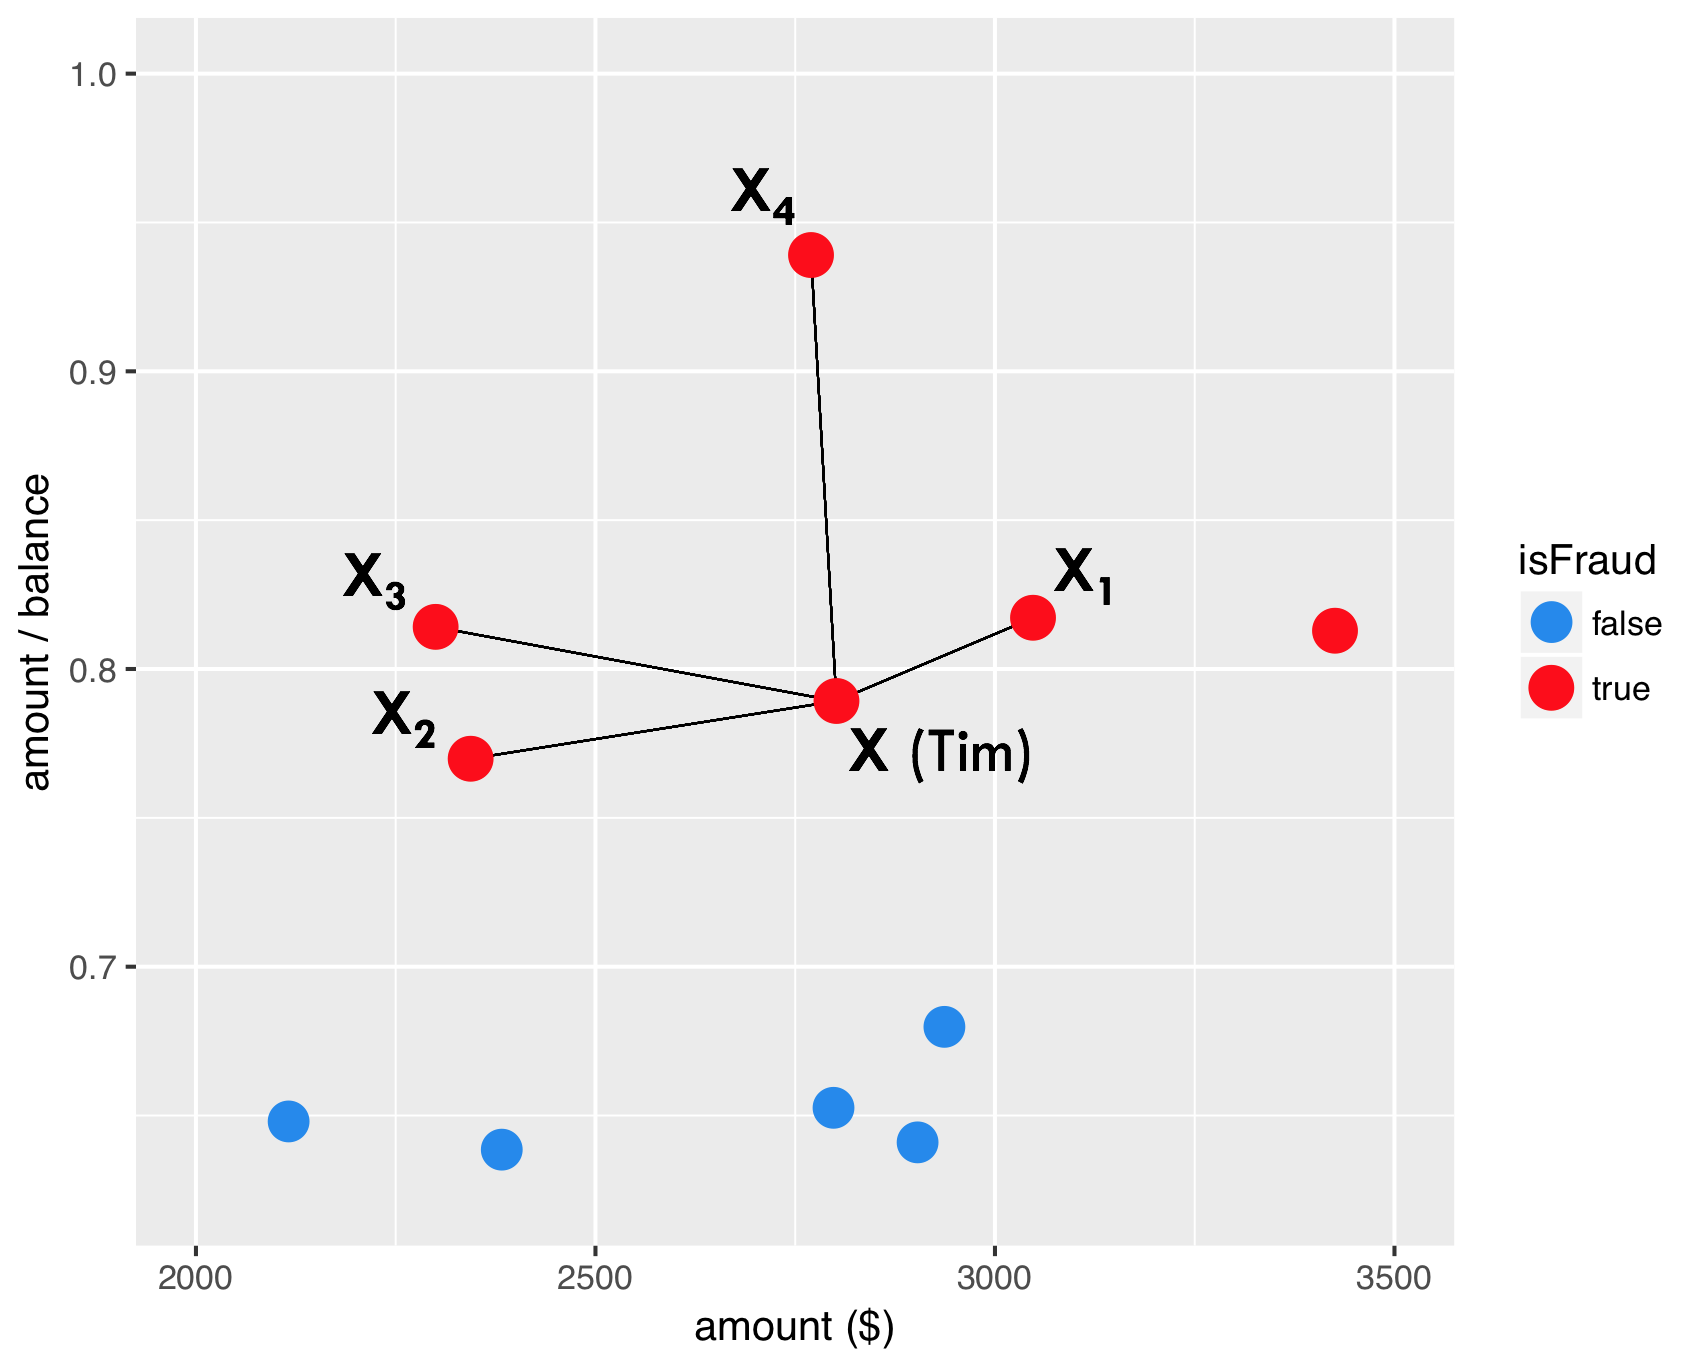
Pasul 1
Găsiți cei mai apropiați K vecini
frauduloși ai lui X (Tim)
e.g. K = 4

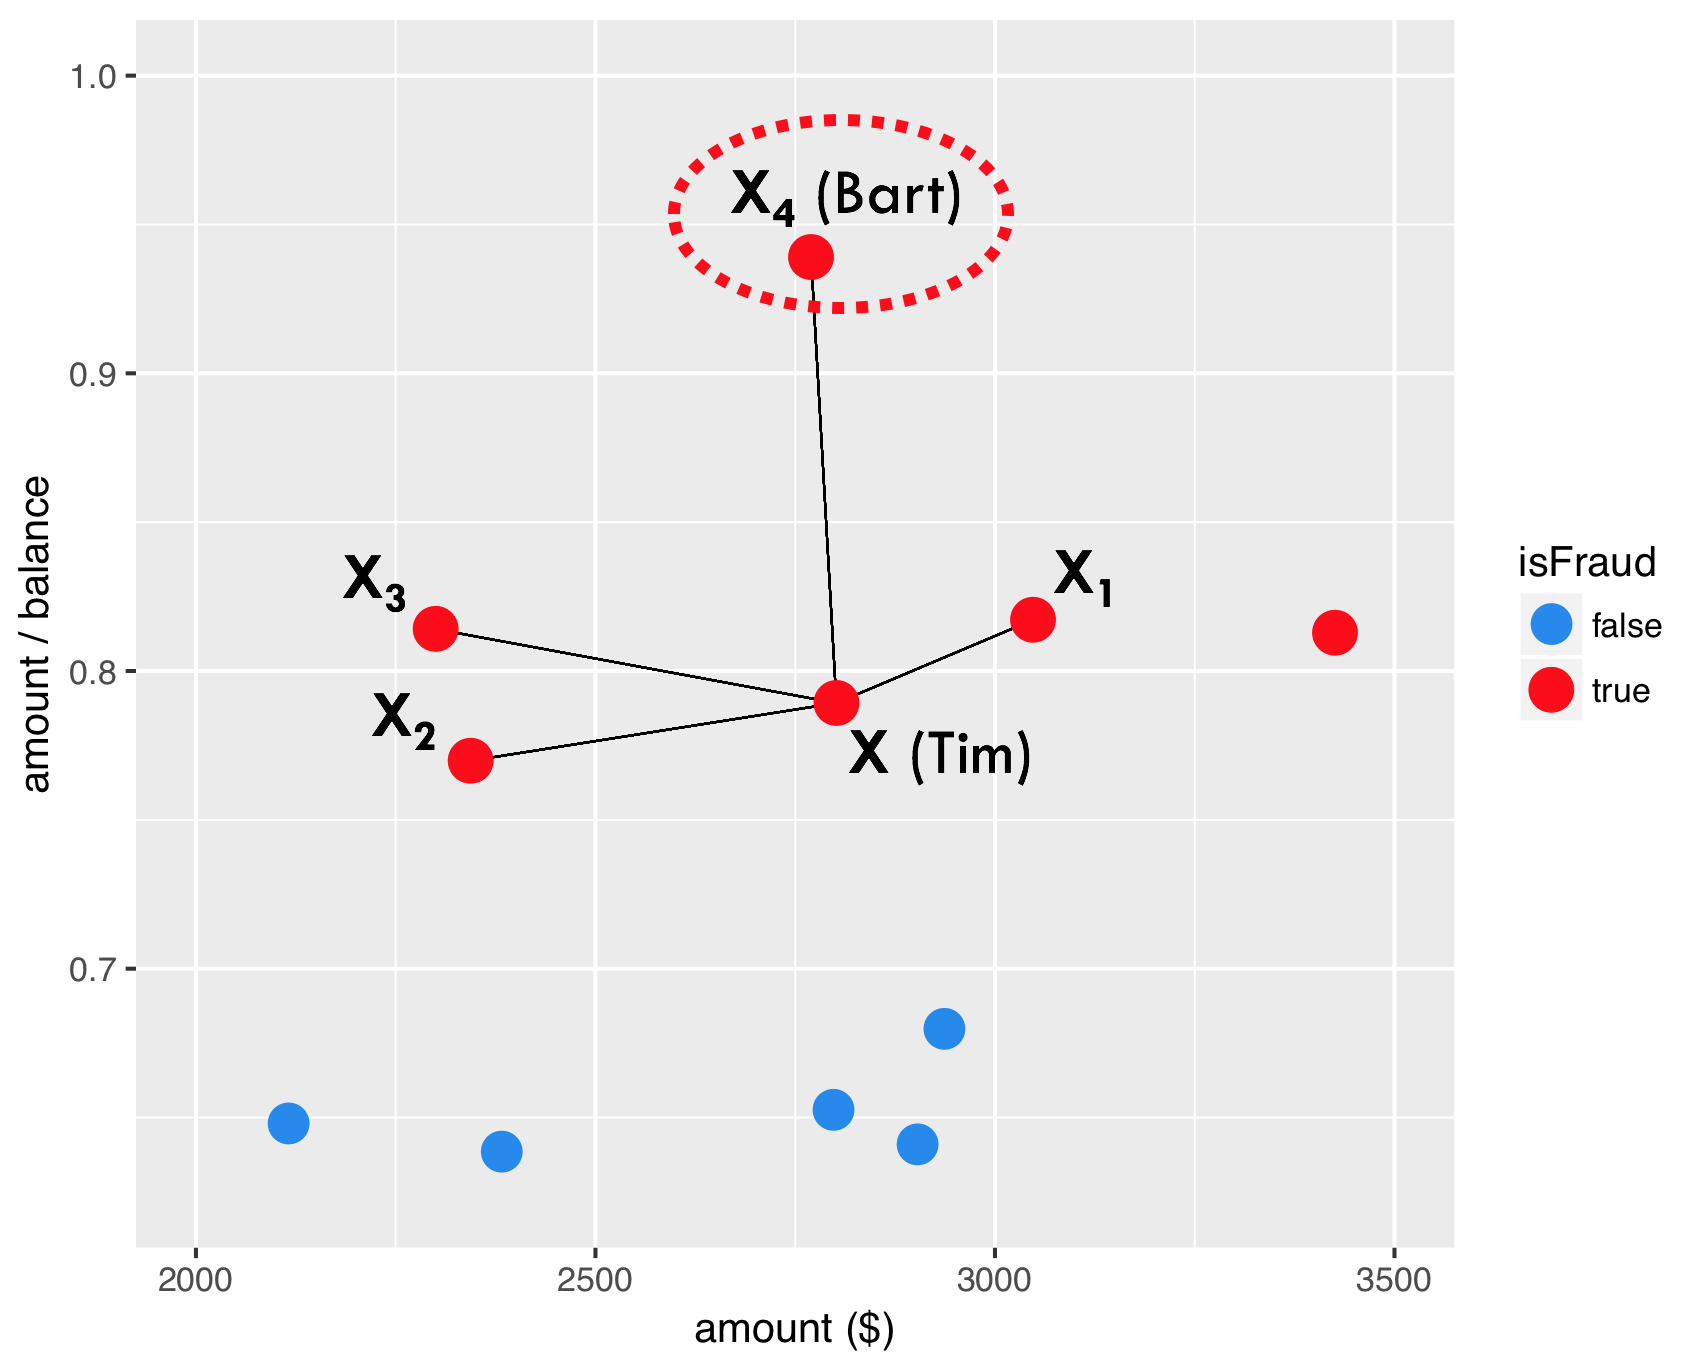
Pasul 2
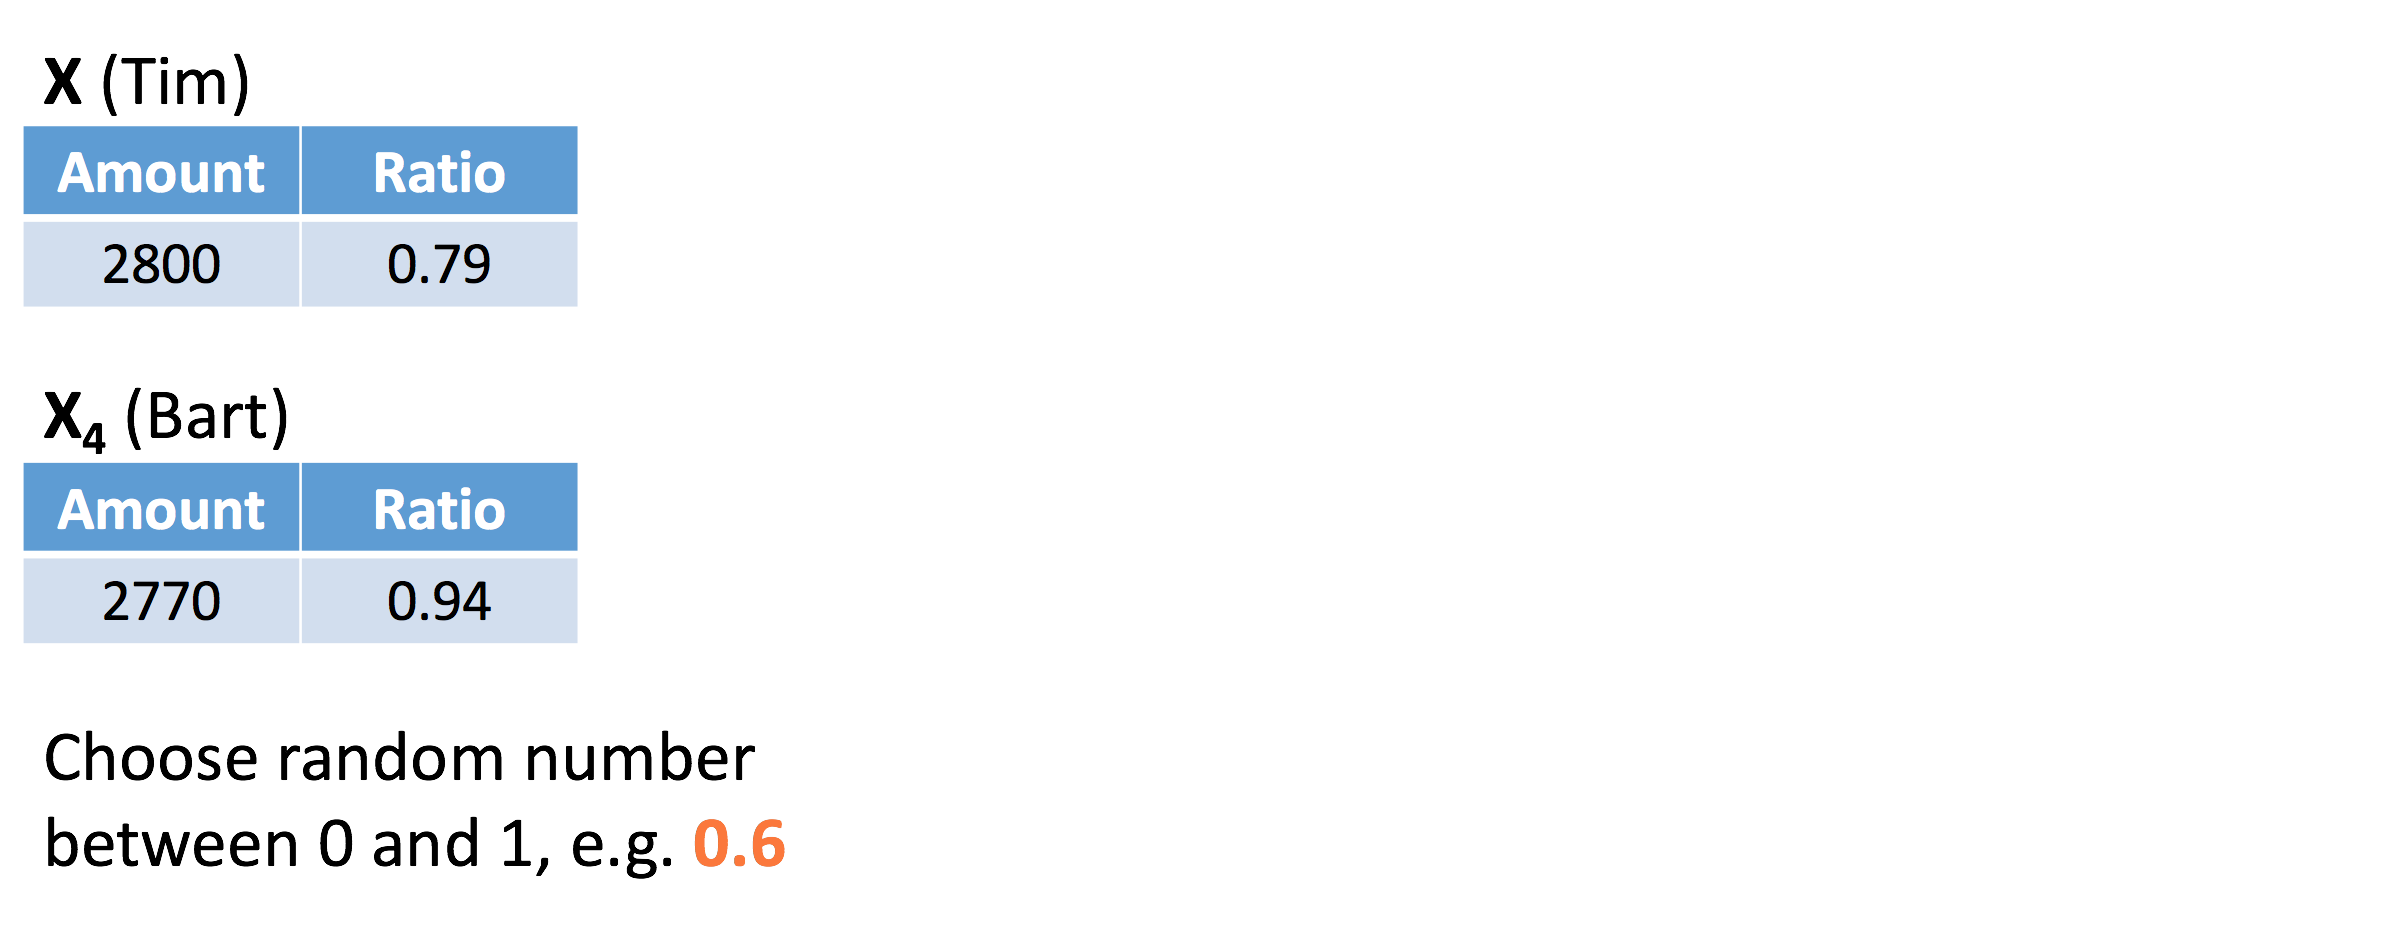
Alegeți aleatoriu un vecin apropiat al lui Tim
e.g. X4 (Bart)

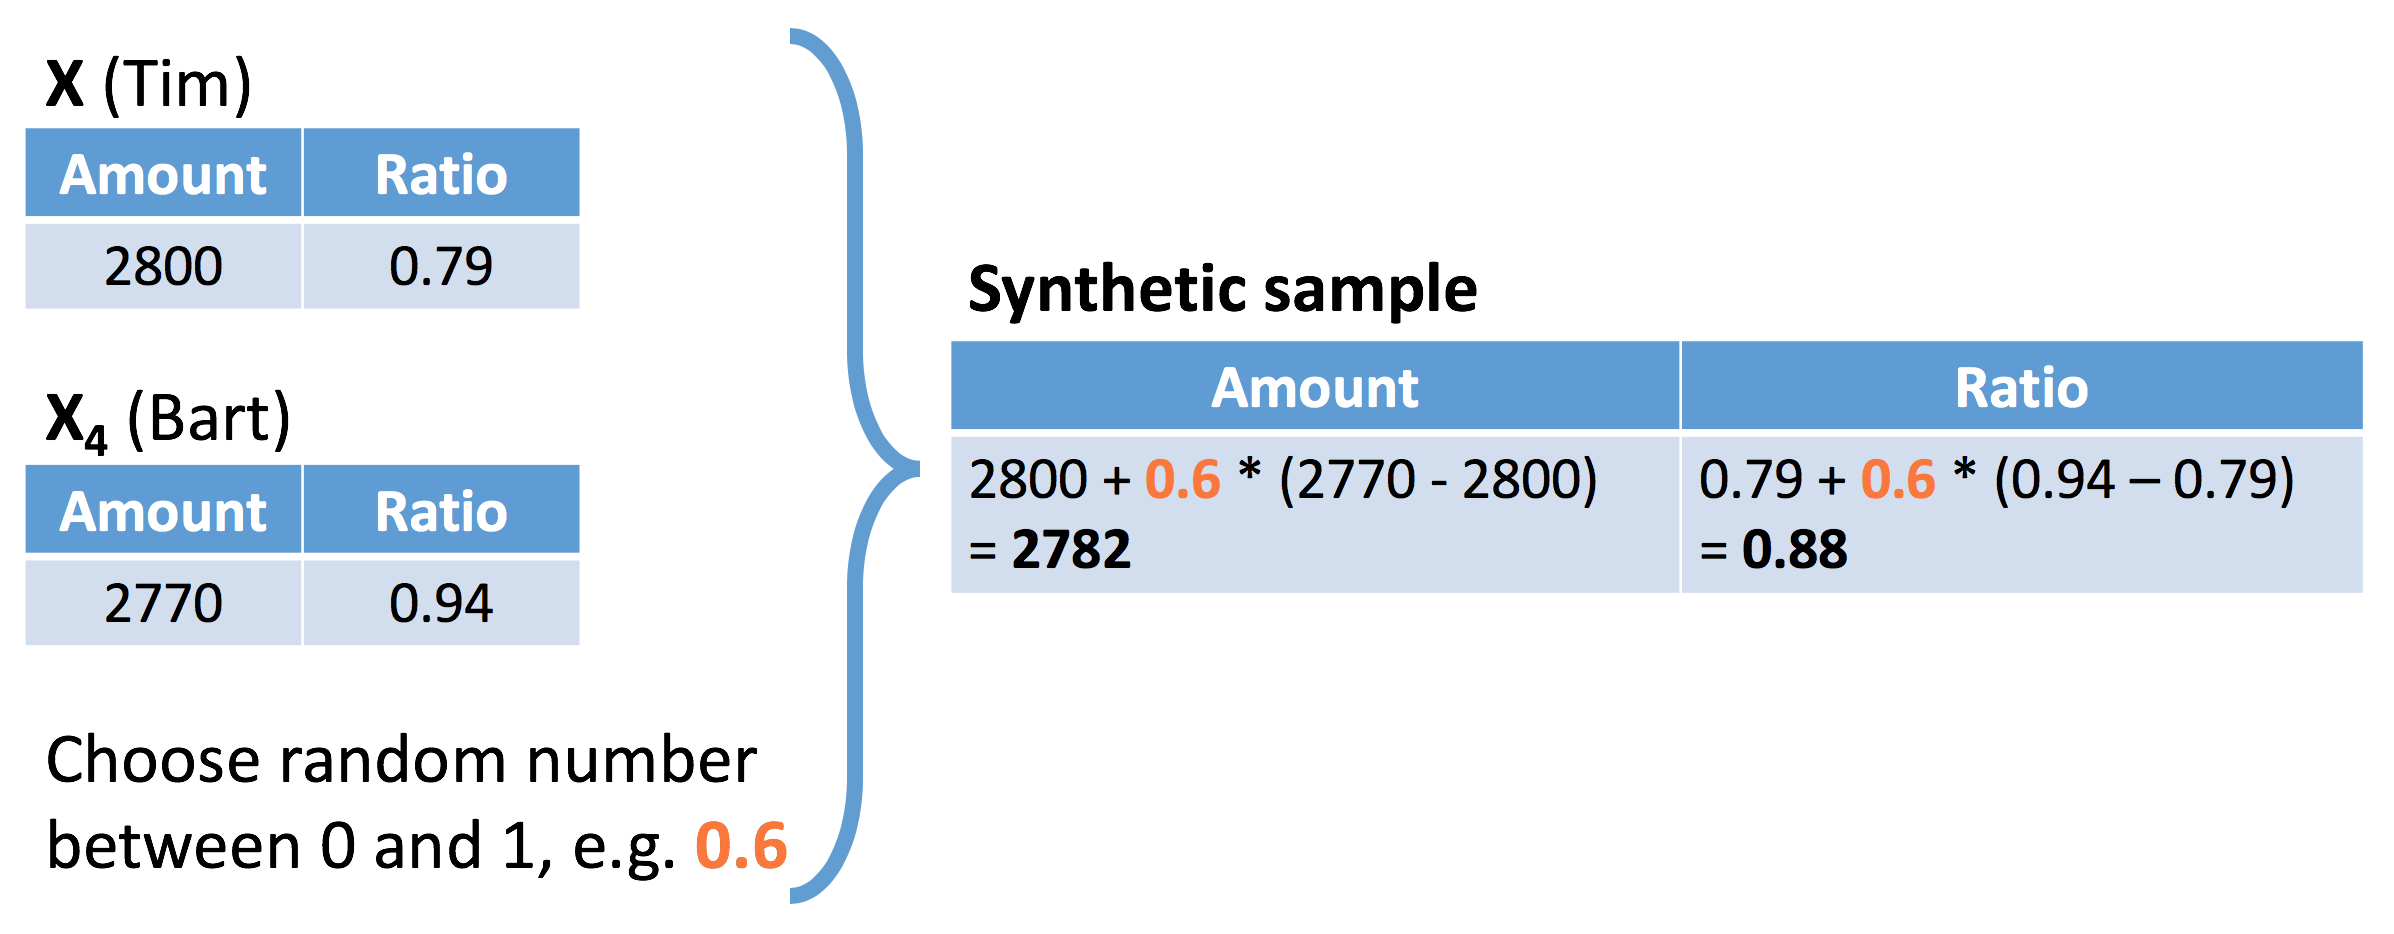
Pasul 3 : creați un eșantion sintetic

Pasul 3 : creați un eșantion sintetic

Pasul 3 : creați un eșantion sintetic


Pasul 4
Repetați pașii 1-3 pentru fiecare caz de fraudă
de dup_size ori
e.g. dup_size = 10

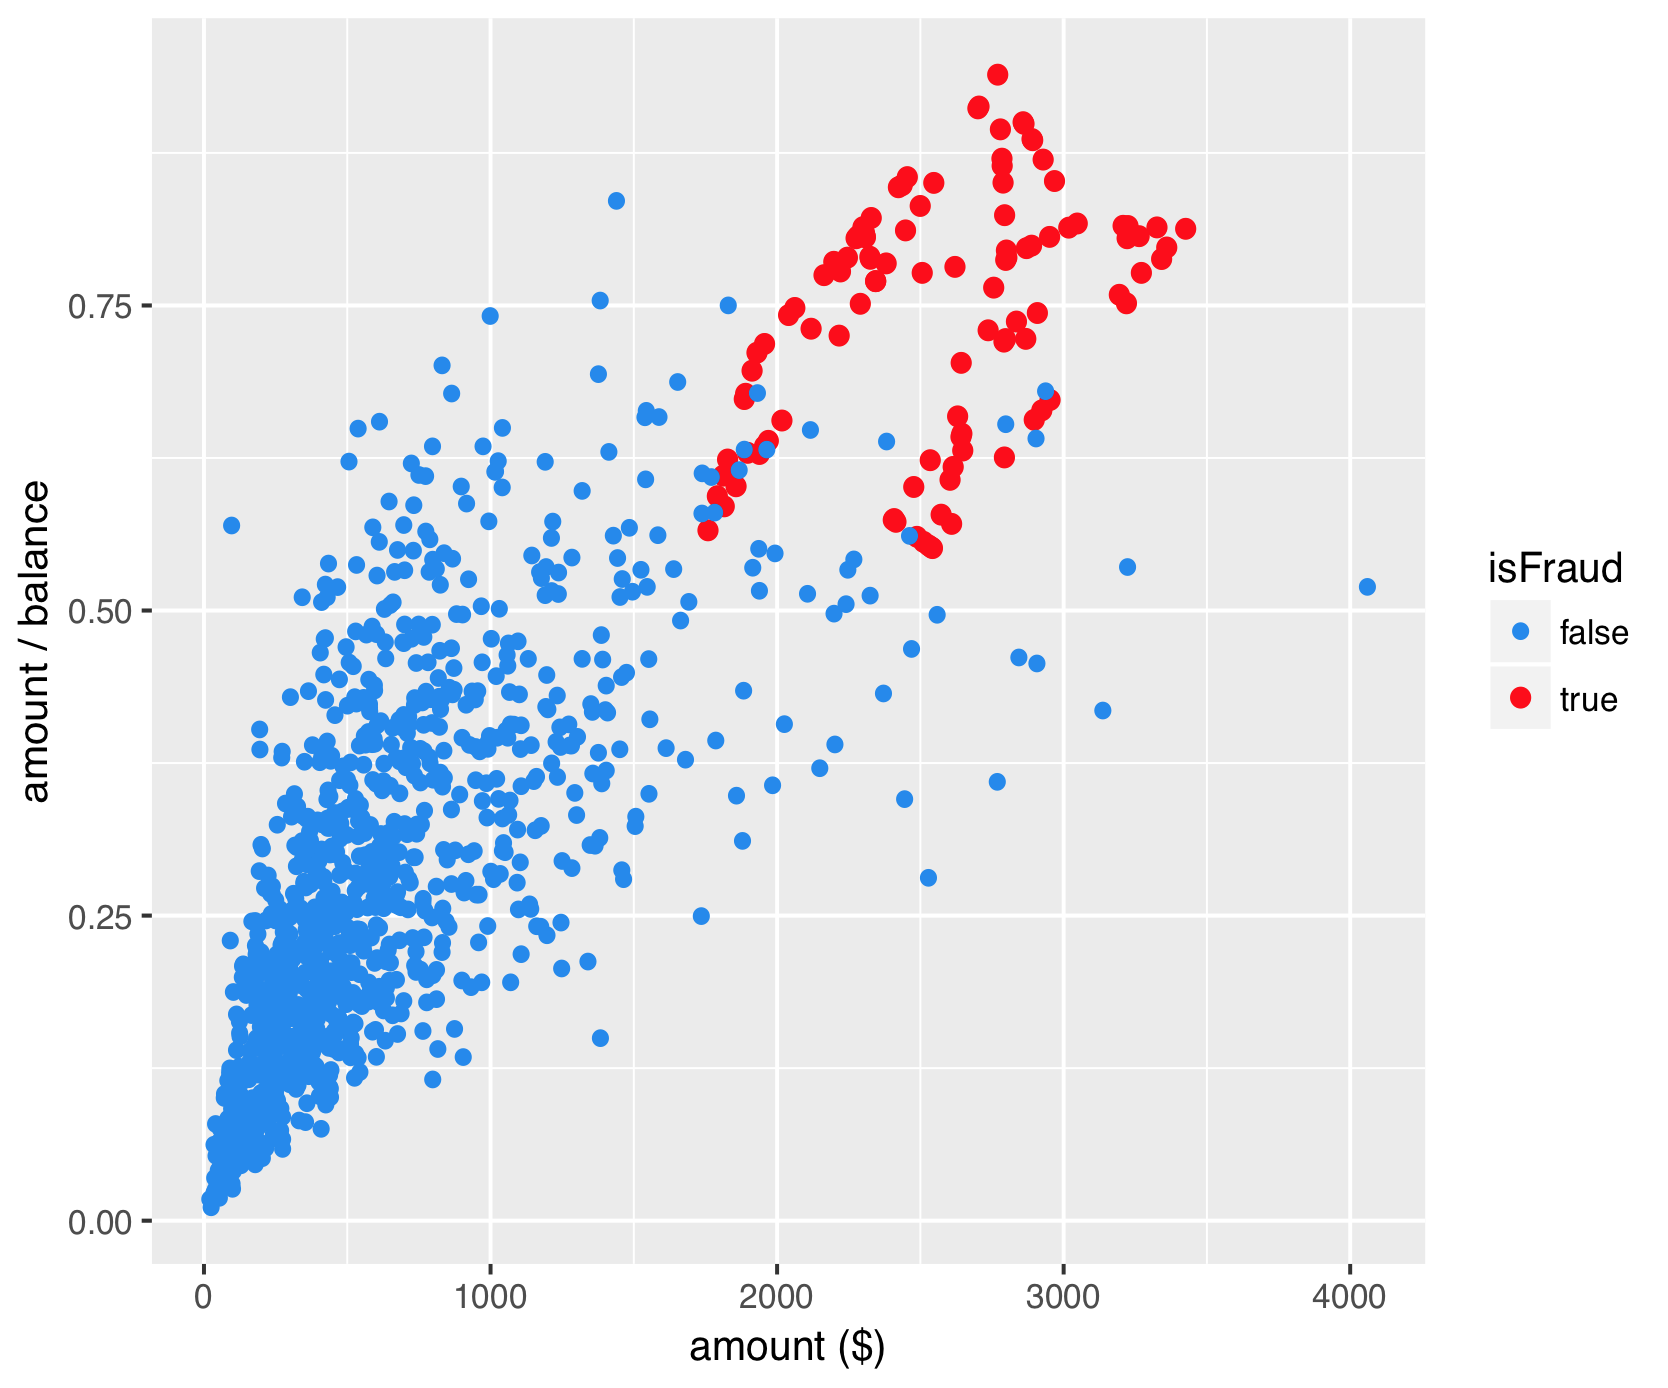
library(smotefamily) smote_output = SMOTE(X = transfer_data[, -1], target = transfer_data$isFraud, K = 4, dup_size = 10)oversampled_data = smote_output$datatable(oversampled_data$isFraud)
false true
990 110
prop.table(table(oversampled_data$isFraud))
false true
0.9 0.1

Detecția fraudelor în R