Caracteristici temporale

Detecția fraudelor în R

Bart Baesens

Professor Data Science at KU Leuven

Analiza timpului

  • Anumite evenimente sunt așteptate să apară la momente similare în timp
  • Exemplu: un client efectuează tranzacții la ore similare
  • Scop: capturarea informațiilor despre aspectul temporal prin caracteristici relevante
  • Lucrul cu timpul poate fi dificil
    • 00:00 = 24:00
    • Fără ordonare naturală, de exemplu 23:00 $<$ sau $>$ 01:00?
Detecția fraudelor în R
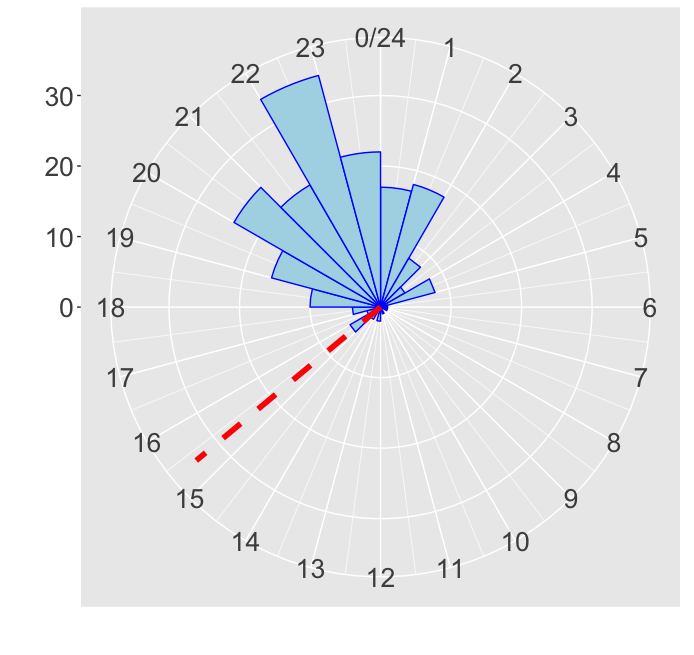
  • Nu utilizați media aritmetică pentru a calcula un marcaj temporal mediu!
    • Exemplu: o tranzacție a fost efectuată la 01:00, 02:00, 21:00 și 22:00
    • Media aritmetică este 11:30, dar nicio tranzacție nu a avut loc aproape de acel moment!
head(timestamps)
"20:27:28" "21:08:41" "01:30:16" "00:57:04" "23:12:14" "22:54:16"
  • Convertiți marcajele temporale digitale în format zecimal în ore
library(lubridate)
ts <- as.numeric(hms(timestamps)) / 3600

head(ts)
20.4577778 21.1447222  1.5044444  0.9511111 23.2038889 22.9044444
Detecția fraudelor în R

Histogramă circulară

library(ggplot2)

clock <- ggplot(data.frame(ts), aes(x = ts)) +
    geom_histogram(breaks = seq(0, 24), colour = "blue", fill = "lightblue") +
    coord_polar()


arithmetic_mean <- mean(ts) clock + geom_vline(xintercept = arithmetic_mean, linetype = 2, color = "red", size = 2)
Detecția fraudelor în R

Histogramă circulară cu medie aritmetică

histogramă circulară incorectă

Detecția fraudelor în R

Distribuția de probabilitate von Mises

  • Modelarea timpului ca variabilă periodică folosind distribuția von Mises (Correa Bahnsen et al., 2016)
  • Distribuție normală periodică = distribuție normală înfășurată pe un cerc
  • Distribuția von Mises a unui set de marcaje temporale $D= $ {$t_1, t_2, \ldots, t_n$}

$$D\sim vonMises\left(\mu,\kappa\right)$$

  • $\mu$ : medie periodică, măsură a locației; distribuția este concentrată în jurul lui $\mu$
  • $1/\kappa$ : varianță periodică; $\kappa$ este o măsură a concentrației
Detecția fraudelor în R

Estimarea parametrilor $\mu$ și $\kappa$

# Convert the decimal timestamps to class "circular"
library(circular)
ts <- circular(ts, units = "hours", template = "clock24")

head(ts)
Circular Data: 
[1] 20.457889 21.144607  1.504422  0.950982 23.203917  4.904397
estimates <- mle.vonmises(ts)
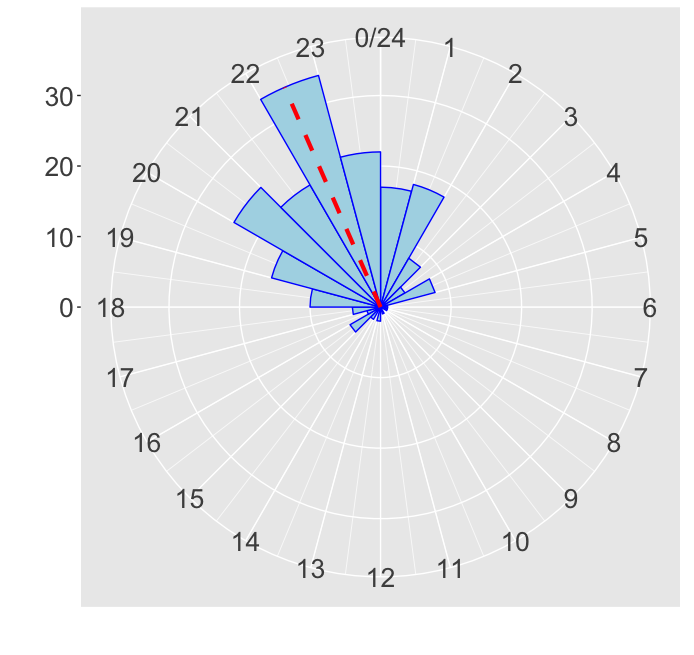
p_mean <- estimates$mu %% 24
concentration <- estimates$kappa
Detecția fraudelor în R

Histogramă circulară cu medie periodică

histogramă circulară corectă

Detecția fraudelor în R

Interval de încredere

  • Extragerea de noi caracteristici: interval de încredere pentru momentul unei tranzacții
  • $S= $ {$x_i^{time}|i=1,\ldots,n$} : mulțimea tranzacțiilor aceluiași client

(1) Estimați $\mu(S)$ și $\kappa(S)$ pe baza $S$ cu mle.vonmises():

estimates <- mle.vonmises(ts)
p_mean <- estimates$mu %% 24
concentration <- estimates$kappa

(2) Calculați densitatea (= probabilitatea) marcajelor temporale cu dvonmises():

densities <- dvonmises(ts, mu = p_mean, kappa = concentration)
Detecția fraudelor în R

Extragerea caracteristicilor

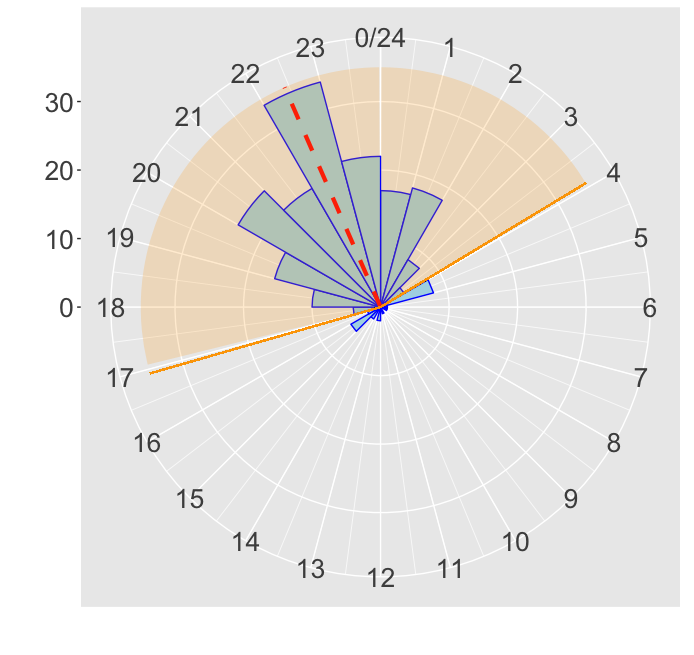
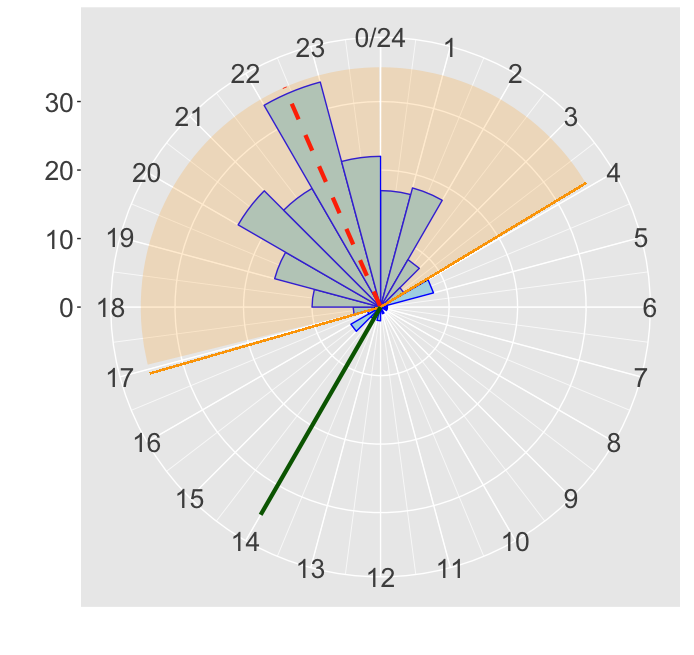
  • Caracteristică binară: marcajul temporal al unei tranzacții noi se află sau nu în intervalul de încredere (IC) cu probabilitatea $\alpha$ (ex. 0,90, 0,95)
  • Caracteristica temporală binară este TRUE dacă marcajul se află în IC și FALSE în caz contrar
  • Marcajul se află în IC de 90% dacă densitatea sa este mai mare decât valoarea limită:
alpha <- 0.90
quantile <- qvonmises(p = (1 - alpha)/2, 
                        mu = p_mean,
                        kappa = concentration) %% 24
cutoff <- dvonmises(quantile,
                      mu = p_mean, kappa = concentration)

time_feature <- densities >= cutoff
Detecția fraudelor în R

Interval de încredere

ceas interval de încredere

Detecția fraudelor în R

Interval de încredere

ceas interval de încredere 2

Detecția fraudelor în R

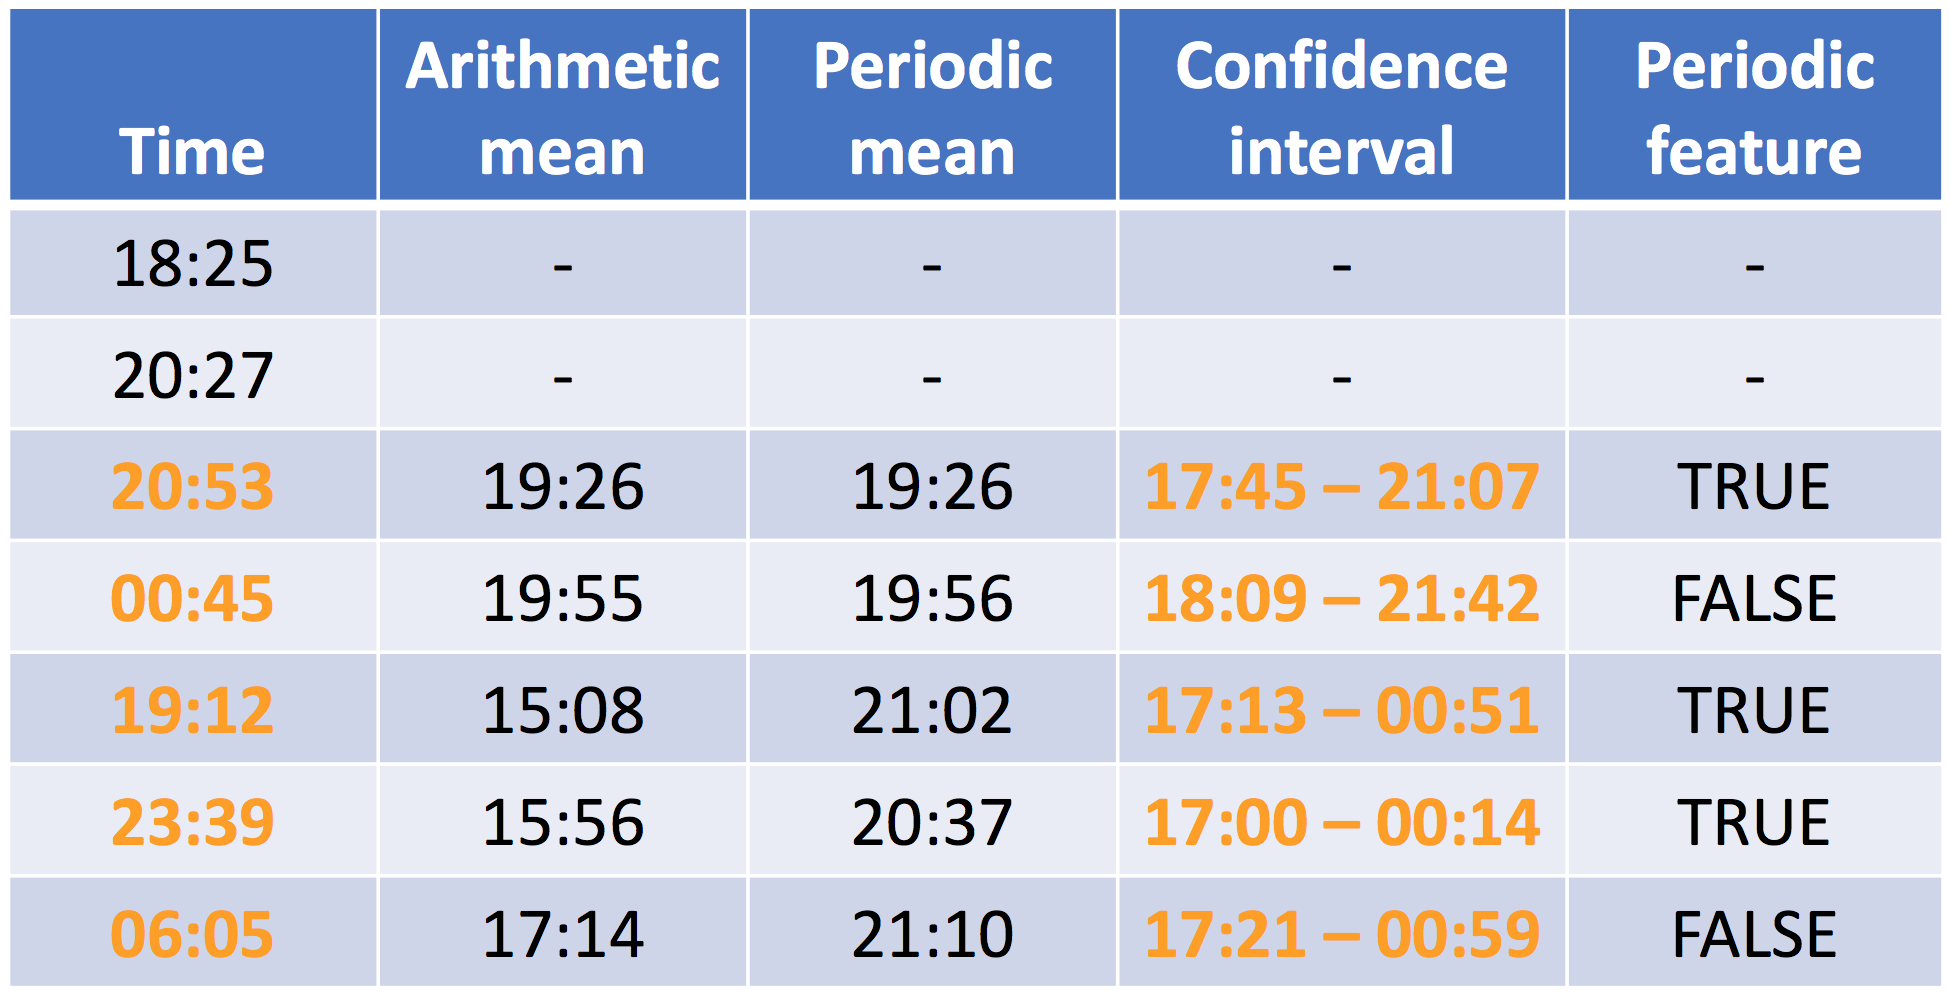
Exemplu

$$ $$ tabel temporal

Detecția fraudelor în R

Interval de încredere cu fereastră temporală mobilă

## ts contains the timestamps 18.42, 20.45, 20.88, 0.75, 19.20, 23.65 and 6.08

time_feature = c(NA, NA) for (i in 3:length(ts)) { ts_history <- ts[1:(i-1)] ## (1) Previous timestamps
estimates <- mle.vonmises(ts_history) ## (2) Estimate mu and kappa on historic timestamps p_mean <- estimates$mu %% 24 concentration <- estimates$kappa
dens_i <- dvonmises(ts[i], mu = p_mean, kappa = concentration) ## (3) Estimate density of current timestamp
alpha <- 0.90 ## (4) Check if density is larger than cutoff with confidence level 90% quantile <- qvonmises((1-alpha)/2, mu=p_mean, kappa=concentration) %% 24 cutoff <- dvonmises(quantile, mu = p_mean, kappa = concentration) time_feature[i] <- dens_i >= cutoff }
print(time_feature)
NA    NA  TRUE FALSE  TRUE  TRUE FALSE
Detecția fraudelor în R

Să exersăm!

Detecția fraudelor în R

Preparing Video For Download...