Ajustarea SVM-urilor liniare

Support Vector Machines în R

Kailash Awati

Instructor

SVM liniar, cost implicit

library(e1071)
svm_model <- svm(y ~ ., 
                data = trainset, 
                type = "C-classification", 
                kernel = "linear", 
                scale = FALSE)
# Print model summary
svm_model
Call:
svm(formula = y ~ .,
    data = trainset,
    type = "C-classification", 
    kernel = "linear",
    scale = FALSE)

Parameters:
SVM-Type:  C-classification 
 SVM-Kernel:  linear 
       cost:  1 
      gamma:  0.5 
Number of Support Vectors:  55
Support Vector Machines în R

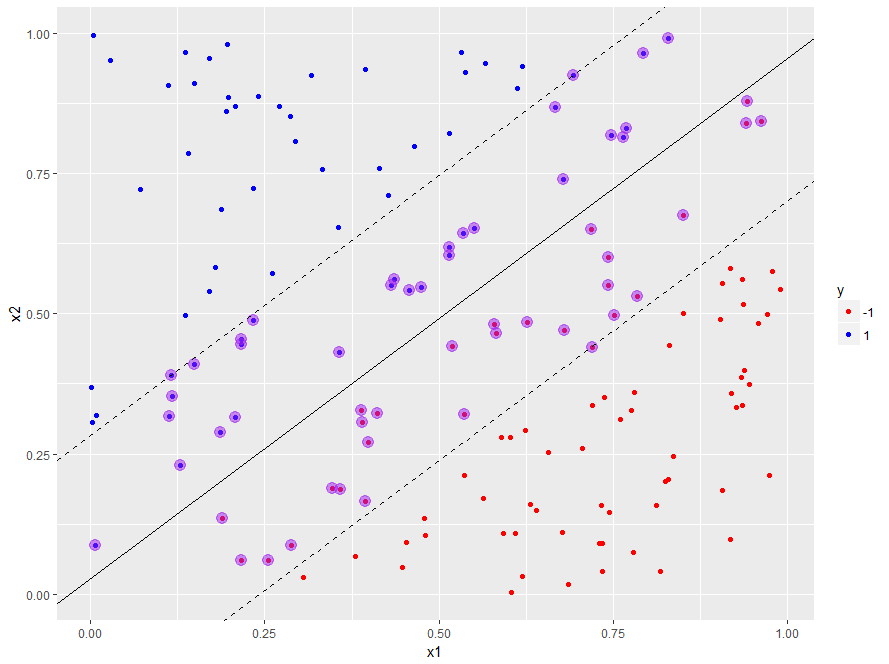
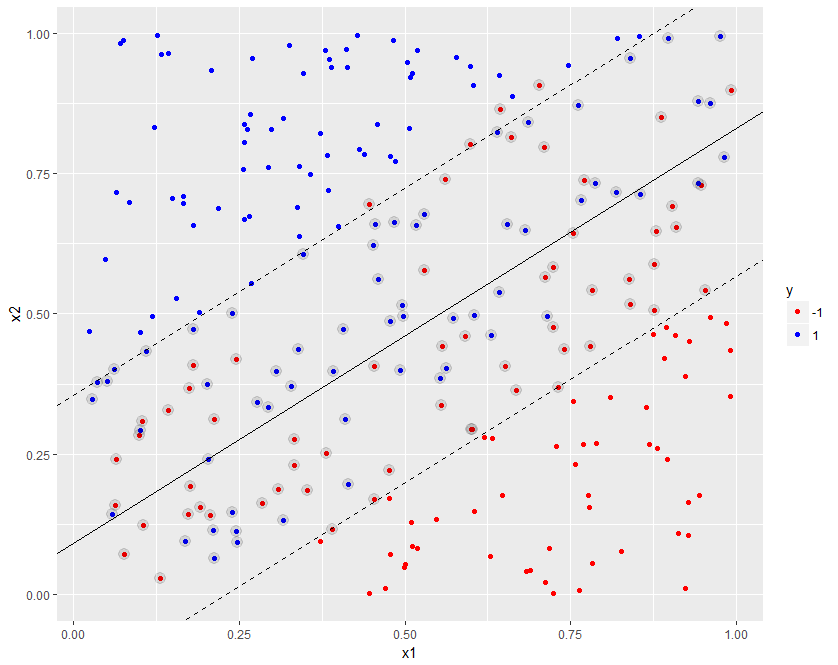
Set de date separabil liniar, kernel liniar cu cost implicit, vectori suport, granițe de decizie și marjă

Support Vector Machines în R

SVM liniar cu cost = 100

library(e1071)
svm_model <- svm(y ~ ., 
                data = trainset, 
                type = "C-classification", 
                kernel = "linear", 
                cost = 100,
                scale = FALSE)
# Print model summary
svm_model
Call:
svm(formula = y ~ .,
    data = trainset,
    type = "C-classification", 
    kernel = "linear",
    cost = 100,
    scale = FALSE)

Parameters:
SVM-Type:  C-classification 
 SVM-Kernel:  linear 
       cost:  100 
      gamma:  0.5 
Number of Support Vectors:  6
Support Vector Machines în R

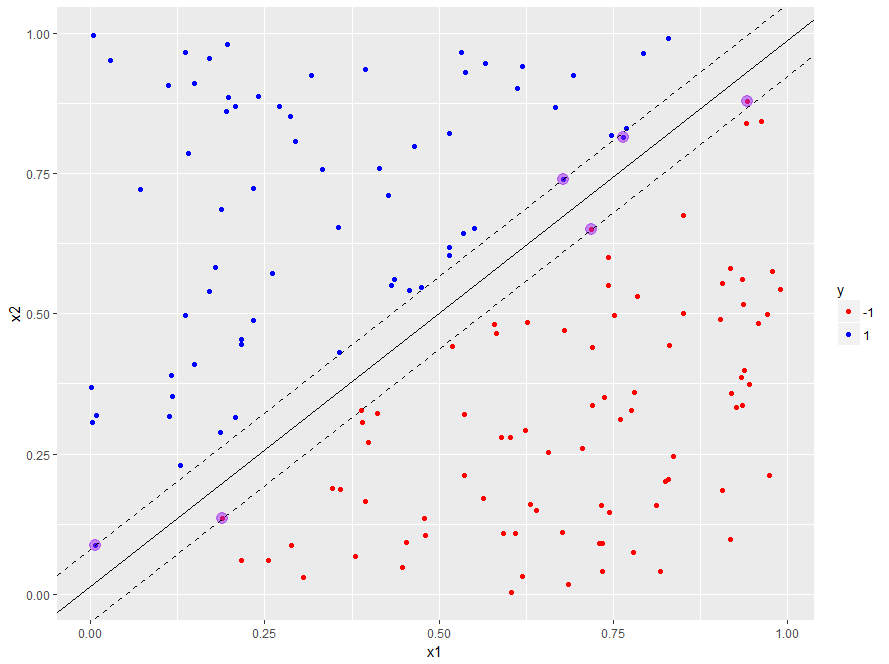
Date separabile liniar, kernel liniar cu cost=100, vectori suport, granițe de decizie și marjă

Support Vector Machines în R

Implicație

  • Poate fi util să reduceți marginea dacă granița de decizie este liniară
  • ...dar aceasta este rareori situația în practică
Support Vector Machines în R

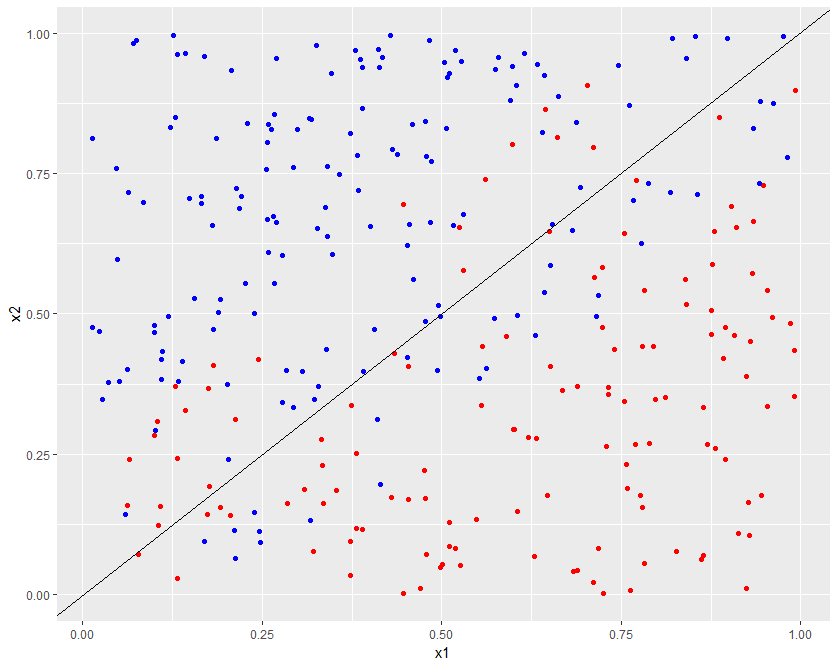
Set de date neseparabil liniar

Support Vector Machines în R

Set de date neliniar, SVM liniar (cost = 100)

  • Construiți modelul cu cost=100 folosind 80% din date ca set de antrenare
# Build model
library(e1071)
svm_model<- svm(y ~ ., 
                data = trainset, 
                type = "C-classification", 
                kernel = "linear", 
                cost = 100,
                scale = FALSE)
  • Calculați acuratețea
# Train and test accuracy
pred_train <- predict(svm_model, trainset)
mean(pred_train == trainset$y)
0.8208333
pred_test <- predict(svm_model, testset)
mean(pred_test == testset$y)
0.85
  • Acuratețe medie pe test pentru 50 de împărțiri aleatorii: 82,9%
Support Vector Machines în R

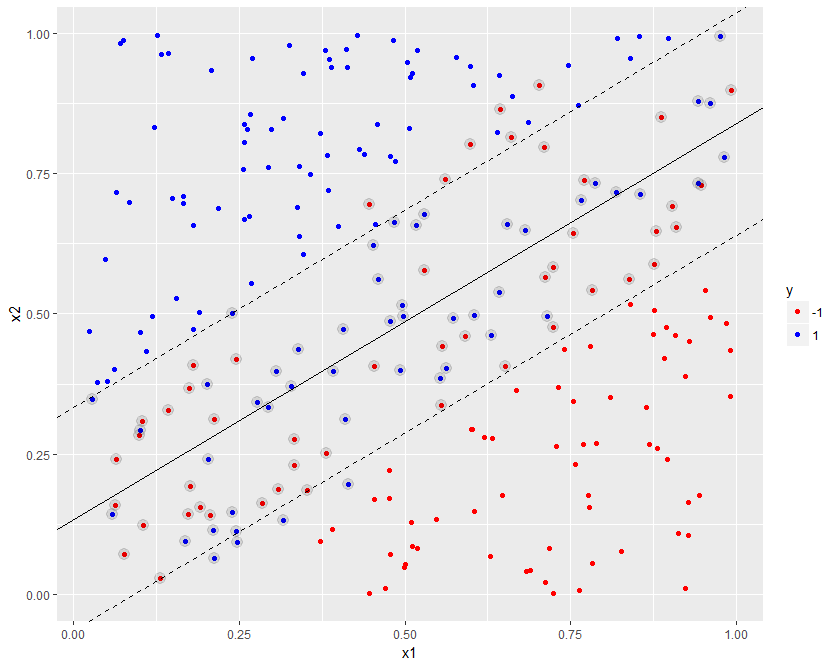
Set de date neseparabil liniar, kernel liniar cu cost=100, vectori suport, granițe de decizie și marjă

Support Vector Machines în R

Set de date neliniar, SVM liniar (cost = 1)

  • Reconstruiți modelul cu cost = 1
# Trainset contains 80% of data
# Same train/test split as before.
# Build model
svm_model <- svm(y ~ ., 
                data = trainset, 
                type = "C-classification", 
                kernel = "linear", 
                cost = 1,
                scale = FALSE)
  • Calculați acuratețea pe test
# Test accuracy
pred_test <- predict(svm_model, testset)
mean(pred_test == testset$y)
0.8666667
  • Acuratețe medie pe test pentru 50 de împărțiri aleatorii: 83,7%
Support Vector Machines în R

Set de date neseparabil liniar, kernel liniar cu cost=1, vectori suport, granițe de decizie și marjă

Support Vector Machines în R

Timp pentru practică!

Support Vector Machines în R

Preparing Video For Download...