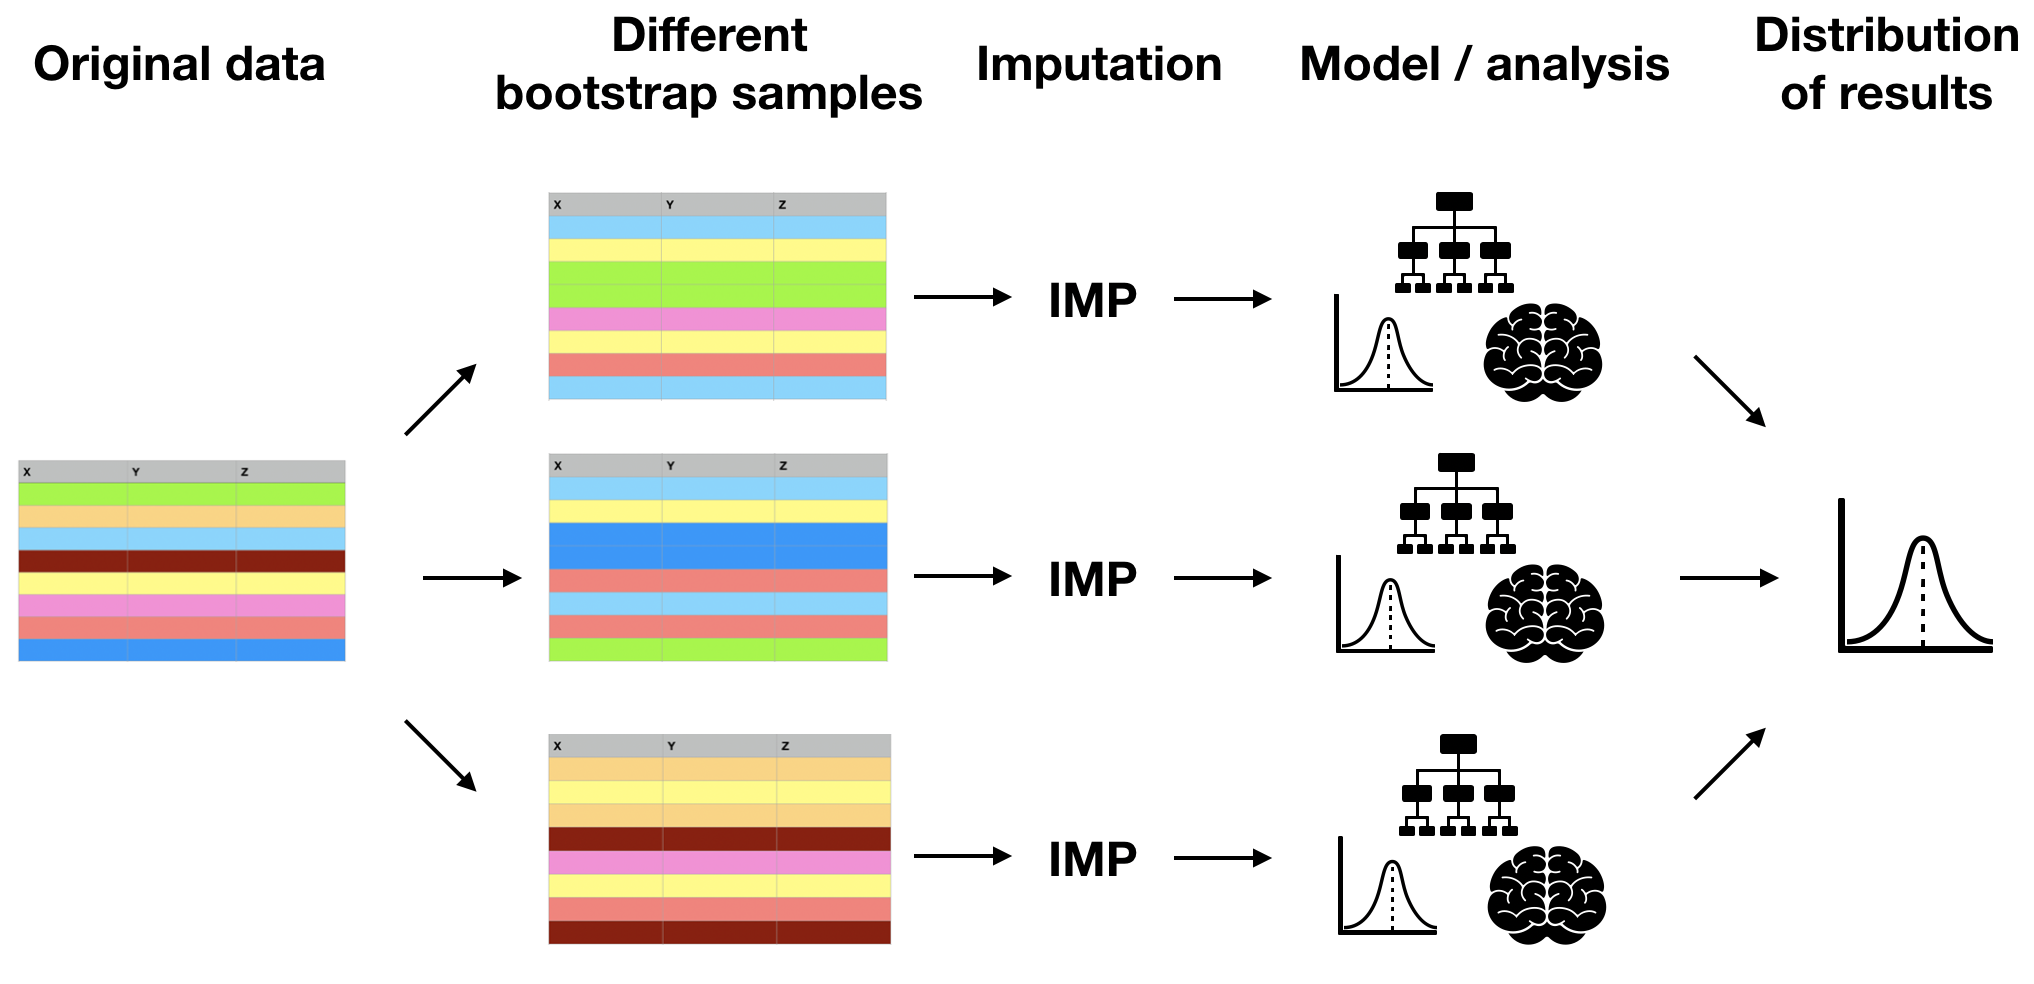
Imputare multiplă prin bootstrapping

Gestionarea datelor lipsă prin imputare în R

Michal Oleszak

Machine Learning Engineer

Incertitudinea din imputare

  • Imputarea este de obicei un prim pas înainte de analiză sau modelare.
  • Valorile lipsă sunt estimate cu o anumită incertitudine.
  • Această incertitudine trebuie luată în considerare în orice analiză efectuată pe date imputate.
Antetul paginii de titlu a articolului lui Ranjit Lall intitulat „How Multiple Imputation Makes a Difference".

În aproape jumătate din studii, rezultatele cheie dispar

Gestionarea datelor lipsă prin imputare în R

Bootstrap

Bootstrapping = eșantionarea rândurilor cu înlocuire pentru a obține date de dimensiune originală
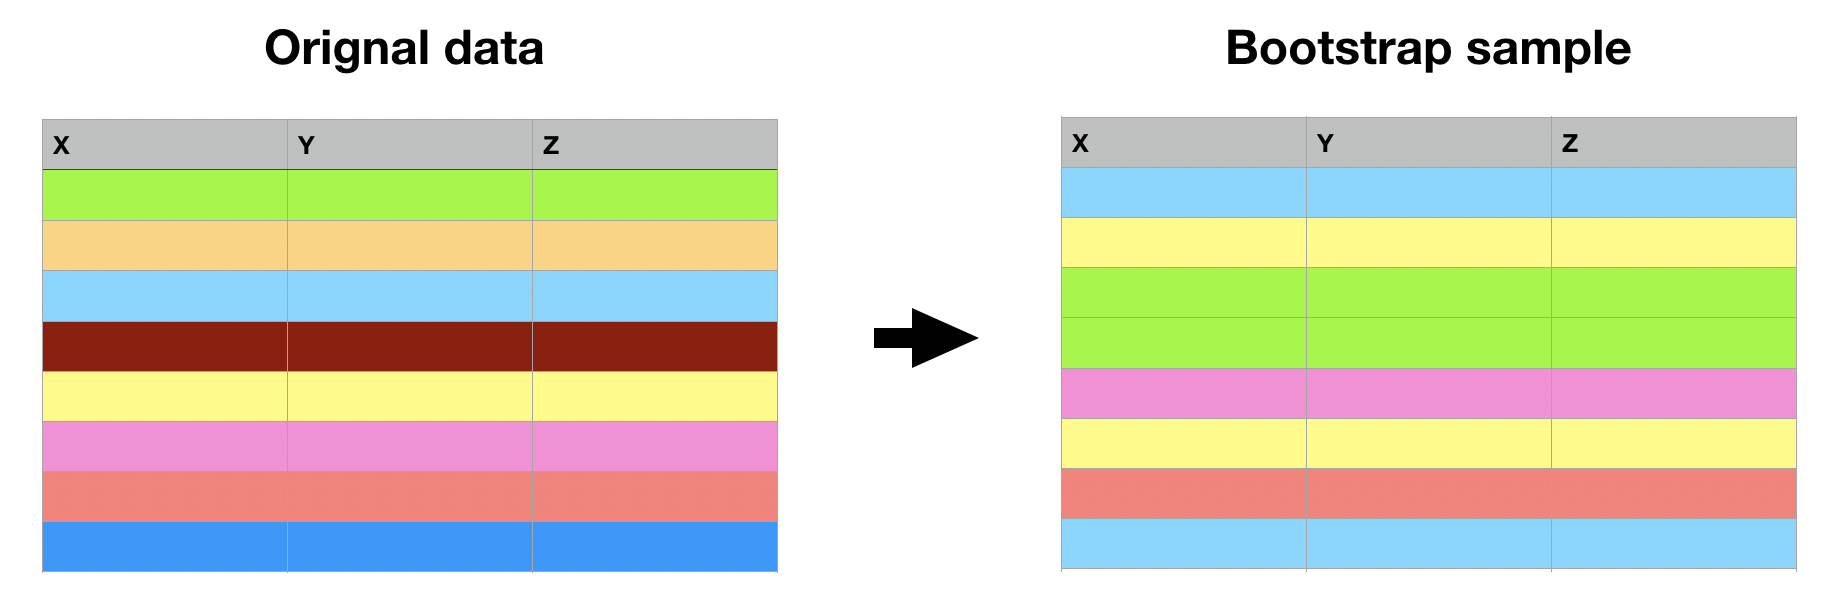
Două cadre de date schematice. Cel din stânga, etichetat „date originale", are fiecare rând într-o culoare diferită. Cel din dreapta, etichetat „eșantion bootstrap", conține unele rânduri repetate și altele absente.

Gestionarea datelor lipsă prin imputare în R

Imputare multiplă prin bootstrapping

O diagramă cu cinci etape ale imputării prin bootstrapping. Dintr-un cadru de date numit „date originale", trei săgeți indică spre trei cadre de date etichetate „eșantioane bootstrap diferite". Din fiecare, o săgeată indică spre etapa „Imputare". De acolo, săgețile indică spre etapa „Modelare / analiză". De acolo, săgețile indică spre un nod final numit „Distribuția rezultatelor".

Gestionarea datelor lipsă prin imputare în R

Imputare prin bootstrapping: avantaje și dezavantaje

Avantaje:

  • Funcționează cu orice metodă de imputare.
  • Poate aproxima cantități greu de calculat analitic.
  • Funcționează cu date MCAR și MAR.

Dezavantaje:

  • Lent pentru multe replici sau calcule consumatoare de timp.
Gestionarea datelor lipsă prin imputare în R

Bootstrapping în practică

calc_correlation <- function(data, indices) {


  # Return the correlation coefficient
  return(corr_coeff)
}
Gestionarea datelor lipsă prin imputare în R

Bootstrapping în practică

calc_correlation <- function(data, indices) {
  # Get bootstrap sample
  data_boot <- data[indices, ]


  # Return the correlation coefficient
  return(corr_coeff)
}
Gestionarea datelor lipsă prin imputare în R

Bootstrapping în practică

calc_correlation <- function(data, indices) {
  # Get bootstrap sample
  data_boot <- data[indices, ]
  # Impute with kNN imputation
  data_imp <- kNN(data_boot)


  # Return the correlation coefficient
  return(corr_coeff)
}
Gestionarea datelor lipsă prin imputare în R

Bootstrapping în practică

calc_correlation <- function(data, indices) {
  # Get bootstrap sample
  data_boot <- data[indices, ]
  # Impute with kNN imputation
  data_imp <- kNN(data_boot)
  # Calculate correlation between Weight and TotChol
  corr_coeff <- cor(data_imp$Weight, data_imp$TotChol)
  # Return the correlation coefficient
  return(corr_coeff)
}
Gestionarea datelor lipsă prin imputare în R

Bootstrapping în practică

library(boot)
boot_results <- boot(nhanes, statistic = calc_correlation, R = 50)
print(boot_results)
ORDINARY NONPARAMETRIC BOOTSTRAP

Call:
boot(data = nhanes, statistic = calc_correlation, R = 50)

Bootstrap Statistics :
      original      bias    std. error
t1* 0.03028306 0.007385452  0.04207152
Gestionarea datelor lipsă prin imputare în R

Vizualizarea rezultatelor bootstrap

plot(boot_results)
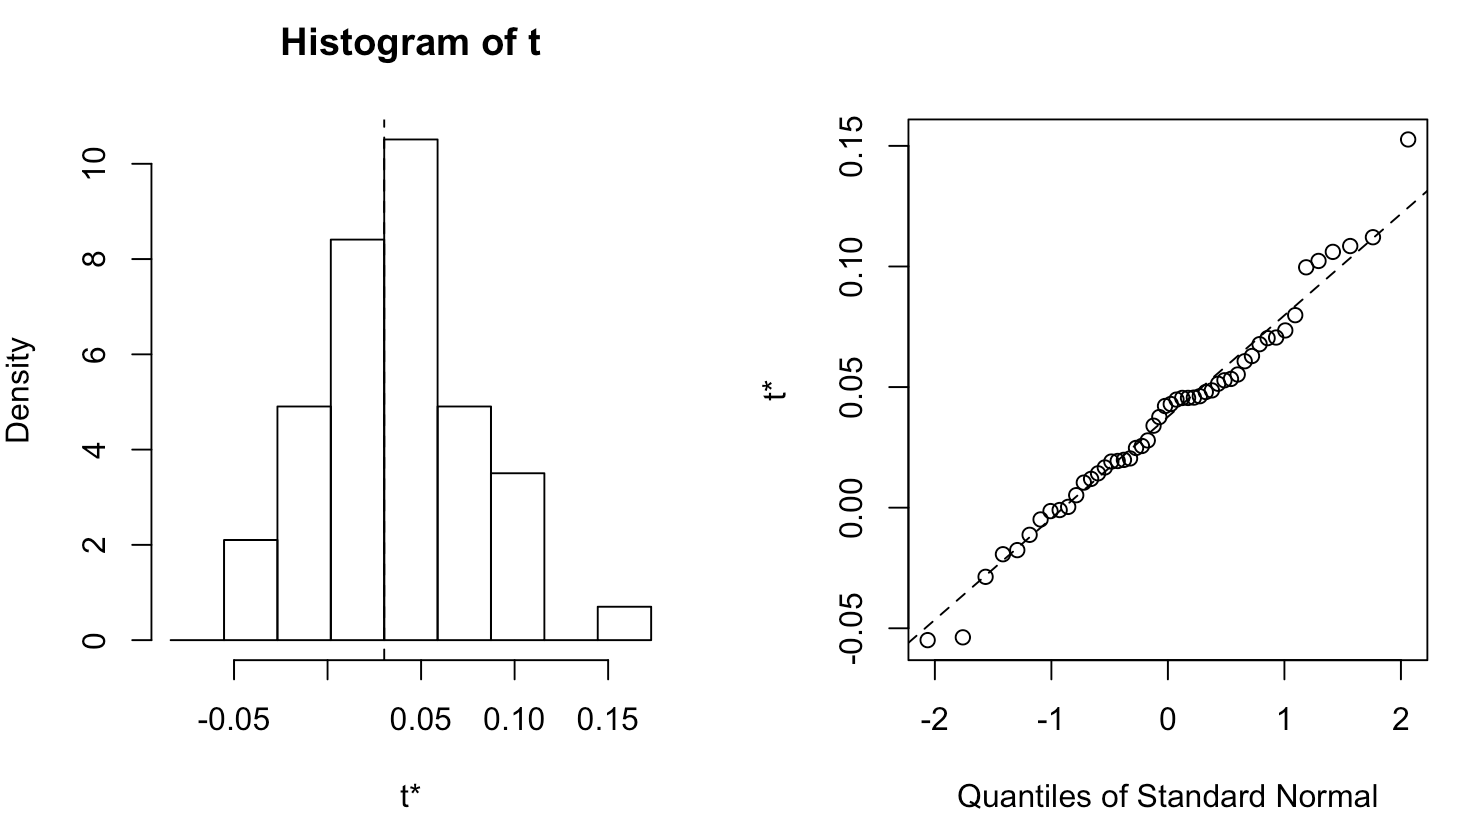
O histogramă și un grafic Q-Q care arată distribuția rezultatelor bootstrap. Ambele sugerează că distribuția este apropiată de normală.

Gestionarea datelor lipsă prin imputare în R

Intervale de încredere prin bootstrapping

boot_ci <- boot.ci(boot_results, conf = 0.95, type = "norm")
print(boot_ci)
BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
Based on 50 bootstrap replicates

CALL : 
boot.ci(boot.out = boot_results, conf = 0.95, type = "norm")

Intervals : 
Level      Normal        
95%   (-0.0596,  0.1054 )  
Calculations and Intervals on Original Scale
Gestionarea datelor lipsă prin imputare în R

Să exersăm bootstrapping-ul!

Gestionarea datelor lipsă prin imputare în R

Preparing Video For Download...