Imputare bazată pe arbori
Gestionarea datelor lipsă prin imputare în R

Michal Oleszak
Machine Learning Engineer
Abordarea imputării bazate pe arbori
Utilizați modele de învățare automată pentru a prezice valorile lipsă!
- Abordare neparametrică: fără ipoteze privind relațiile dintre variabile.
- Poate detecta tipare neliniare complexe.
- Performanță predictivă adesea superioară modelelor statistice simple.
În acest curs: pachetul missForest, bazat pe randomForest
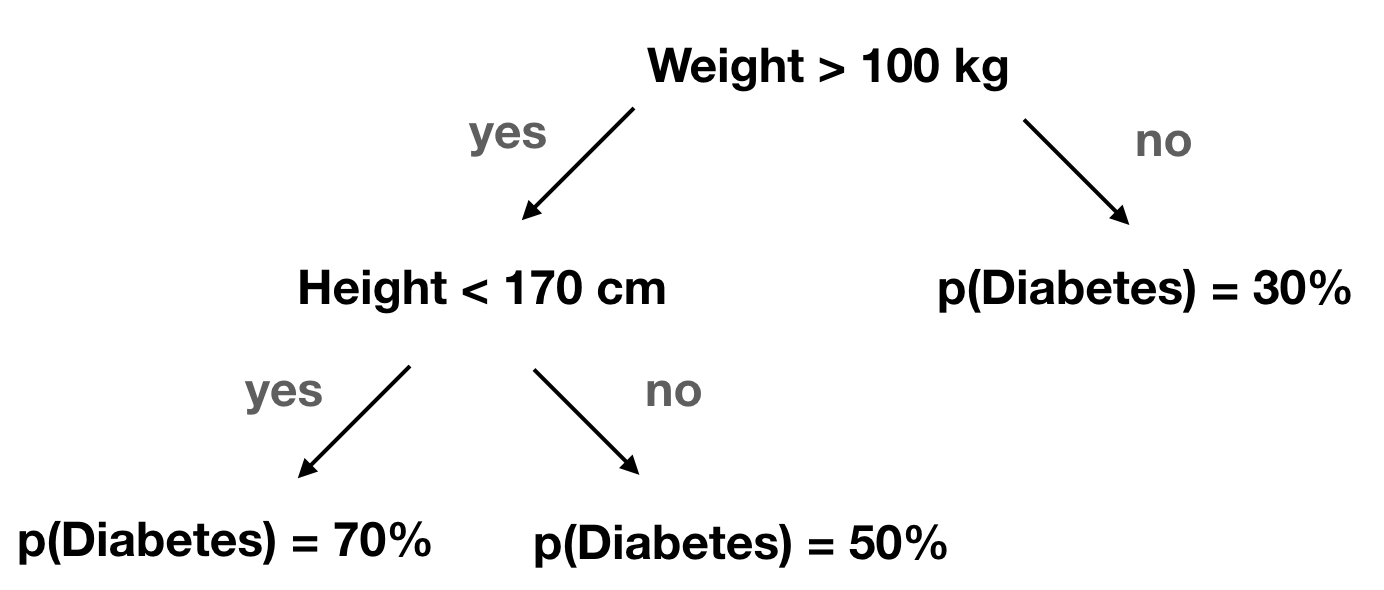
Arbori de decizie
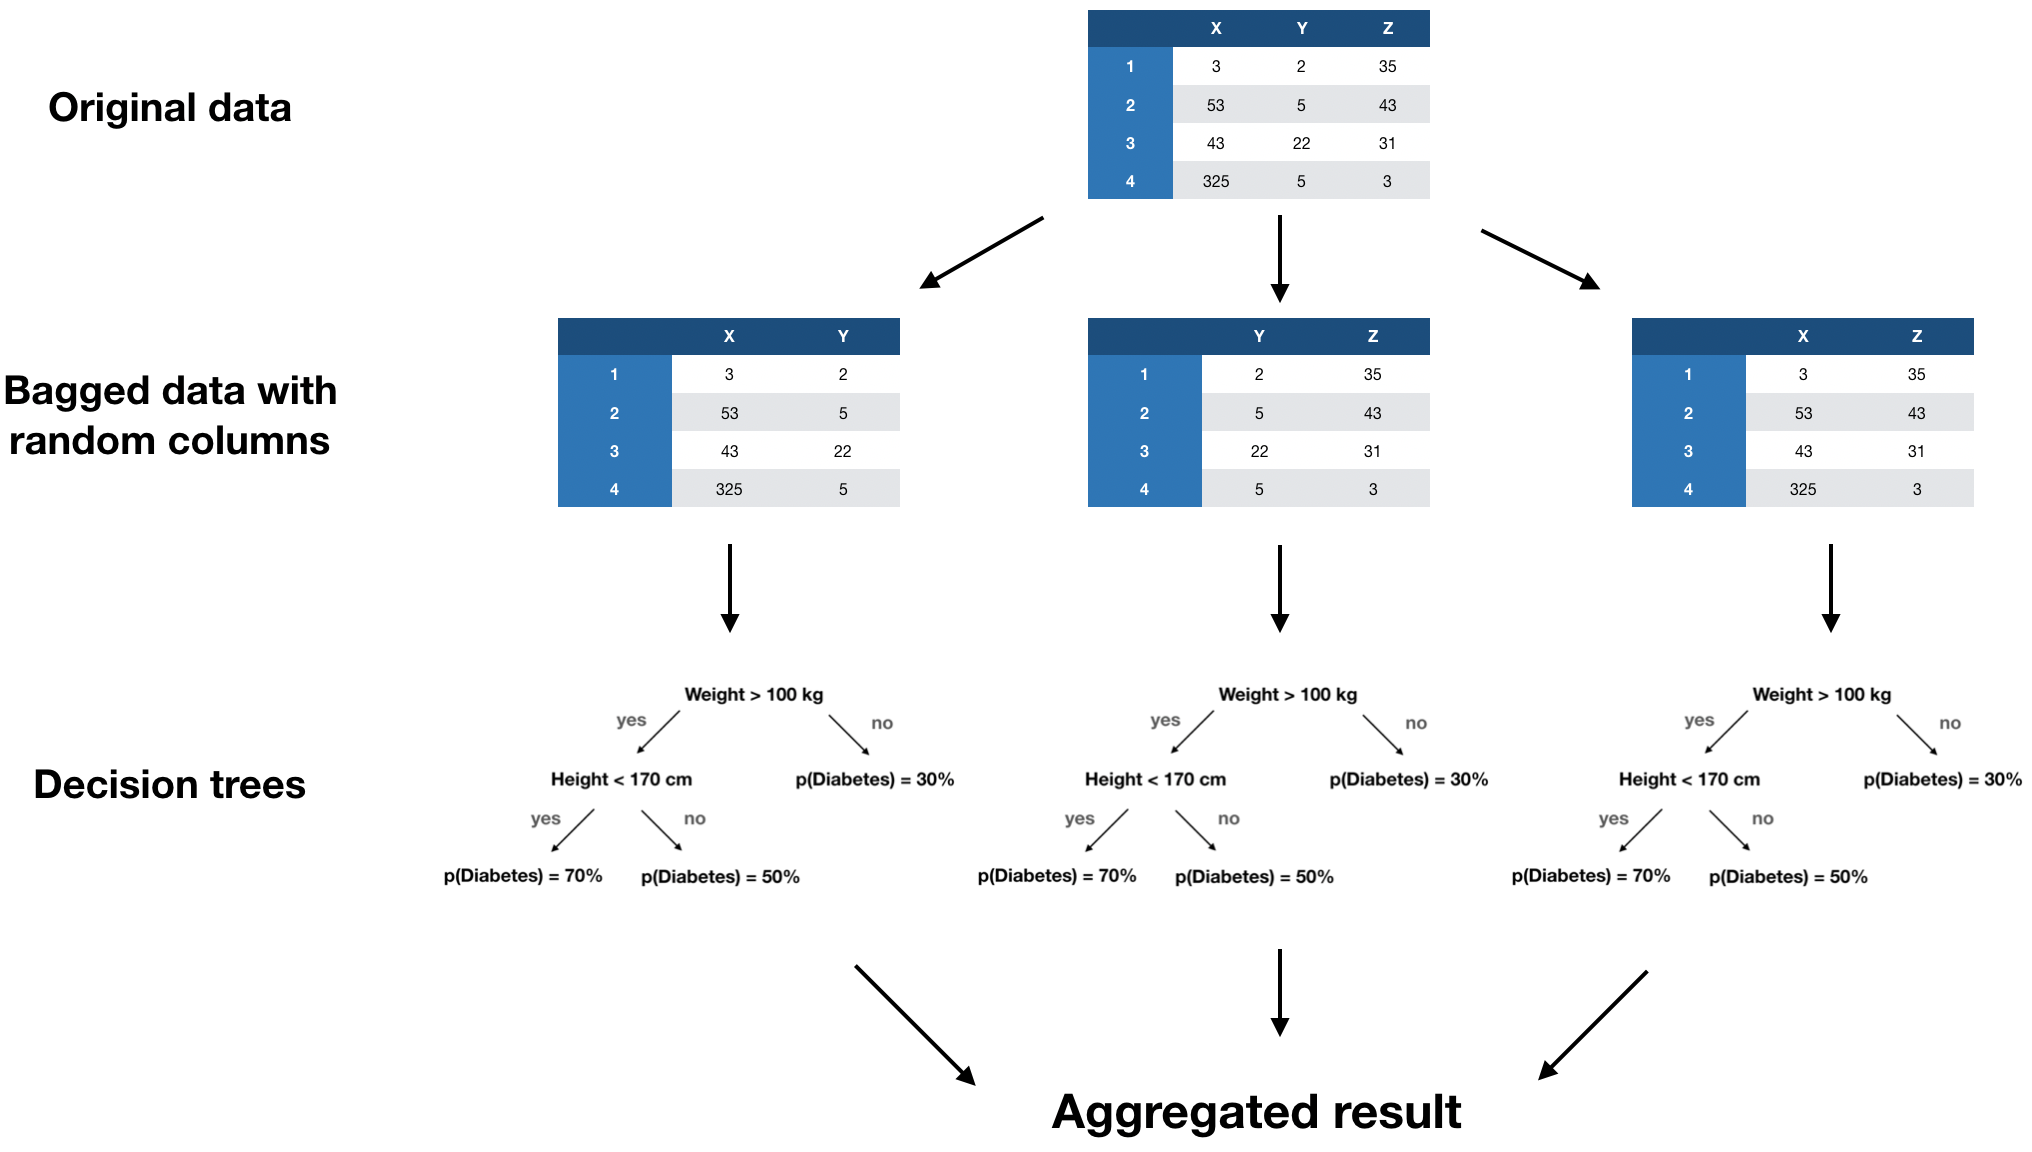
Păduri aleatoare
Algoritmul missForest
- Faceți o estimare inițială a valorilor lipsă prin imputarea cu media.
- Sortați variabilele în ordine crescătoare după numărul de valori lipsă.
- Pentru fiecare variabilă x:
- Ajustați o pădure aleatoare pe partea observată a lui x (folosind celelalte variabile ca predictori).
- Utilizați-o pentru a prezice partea lipsă a lui x.
- Repetați pasul 3 până când valorile imputate nu se mai modifică semnificativ.
missForest în practică
nhanes %>% is.na() %>% colSums()
Age     Gender     Weight     Height   Diabetes    TotChol      Pulse PhysActive
  0          0          9          8          1         85         32         26
library(missForest)
imp_res <- missForest(nhanes)
nhanes_imp  <- imp_res$ximp
nhanes_imp %>% is.na() %>% colSums()
Age     Gender     Weight     Height   Diabetes    TotChol      Pulse PhysActive
  0          0          0          0          0          0          0          0
Eroarea de imputare
missForest() oferă o estimare a erorii de imputare out-of-bag (OOB):
- Eroarea pătratică medie normalizată (NRMSE) pentru variabile continue.
- Proporția intrărilor clasificate eronat (PFC) pentru variabile categoriale.
În ambele cazuri, o valoare apropiată de 0 indică performanță bună, iar valorile în jurul lui 1 indică un rezultat slab.
imp_res <- missForest(nhanes)
imp_res$OOBerror
      NRMSE         PFC
0.147687025 0.003676471
Eroarea de imputare
missForest() oferă o estimare a erorii de imputare out-of-bag (OOB):
- Eroarea pătratică medie normalizată (NRMSE) pentru variabile continue.
- Proporția intrărilor clasificate eronat (PFC) pentru variabile categoriale.
În ambele cazuri, o valoare apropiată de 0 indică performanță bună, iar valorile în jurul lui 1 indică un rezultat slab.
imp_res <- missForest(nhanes, variablewise = TRUE)
imp_res$OOBerror
    MSE       PFC       MSE       MSE       PFC       MSE       MSE       MSE
0.00000   0.00000 285.79563  40.42142   0.00735   0.53444 129.03609   0.17576
Compromis viteză-acuratețe
Construirea mai multor păduri aleatoare poate fi costisitoare computațional.
Idee: sacrificăm puțin din acuratețe și reducem dimensiunea pădurii pentru a scădea timpul de calcul.
- Reduceți numărul de arbori din fiecare pădure (argumentul
ntree). - Reduceți numărul de variabile folosite pentru divizare (argumentul
mtry).
Efectul asupra timpului de calcul diferă:
- Reducerea
ntreeare un efect liniar. - Reducerea
mtrycrește viteza mai mult când există multe variabile.
Compromis viteză-acuratețe în practică
Setări implicite:
start_time <- Sys.time()
imp_res <- missForest(nhanes)
end_time <- Sys.time()
print(imp_res$OOBerror)
print(end_time - start_time)
      NRMSE         PFC
0.147687025 0.003676471
Time difference of 5.496582 secs
Păduri reduse:
start_time <- Sys.time()
imp_res <- missForest(nhanes,
                      ntree = 10,
                      mtry = 2)
end_time <- Sys.time()
print(imp_res$OOBerror)
print(end_time - start_time)
      NRMSE         PFC
0.162420139 0.007425743
Time difference of 0.516367 secs
Să exersăm!
Gestionarea datelor lipsă prin imputare în R

