Gestionarea datelor lipsă prin imputare în R
Michal Oleszak
Machine Learning Engineer
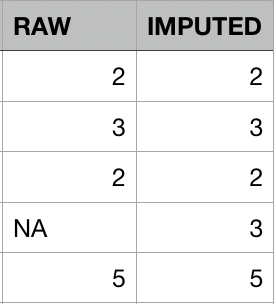
Imputarea = estimarea valorilor lipsă pe baza informațiilor disponibile
Acest capitol se concentrează pe metodele bazate pe donatori:

Imputarea prin medie funcționează bine pentru datele de tip serie temporală care fluctuează aleatoriu în jurul unei medii pe termen lung.
Pentru datele transversale, imputarea prin medie este adesea o alegere slabă:
Sarcină: imputarea prin medie a Height și Weight în datele NHANES.
nhanes <- nhanes %>%
mutate(Height_imp = ifelse(is.na(Height), TRUE, FALSE)) %>%
mutate(Weight_imp = ifelse(is.na(Weight), TRUE, FALSE))
Height și Weight cu mediile respective.nhanes_imp <- nhanes %>%
mutate(Height = ifelse(is.na(Height), mean(Height, na.rm = TRUE), Height)) %>%
mutate(Weight = ifelse(is.na(Weight), mean(Weight, na.rm = TRUE), Weight))
nhanes_imp %>%
select(Weight, Height, Height_imp, Weight_imp) %>%
head()
Weight Height Height_imp Weight_imp
1 73.20000 166.2499 TRUE FALSE
2 72.30000 166.2499 TRUE FALSE
3 57.70000 158.9000 FALSE FALSE
4 88.90000 183.3000 FALSE FALSE
5 45.10000 157.6000 FALSE FALSE
6 66.77065 158.4000 FALSE TRUE
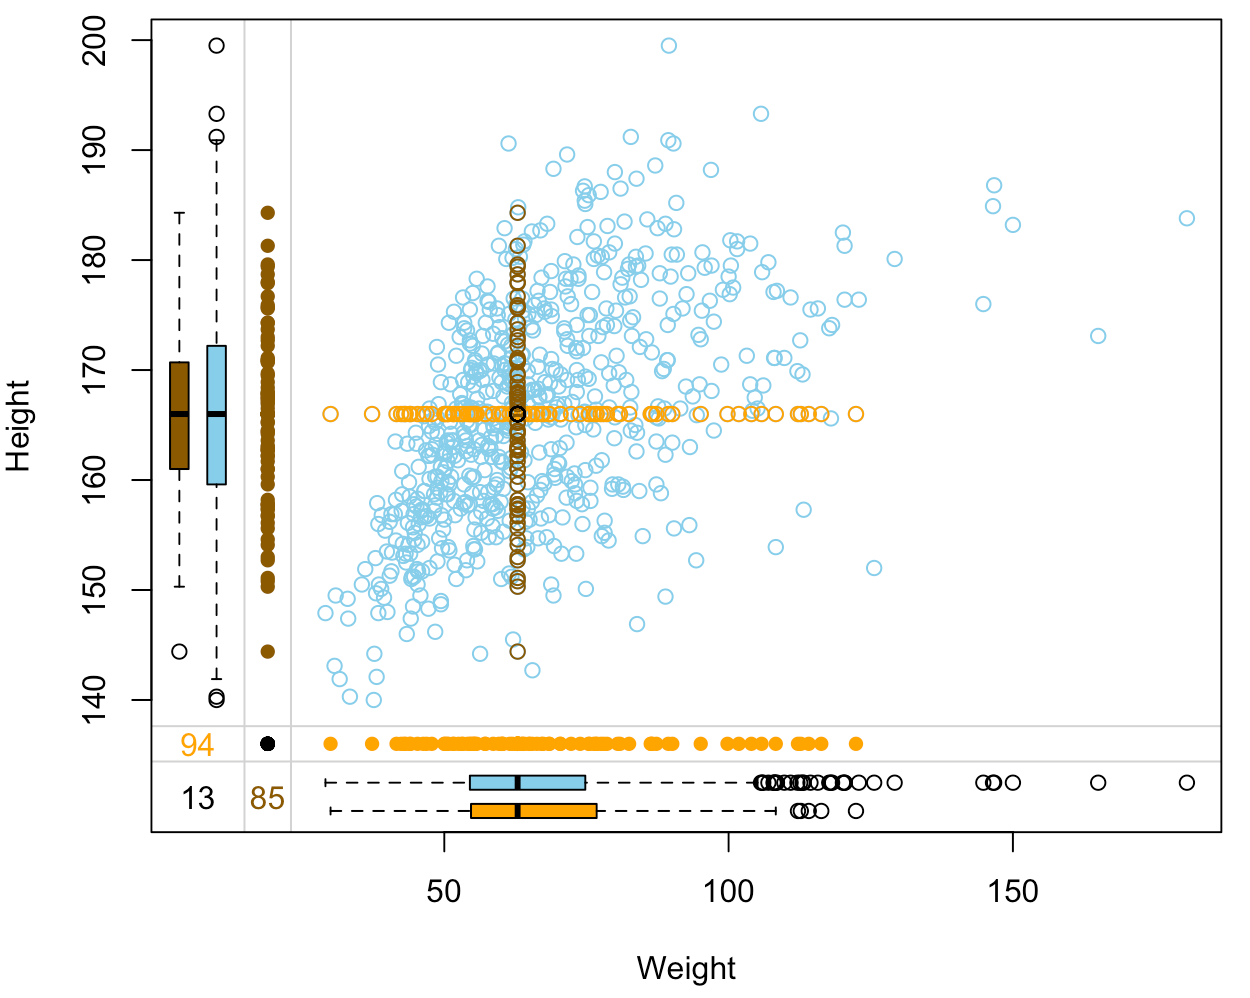
nhanes_imp %>% select(Weight, Height, Height_imp, Weight_imp) %>% marginplot(delimiter="imp")
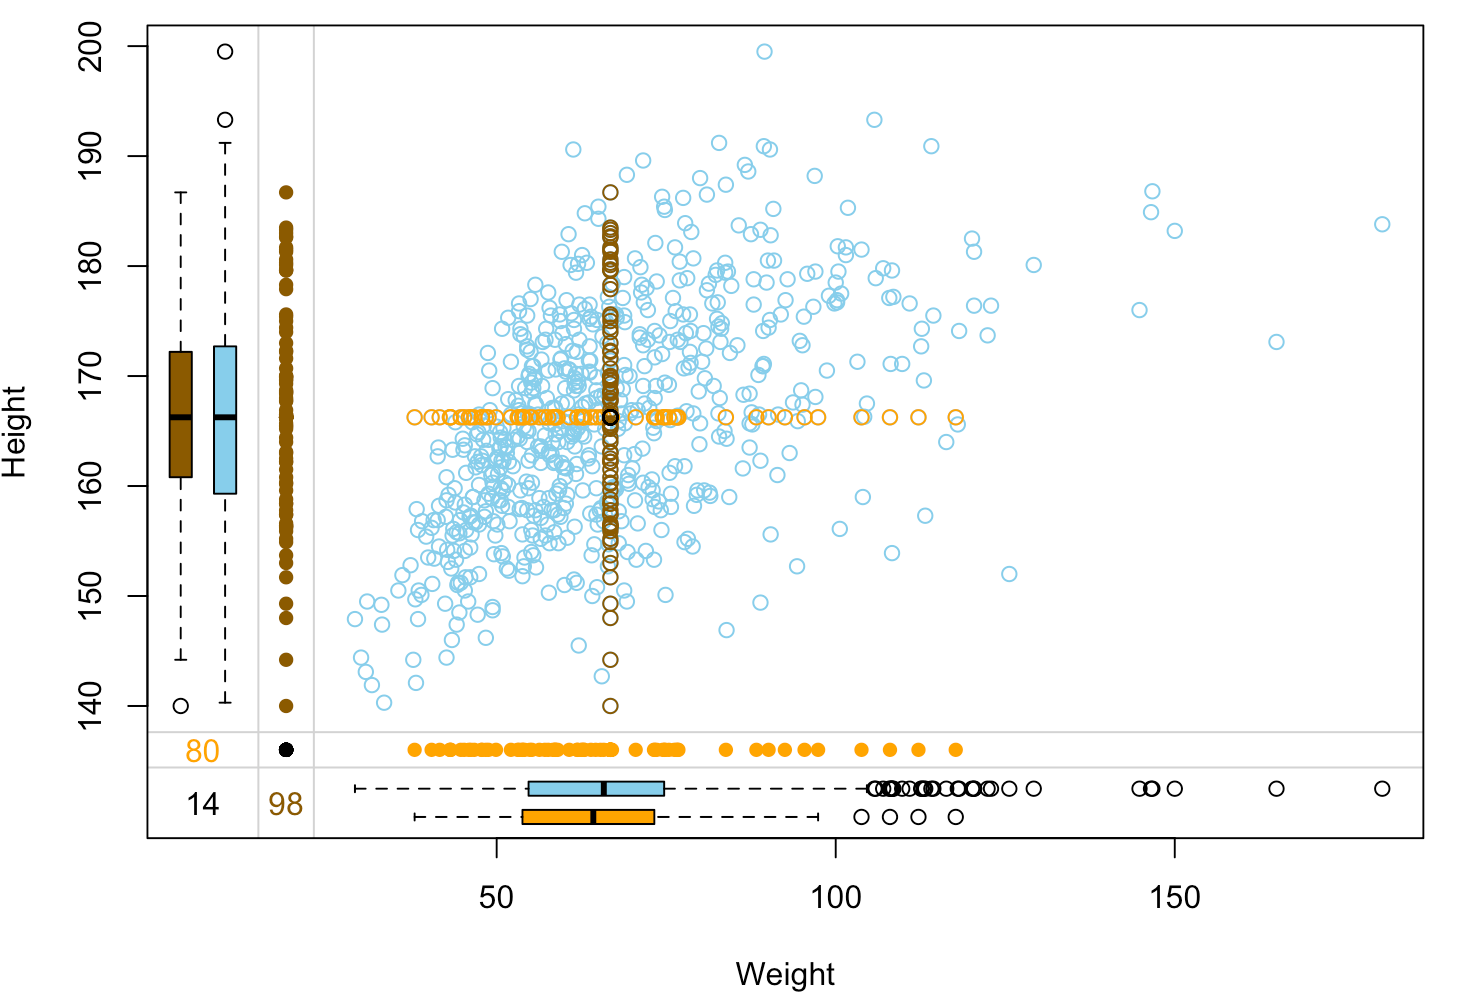
Distrugerea relației dintre variabile:
Height și Weight, corelația pozitivă dintre ele slăbește.Nicio variabilitate în datele imputate:

Gestionarea datelor lipsă prin imputare în R