Vizualizarea tiparelor de date lipsă

Gestionarea datelor lipsă prin imputare în R

Michal Oleszak

Machine Learning Engineer

Probleme cu abordarea prin testare

  • Detectarea tiparelor de date lipsă prin teste statistice poate fi dificilă.
  • Testul t implică multe ipoteze despre date.
  • Inferențele bazate pe p-valori sunt predispuse la probleme (alegerea nivelului de semnificație, p-hacking).
Gestionarea datelor lipsă prin imputare în R

Vizualizarea datelor lipsă

  • O altă abordare: vizualizările!
  • Ușor de utilizat.
  • Permit detectarea tiparelor de date lipsă.
  • Oferă informații despre alte aspecte ale calității datelor.

Pachetul VIM oferă instrumente utile pentru vizualizarea datelor lipsă. În această lecție:

  • Grafic de agregare
  • Grafic de tip spine
  • Grafic de tip mozaic
Gestionarea datelor lipsă prin imputare în R

Grafic de agregare

nhanes %>% aggr(combined = TRUE, numbers = TRUE)
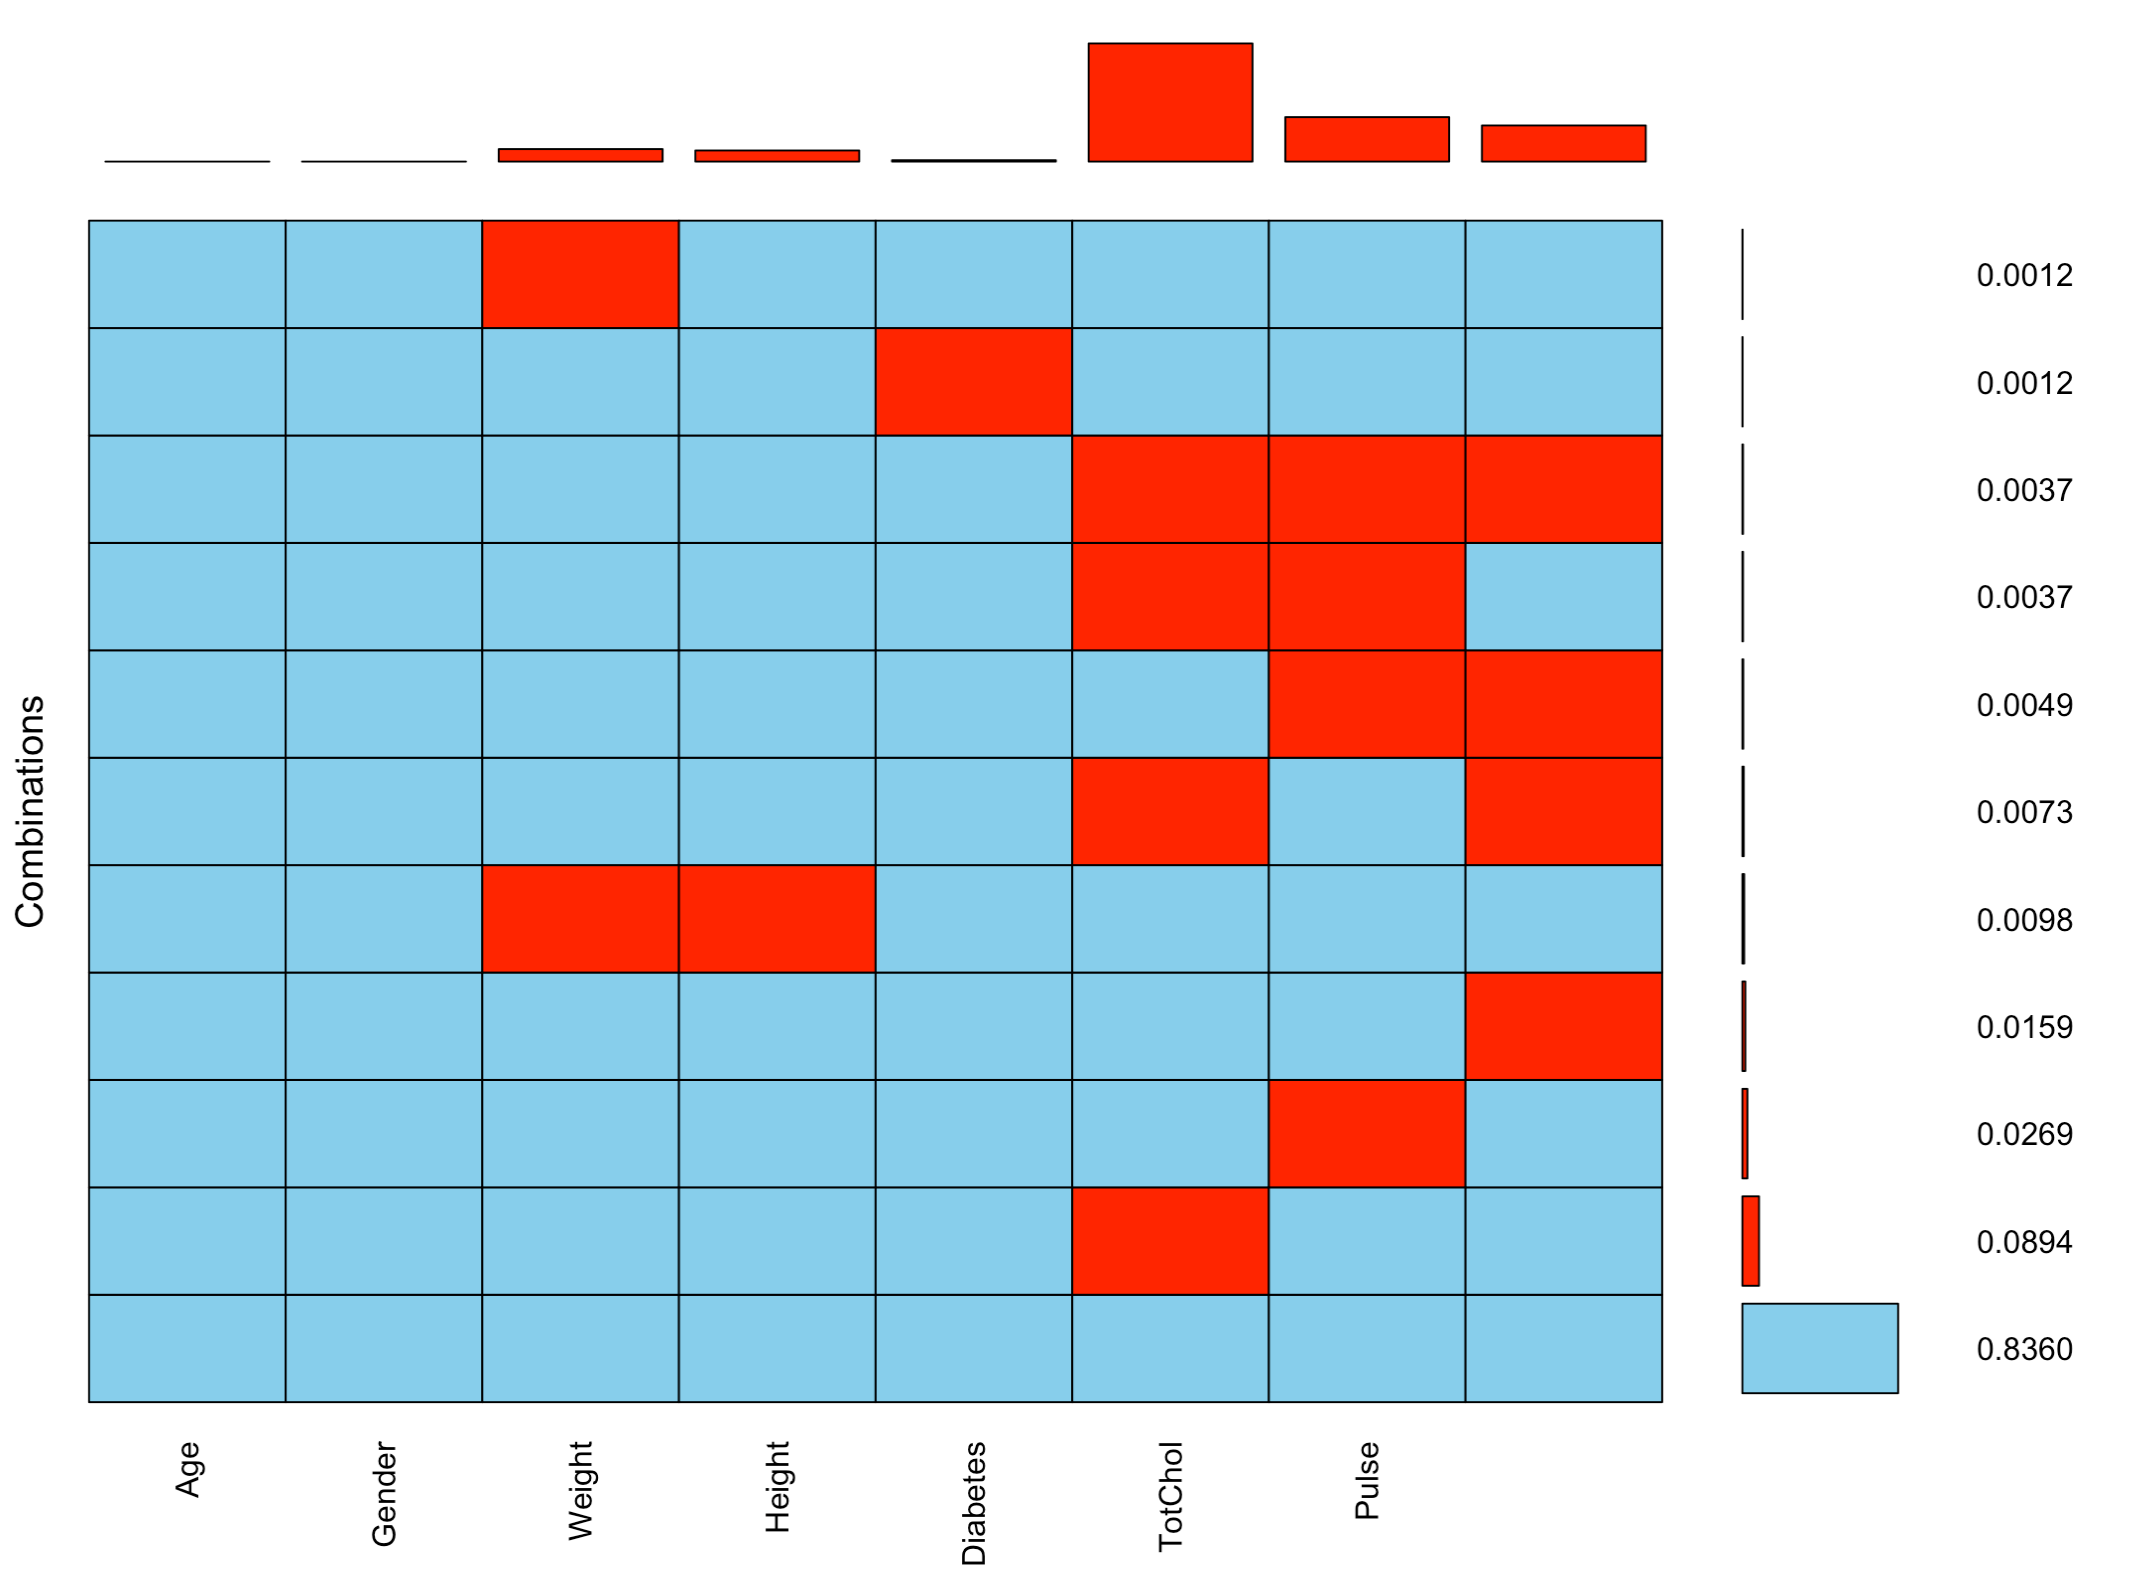
Un grafic de agregare format dintr-un tabel care prezintă toate combinațiile de valori lipsă și observate pentru variabilele din setul de date. Pentru fiecare combinație, este afișat procentul de observații cu tiparul de lipsă corespunzător.

Gestionarea datelor lipsă prin imputare în R

Grafic de tip spine

nhanes %>% select(Gender, TotChol) %>% spineMiss()
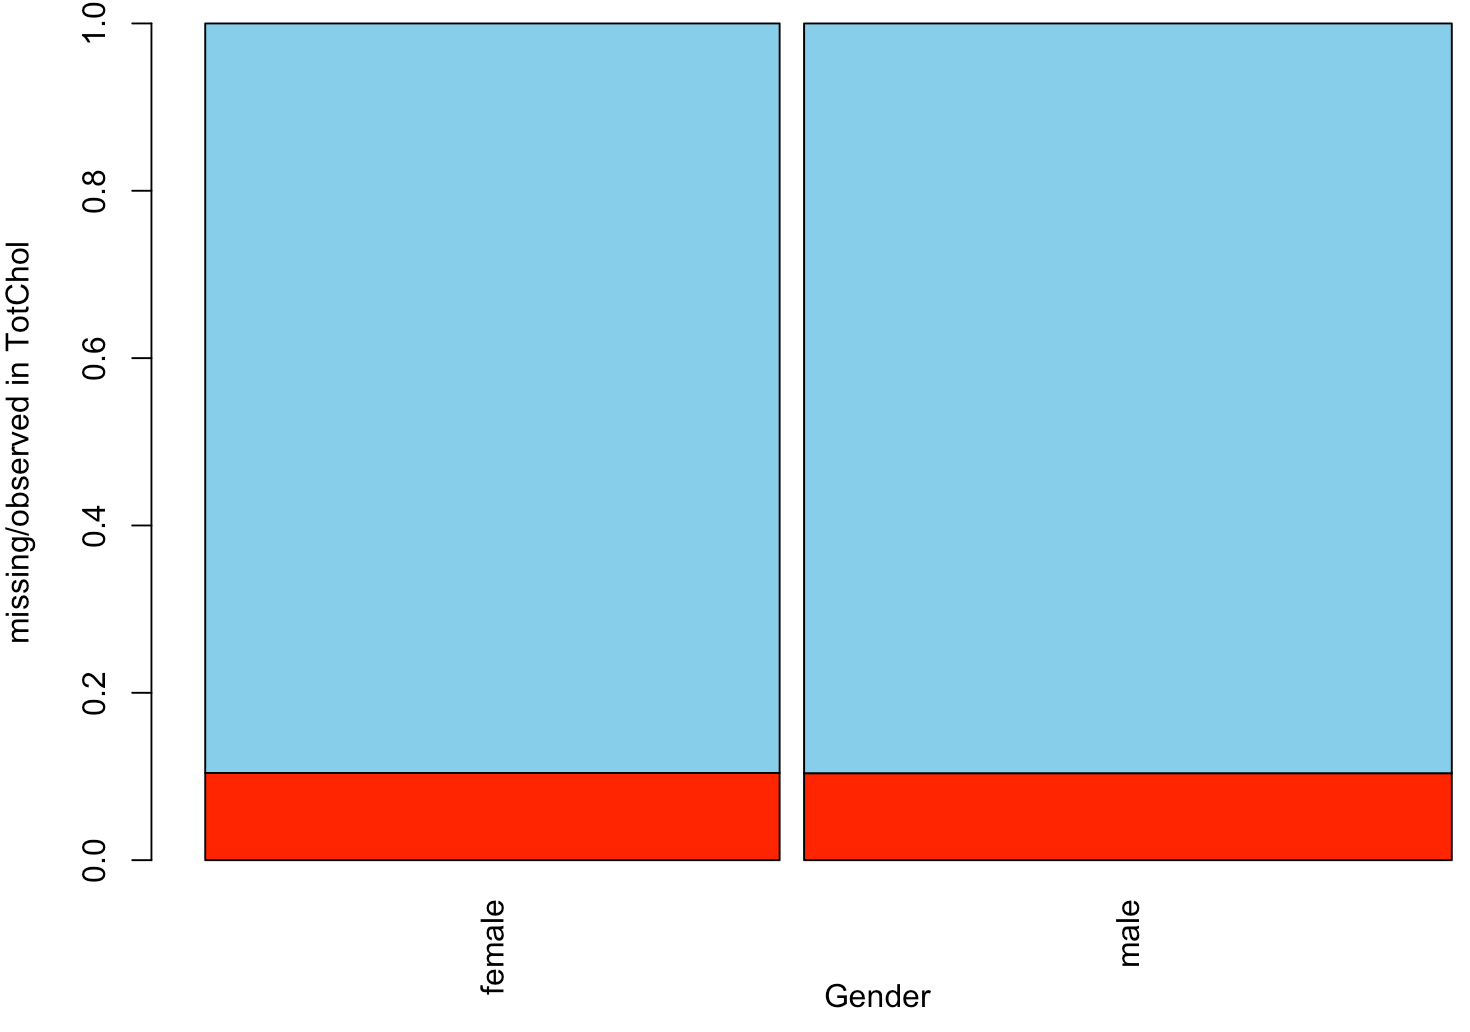
Graficul spine conține două bare corespunzătoare bărbaților și femeilor. În fiecare bară este afișat procentul de valori lipsă din variabila colesterol total pentru genul respectiv.

Gestionarea datelor lipsă prin imputare în R

Grafic de tip mozaic

nhanes %>% mosaicMiss(highlight = "TotChol", plotvars = c("Gender", "PhysActive"))
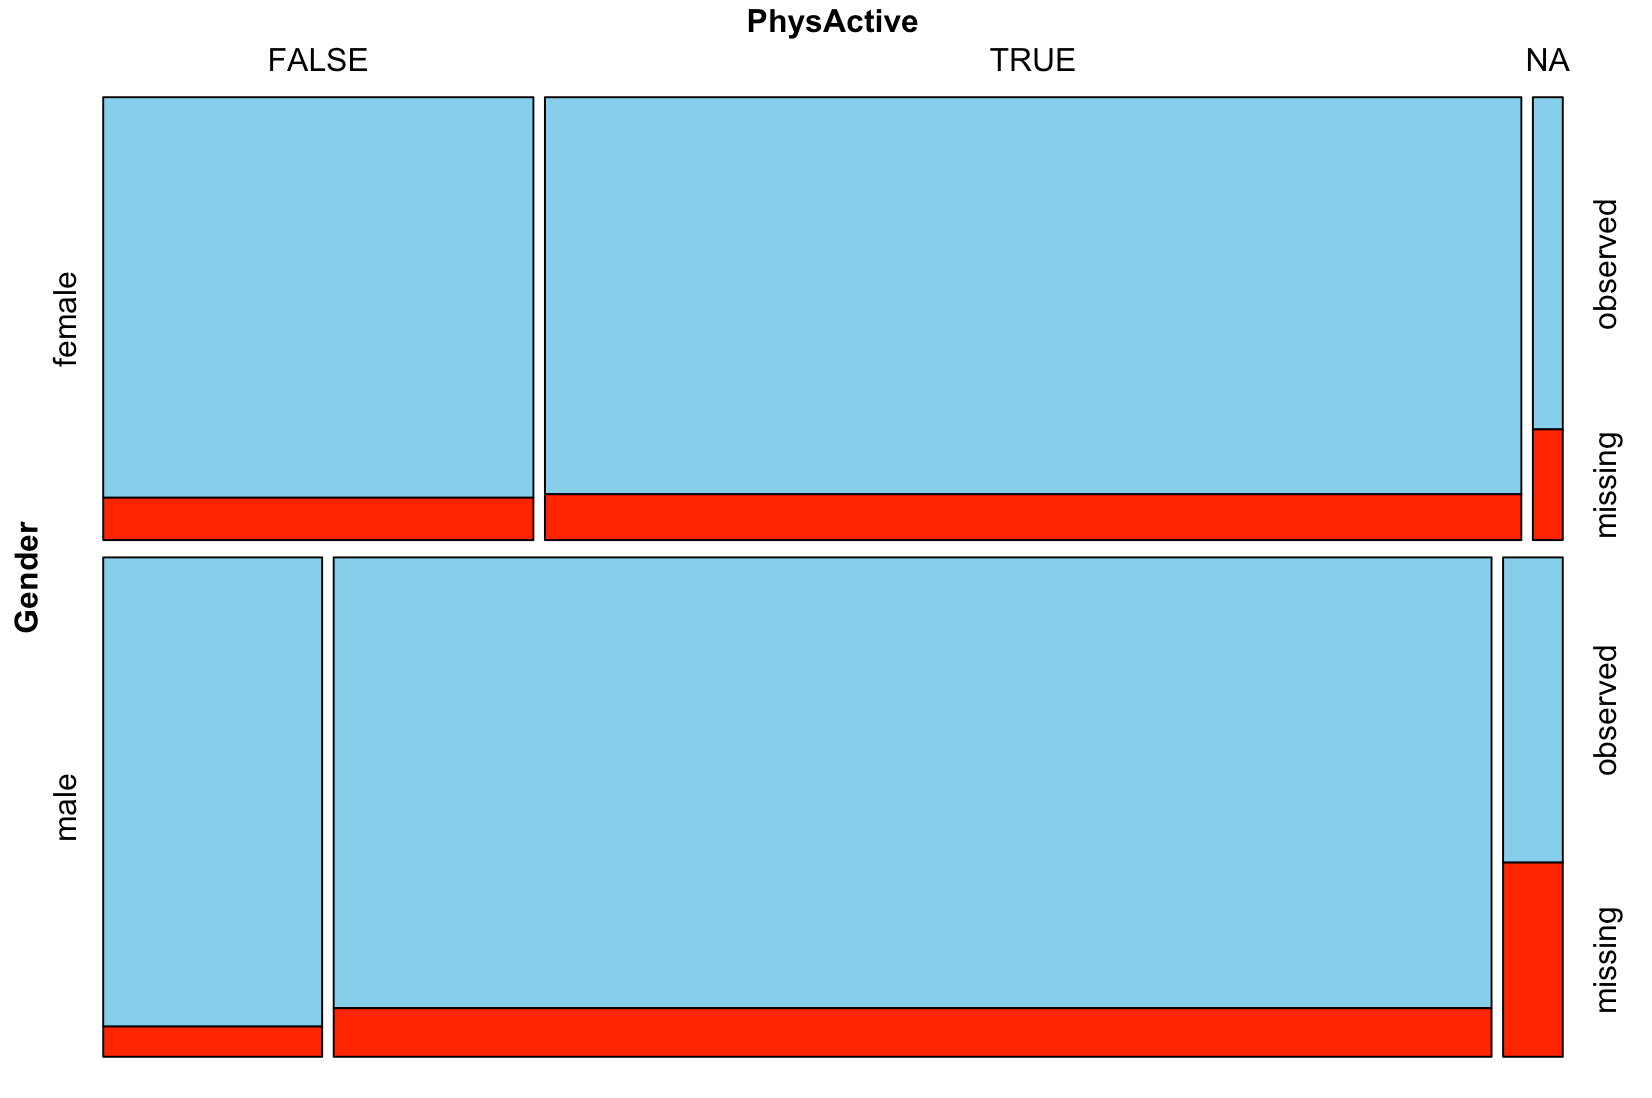
Un grafic mozaic format din plăci care alcătuiesc un dreptunghi. Fiecare placă corespunde unei valori din „Gender" și uneia din „PhysActive". În fiecare placă este afișat procentul de valori lipsă din variabila colesterol total.

Gestionarea datelor lipsă prin imputare în R

Să vizualizăm datele lipsă!

Gestionarea datelor lipsă prin imputare în R

Preparing Video For Download...