Replicarea variabilității datelor
Gestionarea datelor lipsă prin imputare în R

Michal Oleszak
Machine Learning Engineer
Variabilitatea în datele imputate
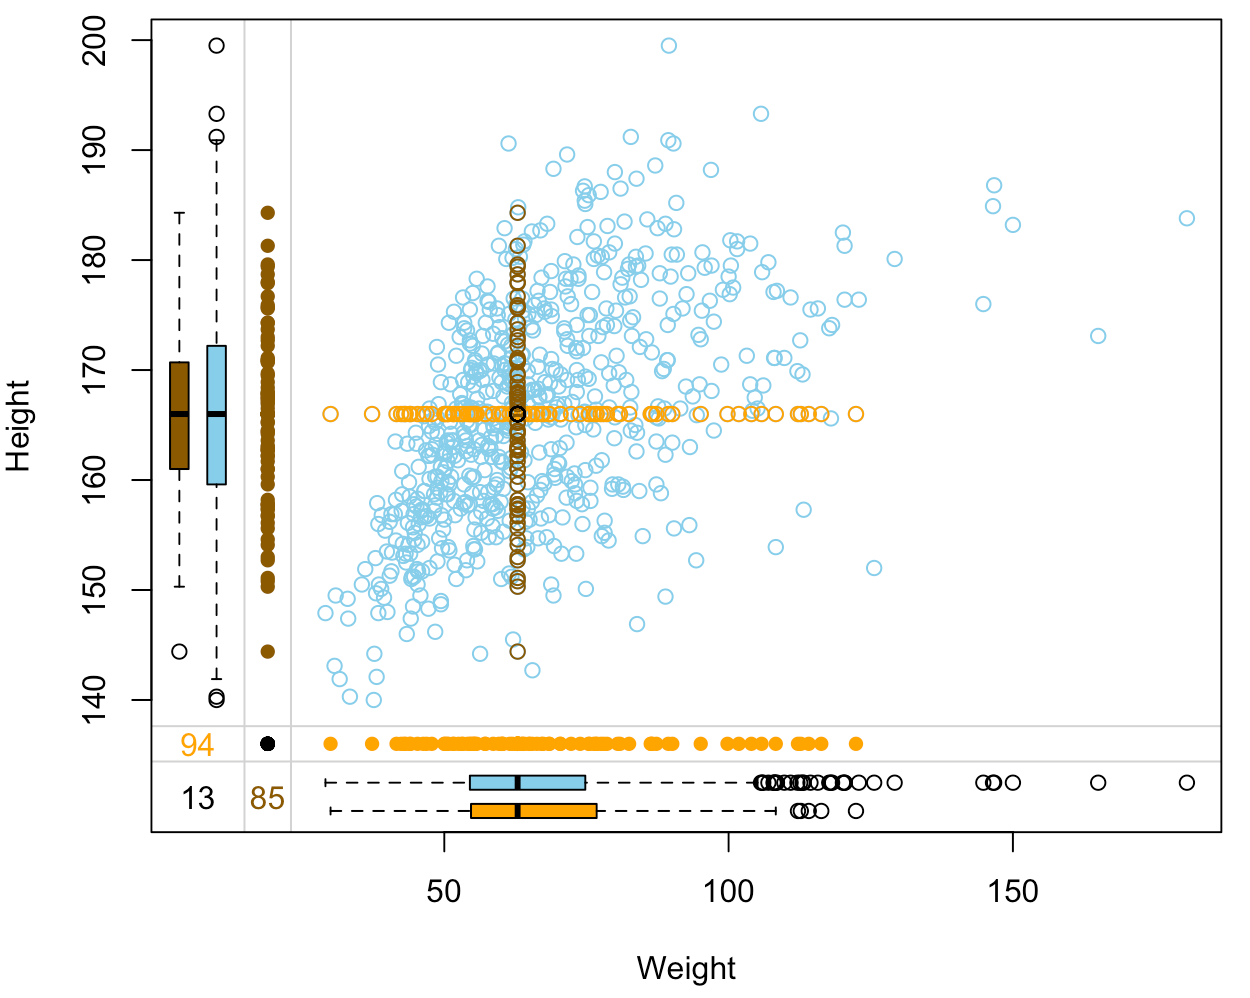
- Nicio variabilitate în datele imputate.
- Dorim ca imputarea să replice variabilitatea datelor observate.
- În imputarea bazată pe model, aceleași valori ale predictorilor produc aceeași valoare imputată.
- Soluție: eșantionare din distribuții condiționale.
Ce este o predicție
Majoritatea modelelor statistice estimează distribuția condițională a variabilei răspuns:
$p(y|X)$
Pentru o predicție unică, distribuția condițională este rezumată:
- Regresie liniară: valoarea așteptată a distribuției condiționale.
- Regresie logistică: clasa cu probabilitatea cea mai mare.
În schimb, putem eșantiona din aceste distribuții pentru a crește variabilitatea.
Eșantionare din distribuții condiționale
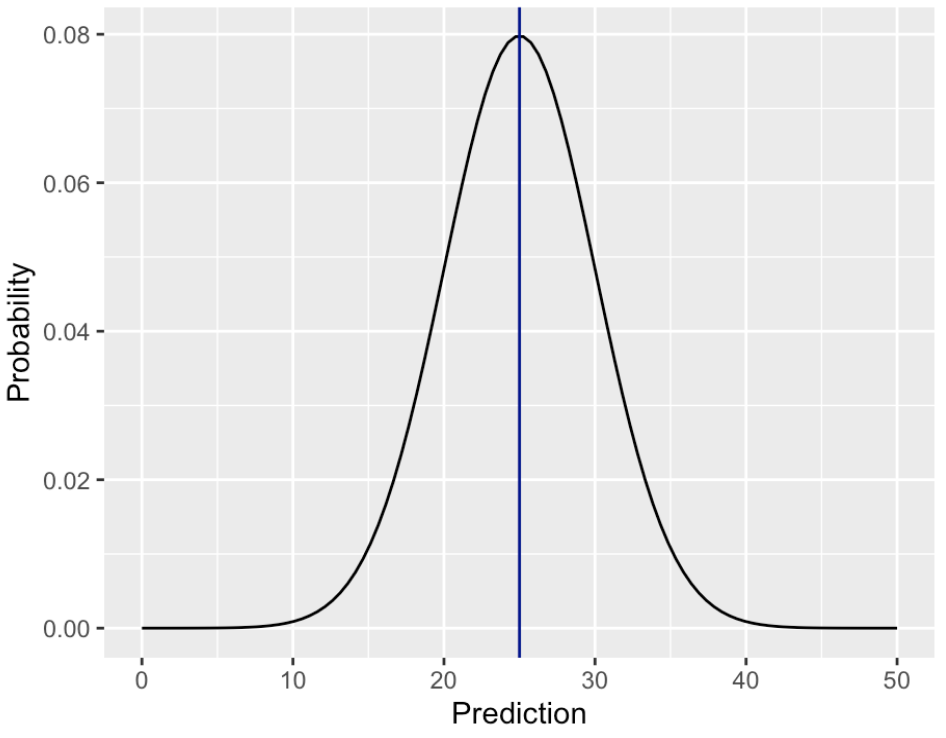
Eșantionare din distribuții condiționale
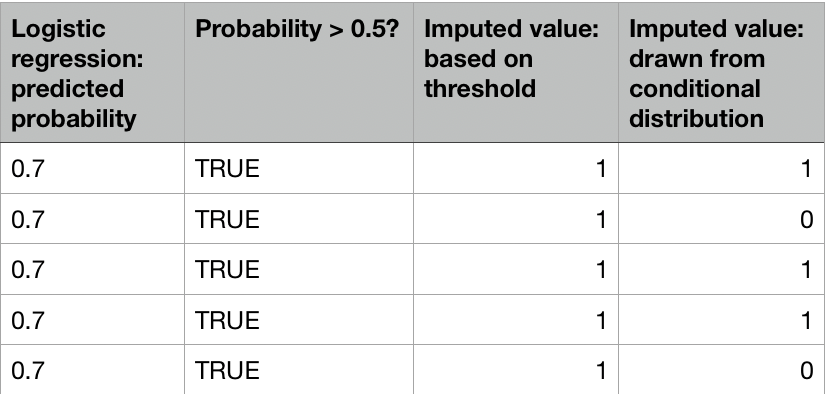
Imputare prin regresie logistică
Sarcină: imputați PhysActive din datele nhanes cu regresie logistică.
nhanes_imp <- hotdeck(nhanes)
missing_physactive <- is.na(nhanes$PhysActive)
Imputare prin regresie logistică
Sarcină: imputați PhysActive din datele nhanes cu regresie logistică.
nhanes_imp <- hotdeck(nhanes)
missing_physactive <- is.na(nhanes$PhysActive)
logreg_model <- glm(PhysActive ~ Age + Weight + Pulse,
                    data = nhanes_imp, family = binomial)
Imputare prin regresie logistică
Sarcină: imputați PhysActive din datele nhanes cu regresie logistică.
nhanes_imp <- hotdeck(nhanes)
missing_physactive <- is.na(nhanes$PhysActive)
logreg_model <- glm(PhysActive ~ Age + Weight + Pulse,
                    data = nhanes_imp, family = binomial)
preds <- predict(logreg_model, type = "response")
Imputare prin regresie logistică
Sarcină: imputați PhysActive din datele nhanes cu regresie logistică.
nhanes_imp <- hotdeck(nhanes)
missing_physactive <- is.na(nhanes$PhysActive)
logreg_model <- glm(PhysActive ~ Age + Weight + Pulse,
                    data = nhanes_imp, family = binomial)
preds <- predict(logreg_model, type = "response")
preds <- ifelse(preds >= 0.5, 1, 0)
Imputare prin regresie logistică
Sarcină: imputați PhysActive din datele nhanes cu regresie logistică.
nhanes_imp <- hotdeck(nhanes)
missing_physactive <- is.na(nhanes$PhysActive)
logreg_model <- glm(PhysActive ~ Age + Weight + Pulse,
                    data = nhanes_imp, family = binomial)
preds <- predict(logreg_model, type = "response")
preds <- ifelse(preds >= 0.5, 1, 0)
nhanes_imp[missing_physactive, "PhysActive"] <- preds[missing_physactive]
Imputare prin regresie logistică
Variabilitatea datelor imputate:
table(preds[missing_physactive])
 1
26
Variabilitatea datelor observate PhysActive:
table(nhanes$PhysActive)
  0   1
181 610
Eșantionare din probabilități de clasă
nhanes_imp <- hotdeck(nhanes)
missing_physactive <- is.na(nhanes$PhysActive)
logreg_model <- glm(PhysActive ~ Age + Weight + Pulse,
                    data = nhanes_imp, family = binomial)
preds <- predict(logreg_model, type = "response")
preds <- ifelse(preds >= 0.5, 1, 0)
nhanes_imp[missing_physactive, "PhysActive"] <- preds[missing_physactive]
Eșantionare din probabilități de clasă
nhanes_imp <- hotdeck(nhanes)
missing_physactive <- is.na(nhanes$PhysActive)
logreg_model <- glm(PhysActive ~ Age + Weight + Pulse,
                    data = nhanes_imp, family = binomial)
preds <- predict(logreg_model, type = "response")

nhanes_imp[missing_physactive, "PhysActive"] <- preds[missing_physactive]
Eșantionare din probabilități de clasă
nhanes_imp <- hotdeck(nhanes)
missing_physactive <- is.na(nhanes$PhysActive)
logreg_model <- glm(PhysActive ~ Age + Weight + Pulse,
                    data = nhanes_imp, family = binomial)
preds <- predict(logreg_model, type = "response")
preds <- rbinom(length(preds), size = 1, prob = preds)
nhanes_imp[missing_physactive, "PhysActive"] <- preds[missing_physactive]
Eșantionare din probabilități de clasă
Variabilitatea datelor imputate:
table(preds[missing_physactive])
0  1
5 21
Variabilitatea datelor observate PhysActive:
table(nhanes$PhysActive)
  0   1
181 610
Să exersăm replicarea variabilității datelor!
Gestionarea datelor lipsă prin imputare în R

