Imputarea k-Nearest-Neighbors

Gestionarea datelor lipsă prin imputare în R

Michal Oleszak

Machine Learning Engineer

Imputarea k-Nearest-Neighbors
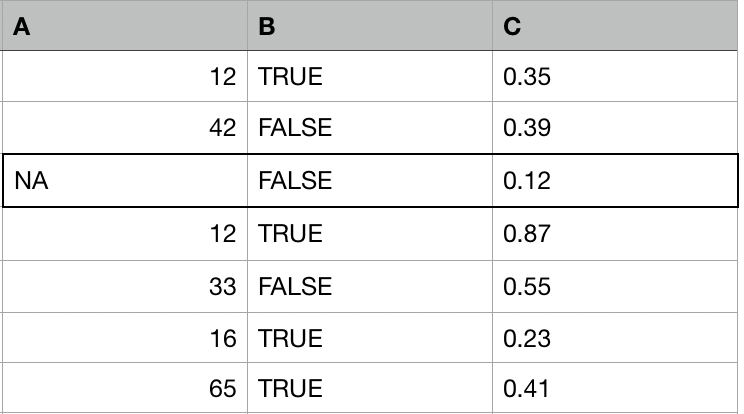
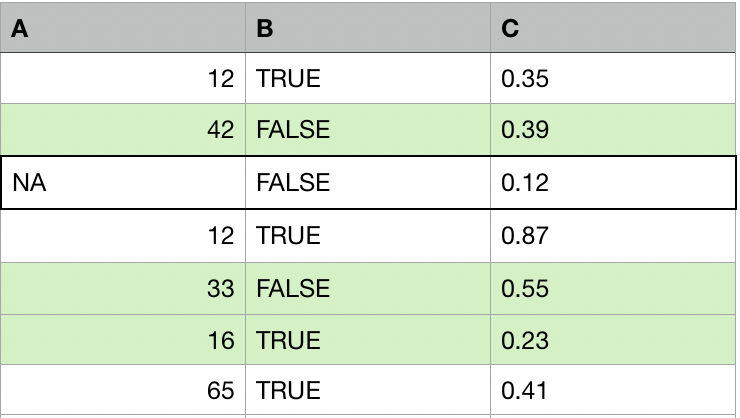
Un tabel cu trei coloane: A, B și C. Există o valoare lipsă în coloana A.

Gestionarea datelor lipsă prin imputare în R

Imputarea k-Nearest-Neighbors

Un tabel cu trei coloane: A, B și C. Există o valoare lipsă în coloana A. Trei dintre rândurile fără valori lipsă sunt evidențiate colorat.

Pentru fiecare observație cu valori lipsă:

  1. Se identifică alte k observații (donori, vecini) cele mai similare cu aceasta.
Gestionarea datelor lipsă prin imputare în R

Imputarea k-Nearest-Neighbors

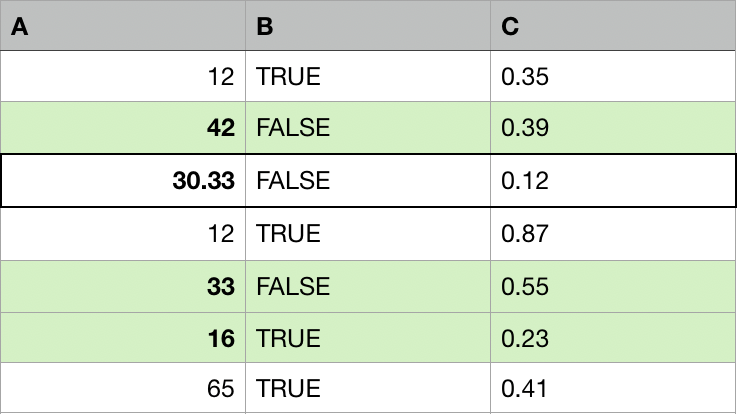
Un tabel cu trei coloane: A, B și C. Trei rânduri fără valori lipsă sunt evidențiate colorat. Valoarea lipsă din A a fost înlocuită cu media valorilor din aceeași coloană în rândurile evidențiate.

Pentru fiecare observație cu valori lipsă:

  1. Se identifică alte k observații (donori, vecini) cele mai similare cu aceasta.
  2. Valorile lipsă sunt înlocuite cu valori agregate de la cei k donori (medie, mediană, modă).
Gestionarea datelor lipsă prin imputare în R

Măsuri de distanță

Distanța dintre două observații a și b:

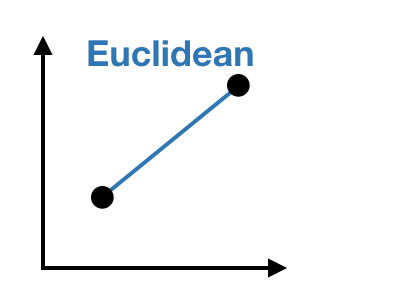
Distanța Euclidiană pentru n variabile numerice:

$\sqrt{\Sigma_{i=1}^{n} (a_i - b_i)^{2}}$

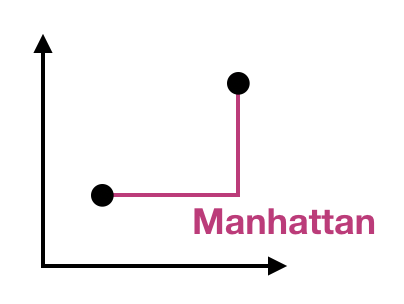
Distanța Manhattan pentru f variabile factor:

$\Sigma_{i=1}^{f} |a_i - b_i|$

Distanța Hamming pentru c variabile categoriale:

$\Sigma_{i=1}^{c} I(a_i \neq b_i)$

Un sistem de coordonate cu două puncte unite printr-o linie dreaptă.

Un sistem de coordonate cu două puncte unite prin două linii perpendiculare, ca și cum punctele ar fi colțurile opuse ale unui dreptunghi.

Gestionarea datelor lipsă prin imputare în R

Distanța Gower

Un cadru de date simulat care conține trei tipuri de variabile, fiecare evidențiat cu o culoare diferită: variabile numerice, factor și categoriale.

Gestionarea datelor lipsă prin imputare în R

Distanța Gower

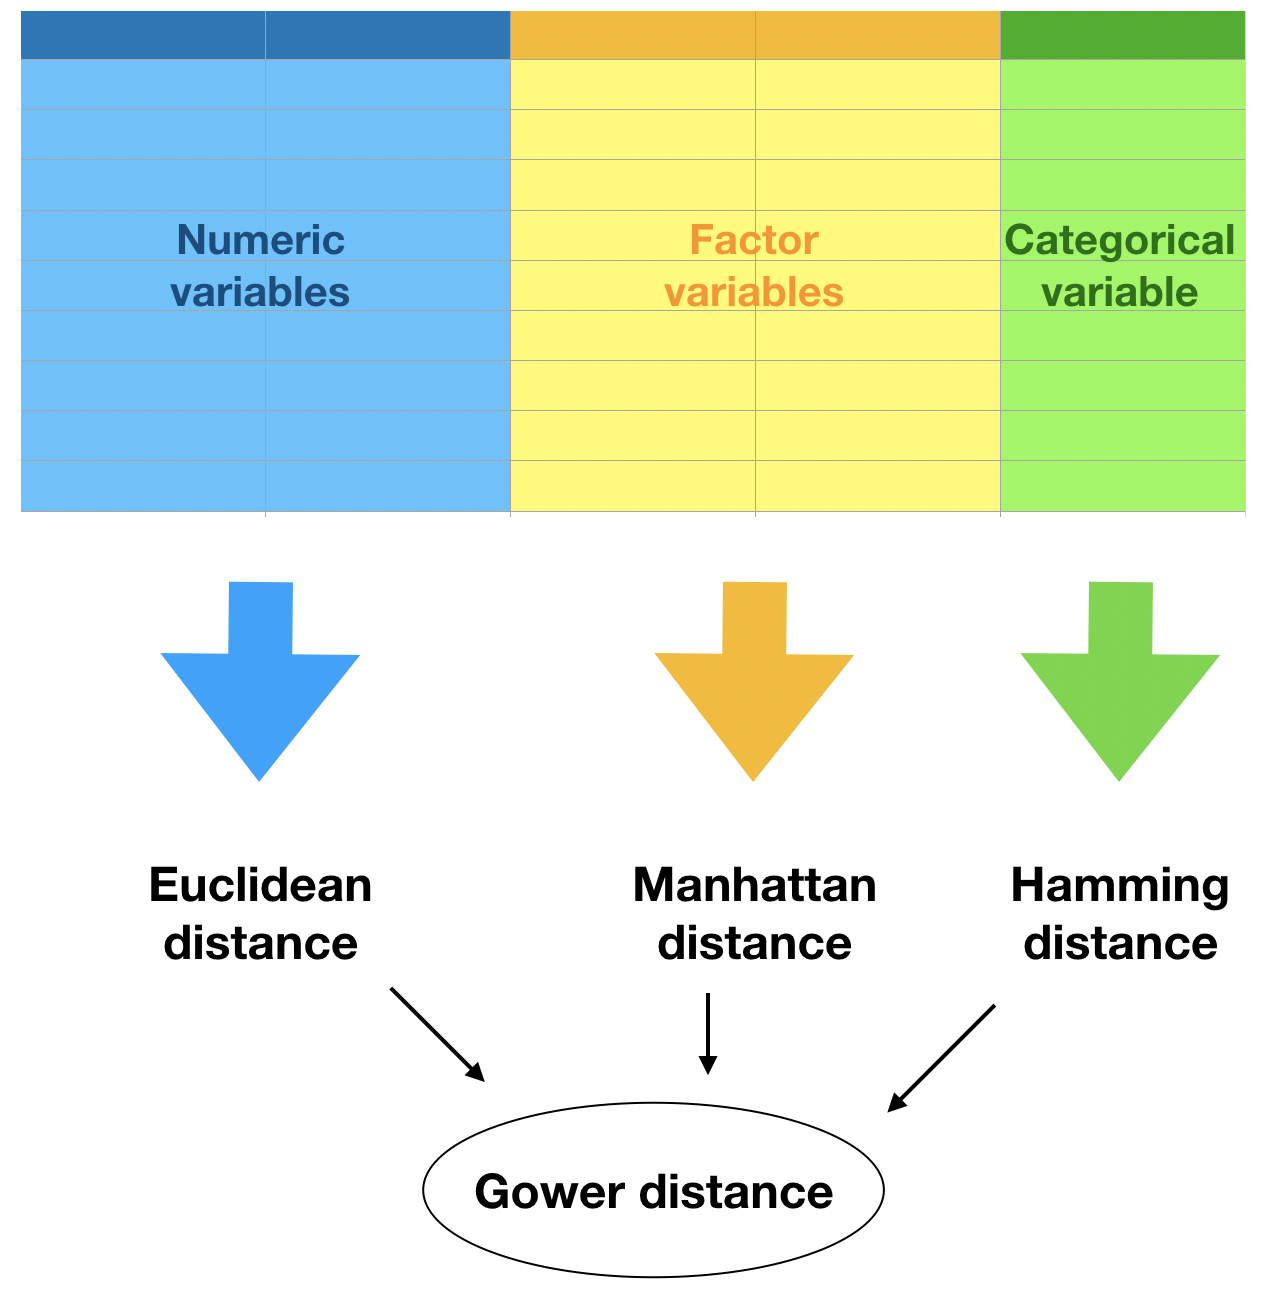
Un cadru de date simulat care conține trei tipuri de variabile, fiecare evidențiat cu o culoare diferită: numerice, factor și categoriale. Fiecărui tip îi este asociată o săgeată către măsura de distanță corespunzătoare: Euclidiană, Manhattan și Hamming. Cele trei măsuri indică o elipsă cu distanța Gower, combinația celor trei.

Gestionarea datelor lipsă prin imputare în R

Imputarea kNN în practică

library(VIM)
nhanes_imp <- kNN(nhanes, k = 5, variable = c("TotChol", "Pulse"))
head(nhanes_imp)
  Age Gender Weight Height Diabetes TotChol Pulse PhysActive TotChol_imp Pulse_imp
1  16   male   73.2  172.0    FALSE    3.00    76       TRUE       FALSE     FALSE
2  17   male   72.3  176.0    FALSE    2.61    74       TRUE       FALSE     FALSE
3  12   male   57.7  158.9    FALSE    4.27    80       TRUE       FALSE     FALSE
4  16   male   88.9  183.3    FALSE    3.62    58       TRUE       FALSE     FALSE
5  13 female   45.1  157.6    FALSE    2.66    92       TRUE       FALSE     FALSE
6  16 female   48.7  158.4    FALSE    4.32    58      FALSE       FALSE     FALSE
Gestionarea datelor lipsă prin imputare în R

Ponderarea donorilor

  • Dintre cei k vecini aleși pentru o observație, unii îi sunt mai similari decât alții.
  • Poate fi util să acordăm o pondere mai mare vecinilor mai apropiați la agregarea valorilor.
  • Se agregă vecinii printr-o medie ponderată, cu ponderi date de distanțele inverse față de fiecare vecin.
  • Aceasta este posibilă doar pentru imputarea variabilelor numerice.
nhanes_imp <- nhanes %>% 
  kNN(variable = c("TotChol", "Pulse"),
      k = 5,
      numFun = weighted.mean,
      weightDist = TRUE)
Gestionarea datelor lipsă prin imputare în R

Sortarea variabilelor

  • Algoritmul kNN parcurge variabilele și le imputează pe rând.
  • De fiecare dată, distanțele dintre observații sunt recalculate.
  • Dacă prima variabilă avea multe valori lipsă, calculul distanțelor pentru a doua variabilă se va baza pe multe valori imputate.
  • Este recomandat să sortați variabilele în ordine crescătoare după numărul de valori lipsă înainte de a rula kNN.
Gestionarea datelor lipsă prin imputare în R

Sortarea variabilelor în practică

vars_by_NAs <- nhanes %>% 
  is.na() %>%
  colSums() %>%
  sort(decreasing = FALSE) %>% 
  names()
nhanes_imp <- nhanes %>% 
  select(vars_by_NAs) %>% 
  kNN(k = 5)
Gestionarea datelor lipsă prin imputare în R

Să exersăm imputarea kNN!

Gestionarea datelor lipsă prin imputare în R

Preparing Video For Download...