Modele de clustering cu confidențialitate diferențială

Confidențialitatea datelor și anonimizarea în Python

Rebeca Gonzalez

Data engineer

Compararea modelelor
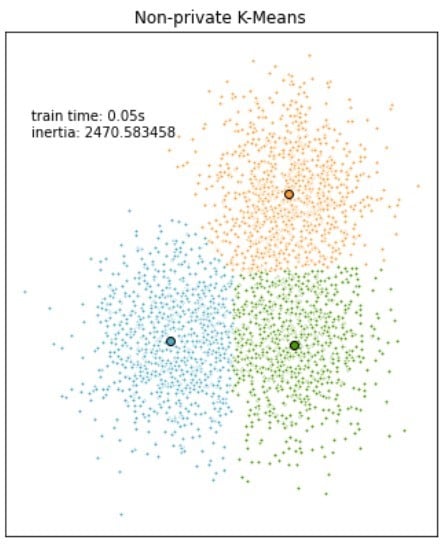
Imagine cu 3 clustere în date, după clustering cu k-means neconfidențial

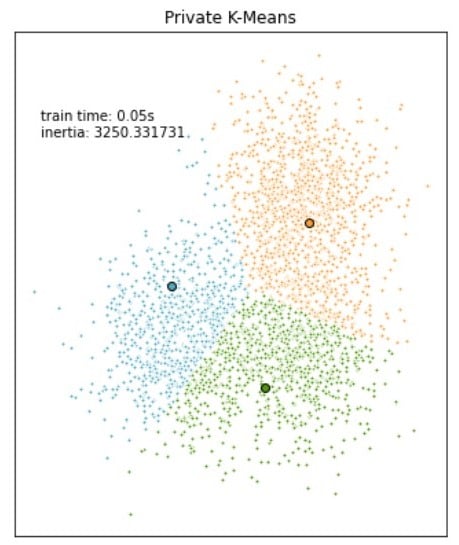
Imagine cu 3 clustere în date, după clustering cu k-means confidențial

Confidențialitatea datelor și anonimizarea în Python

Compararea modelelor

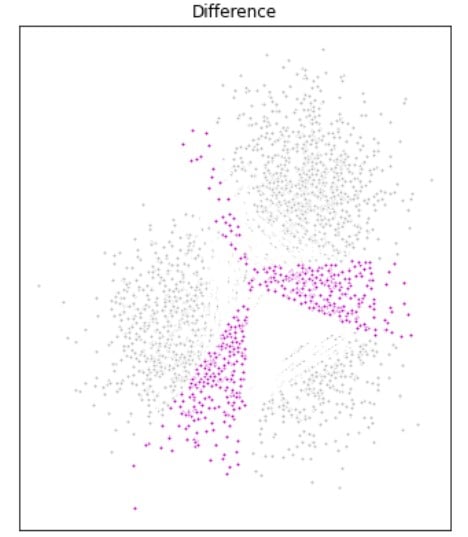
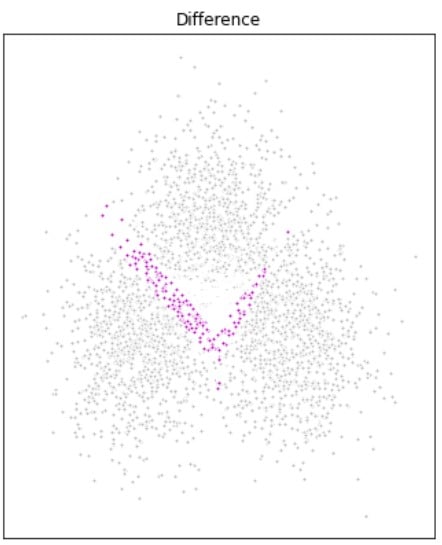
Imagine cu diferența dintre cele două rezultate de clustering, afișată ca puncte roz

  • Diferența dintre clusterele rezultate de cele două modele
  • Majoritatea rezultatelor sunt comune
Confidențialitatea datelor și anonimizarea în Python

Construirea modelelor de clustering cu confidențialitate diferențială

from diffprivlib.models import KMeans

# Computing the clusters with the DP model model = KMeans(epsilon=1, n_clusters=3)
# Run the model and obtain clusters clusters = model.fit_predict(X)
Confidențialitatea datelor și anonimizarea în Python

Îmbunătățirea modelelor de clustering DP
  • Datele pot fi preprocesate înainte de clustering.
  • Scalarea caracteristicilor (ex. StandardScaler) și reducerea dimensionalității prin PCA.
    • Pentru a reduce inerția modelului
    • Obținerea unor grupuri de segmentare mai precise
  • Se utilizează diffprivlib la fel ca modelele sklearn.
Confidențialitatea datelor și anonimizarea în Python

Îmbunătățirea modelelor de clustering DP
from sklearn.decomposition import PCA

# Initialize PCA pca = PCA()
# Fit transform data with PCA X = pca.fit_transform(X)
# Computing the clusters with the DP model model = dp_Kmeans(epsilon=1, n_clusters=3)
# Run the model and obtain clusters clusters = model.fit_predict(X)
Confidențialitatea datelor și anonimizarea în Python

Îmbunătățirea modelelor de clustering DP

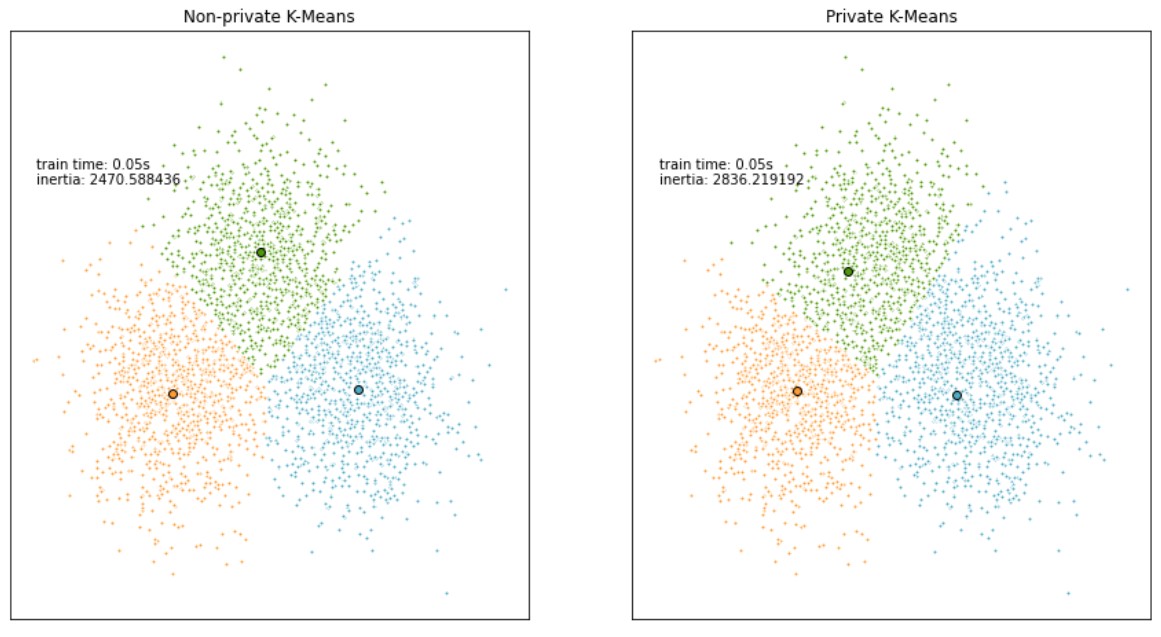
Imagine cu două diagrame de dispersie cu clusterele rezultate

Confidențialitatea datelor și anonimizarea în Python

Îmbunătățirea modelelor de clustering DP

Imagine cu diferența dintre cele două rezultate de clustering, afișată ca puncte roz

  • Rezultate îmbunătățite prin transformări ale datelor
Confidențialitatea datelor și anonimizarea în Python

Metoda cotului

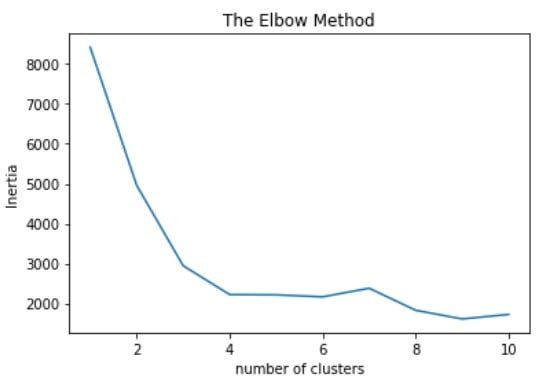
Imagine cu graficul rezultat după aplicarea metodei cotului pe date

Confidențialitatea datelor și anonimizarea în Python

Epsilon

from diffprivlib.models import KMeans as model

# Computing the clusters with the DP model model = dp_Kmeans(epsilon=0.2, n_clusters=3)
# Run the model and obtain clusters clusters = model.fit_predict(X)
Confidențialitatea datelor și anonimizarea în Python

Epsilon

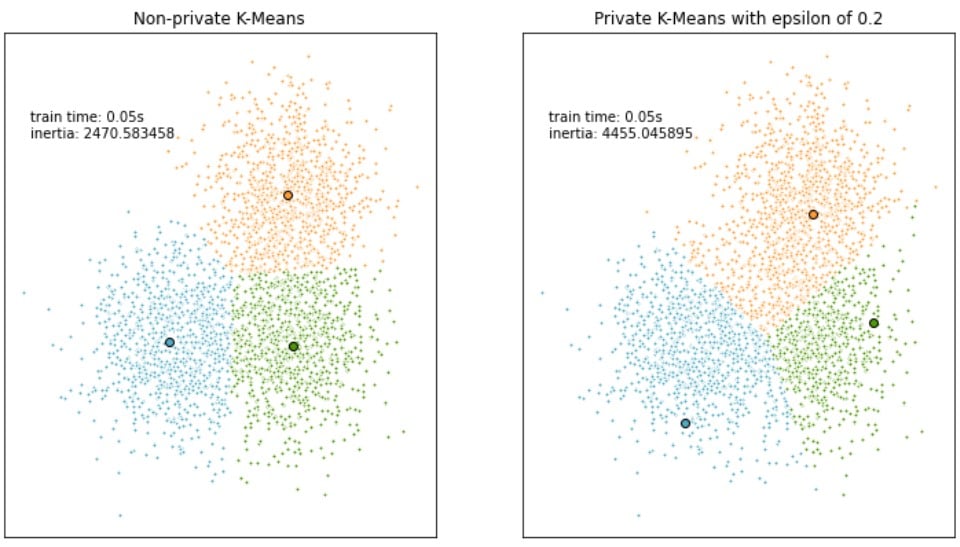
Imagine cu două diagrame de dispersie cu clusterele rezultate

Confidențialitatea datelor și anonimizarea în Python

Să exersăm!

Confidențialitatea datelor și anonimizarea în Python

Preparing Video For Download...