Confidențialitatea datelor și anonimizarea în Python
Rebeca Gonzalez
Data engineer
Tehnică ce permite înlocuirea valorilor din date cu unele mai puțin precise.
Scopul este eliminarea unor identificatori, păstrând utilitatea datelor pentru analiză.
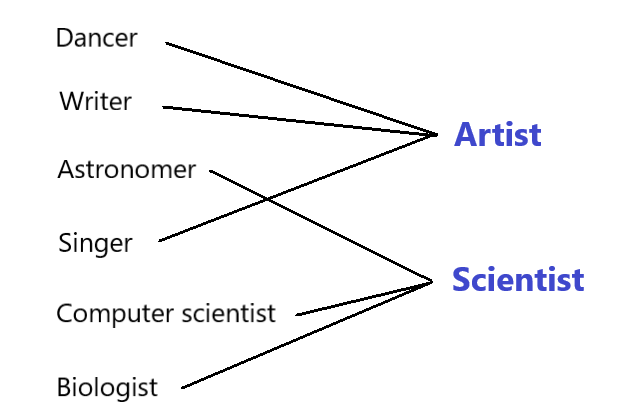
Permite înlocuirea unei valori cu una mai generală: „Dansator" -> „Artist"
name location
0 Amanda Hooper 146 Rodgers Field\nGregoryview, MS 71630
1 Sarah Smith 817 Garcia Shoal\nJonesville, AR 30299
2 Sean Boyd III 1938 90th St\nDallas, TX 59715
name location
0 Amanda Hooper 998 Boone Estate\nReedborough, MS 71630
1 Sarah Smith 7255 Shelby Rapids Apt. 455\nKarenland, AK 30299
2 Sean Boyd III 791 Crist Parks\nGreenton, TX 59715
# Original data
df_employees.head()
first name last name age ssn
0 Amber Brown 91 798-29-4785
1 William Gibson 34 431-66-8381
2 Daniel Lee 92 825-91-5550
3 Andrea Stevenson 64 188-59-3544
4 Julie Horn 35 020-60-6388
# Generalized data: Age in intervals and masked SSN
generalized_df.head()
First name Last name Age SSN
0 Amber Brown (80, 99] 798-**-****
1 William Gibson (30, 50] 431-**-****
2 Daniel Lee (80, 99] 825-**-****
3 Andrea Stevenson (60, 80] 188-**-****
4 Julie Horn (30, 50] 020-**-****
Cei cu 34 de ani vor fi plasați într-un interval de 30 până la 50. Aceasta se numește și grupare în intervale (binning).

# Explore the dataset
df_medical.head()
age gender department condition
0 30 F Finance Anxiety disorders
1 42 M Production Bronchitis
2 35 F Marketing Dysthymia
3 39 F Production Dysthymia
4 40 M Marketing Flu
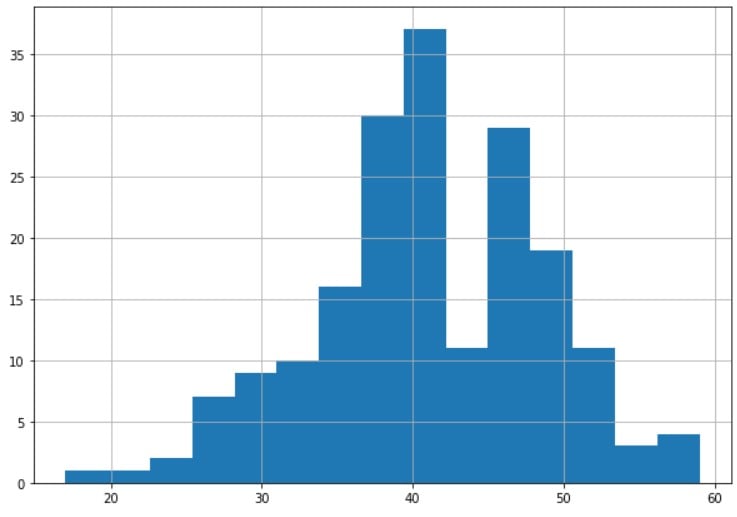
# Explore the histogram of the age variable
df_medical['age'].hist(bins=15)
# Apply generalization by transforming to binary data df_medical['age'] = df_medical['age'].apply(lambda x:">=40" if x>=40 else "<40" )# See results df_medical.head()
age gender department condition
0 <40 F Finance Bronchitis
1 >=40 M Production Bronquitis
2 <40 F Finance Dysthymia
3 <40 F Production Dysthymia
4 >=40 M Marketing Flu
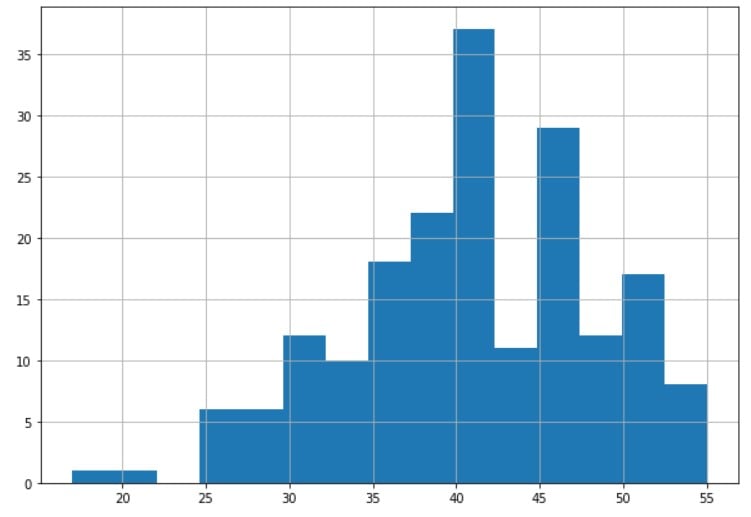
# Explore the histogram of the age variable
df_medical['age'].hist(bins=15)
# Filter to see rows affected
df_medical[df_medical['age'] >= 55]
age gender department condition
26 56 F Production Flu
65 55 M Finance Dysthymia
126 59 F Production Anxiety disorders
139 58 F Finance Dysthymia
142 59 M Marketing Flu
145 57 M Marketing Anxiety disorders
# Top code the age to 55 df_medical.loc[df_medical['age'] > 55, 'age'] = 55# Filter to see rows affected df_medical[df_medical['age'] >= 55]
age gender department condition
26 55 F Production Flu
65 55 M Finance Dysthymia
126 55 F Production Anxiety disorders
139 55 F Finance Dysthymia
142 55 M Marketing Flu
145 55 M Marketing Anxiety disorders
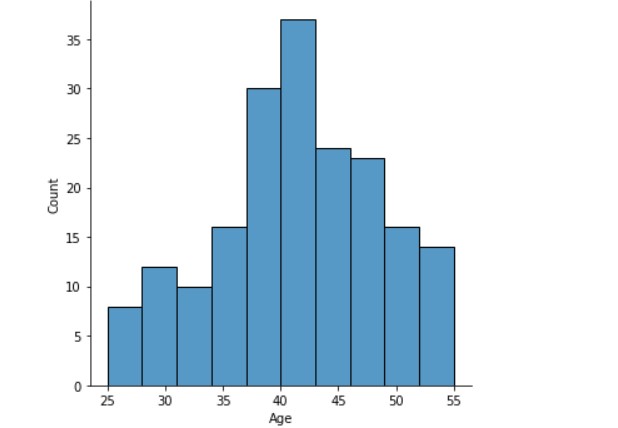
# Explore the histogram of the age variable
df_medical['age'].hist(bins=15)

# Bottom code the age to 25 df_medical.loc[df['age'] < 25, 'age'] = 25# Explore the histogram of the age variable df_medical['age'].hist(bins=15)
Optim când este combinat cu Supresie și Mascare, urmând un Model de confidențialitate precum K-anonimitate.
Specificați condiții pe care setul de date trebuie să le îndeplinească pentru a controla riscul de dezvăluire.
Vom vedea cum să implementăm acest model de confidențialitate în capitolul următor!
Confidențialitatea datelor și anonimizarea în Python