Măsurarea beneficiilor
Programare paralelă în R

Nabeel Imam
Data Scientist
Exemplu simplu
numbers <- 1:1000000# Sequential sqroots <- lapply(numbers, sqrt)# Parallel cl <- makeCluster(4) sqroots <- parLapply(cl, numbers, sqrt) stopCluster(my_cluster)
Care va fi mai rapid?
Benchmarking-ul performanței
Rulați codul de mai multe ori pentru a estima timpul mediu de execuție
library(microbenchmark)microbenchmark( "Sequential" = lapply(numbers, sqrt),"Parallel" = { cl <- makeCluster(4) parLapply(cl, numbers, sqrt) stopCluster(my_cluster) },times = 10 )
Unit: milliseconds
      expr     min    mean     max neval
Sequential  633.96  838.09  993.59    10
  Parallel 1136.95 1247.29 1557.58    10
- Operațiile numerice simple beneficiază rar de paralelizare
- Profilarea oferă un raport linie cu linie, benchmarking-ul oferă timpii totali de execuție
Elefantul din cameră
sqroots <- sqrt(numbers)
Vectorizare
sqroots <- sqrt(numbers)
- Funcțiile de bază din R, precum
sqrt(), sunt vectorizate. - Aplică o singură funcție pentru multiple intrări
- Foarte rapide, dar aplicabile doar operațiilor simple
microbenchmark(
  "Vectorized" = sqrt(numbers),
  "Sequential" = lapply(numbers, sqrt),
  "Parallel" = {
    cl <- makeCluster(4)
    parLapply(cl, numbers, sqrt)
    stopCluster(my_cluster)
  },
  times = 10)
Unit: milliseconds
      expr       min      mean      max neval
Vectorized    2.3904    9.2071   66.303    10
Sequential  352.1166  771.7491 1004.753    10
  Parallel 1191.3176 1377.6926 1700.316    10
Bootstrap
Eșantionare din datele curente cu înlocuire
print(ls_df)
$`2001`
   Country             Life_expectancy  Year
 1 Afghanistan                    56.3  2001
 2 Albania                        74.3  2001
 3 Algeria                        71.1  2001
...
$`2002`
   Country             Life_expectancy  Year
 1 Afghanistan                    56.8  2002
 2 Albania                        74.6  2002
 3 Algeria                        71.6  2002
...
Versiunea clasică
df <- ls_df$`2001`estimates <- rep(0, 10000)for (i in 1:10000) { b <- sample(df$Life_expectancy, replace = T)estimates[i] <- mean(b) }
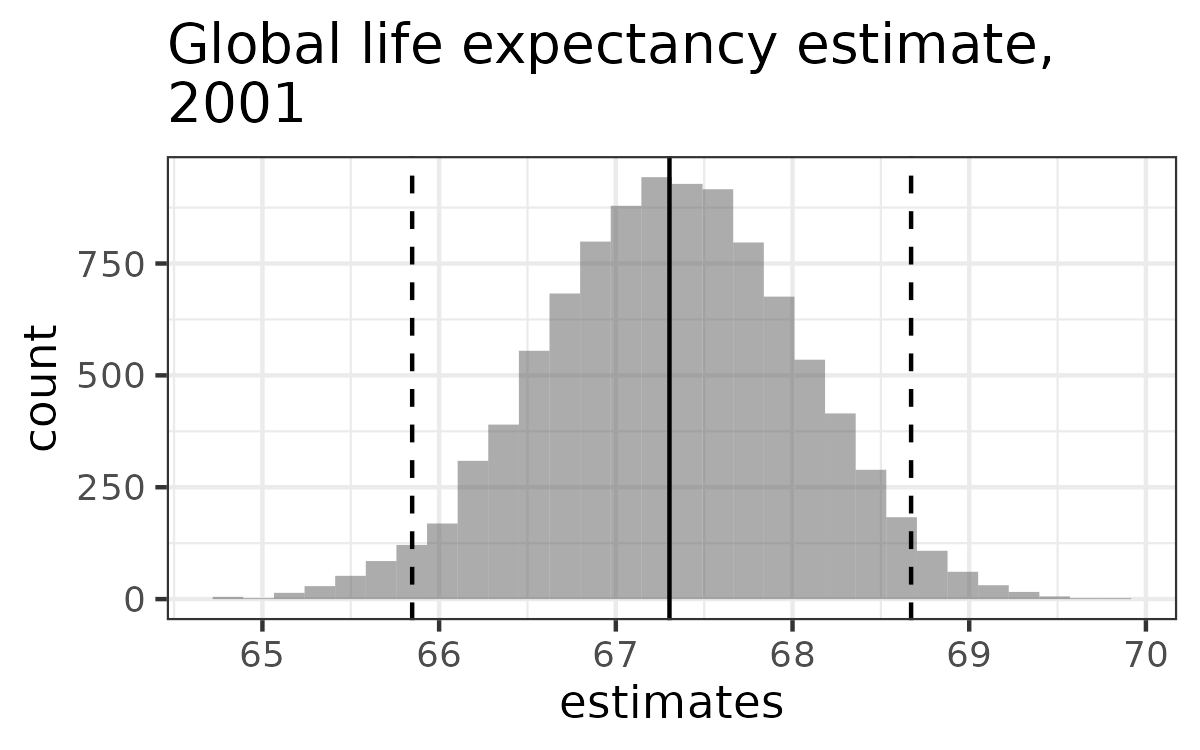
- Interval de încredere folosind cuantile:
quantile(estimates, c(0.025, 0.975))
Vestea bună
Bootstrap-urile pot fi paralelizate
estimates <- rep(0, 10000)

for (i in 1:10000) {

  b <- sample(df$Life_expectancy,
              replace = T)

  estimates[i] <- mean(b)
  }
boot_dist <- function (df) { estimates <- rep(0, 10000) for (i in 1:10000) { b <- sample(df$Life_expectancy, replace = T) estimates[i] <- mean(b) } return(estimates) }cl <- makeCluster(4) ls_dists <- parLapply(cl, ls_df, boot_dist) stopCluster(cl)
Beneficiile
microbenchmark(
  "lapply" = lapply(ls_df, boot_dist),
  "parLapply" = {
    cl <- makeCluster(4)
    parLapply(cl, ls_df, boot_dist)
    stopCluster(cl)
  },
  times = 10
)
Unit: seconds
     expr    min   mean    max neval
   lapply 3.6938 4.2184 4.5267    10
parLapply 1.9006 2.5166 2.7292    10
Cum se procedează:
- Profilați codul, identificați partea cea mai lentă
- Paralelizați/optimizați acest pas
- Benchmarking și comparare
Să exersăm!
Programare paralelă în R

