Monitorizarea și gestionarea memoriei

Programare paralelă în R

Nabeel Imam

Data Scientist

Coada și spațiul
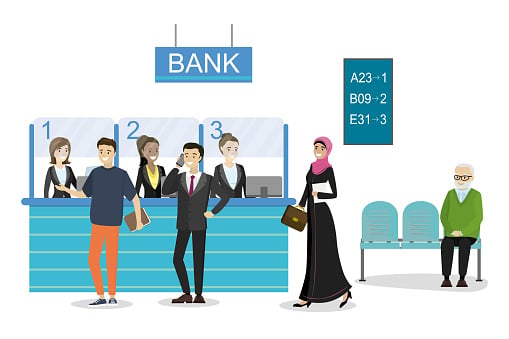
Trei casieri servesc clienți la o bancă, în timp ce alți clienți așteaptă la rând.

Programare paralelă în R

Fluxul paralel

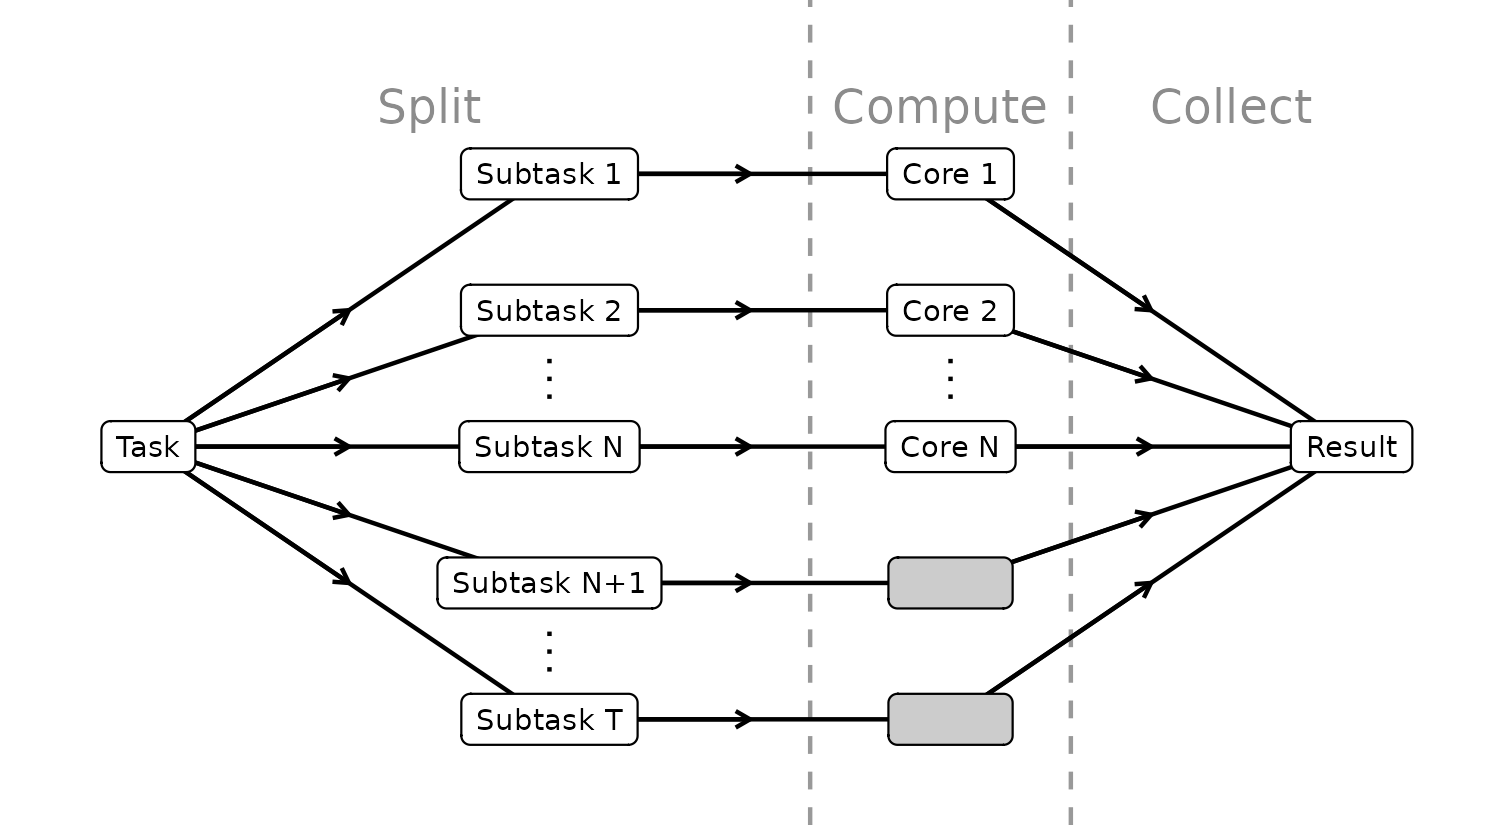
Este ilustrat un flux paralel în care o sarcină este împărțită în mai multe subsarcini. Acestea sunt executate de nuclee diferite, iar rezultatele sunt combinate.

Programare paralelă în R

Fluxul paralel

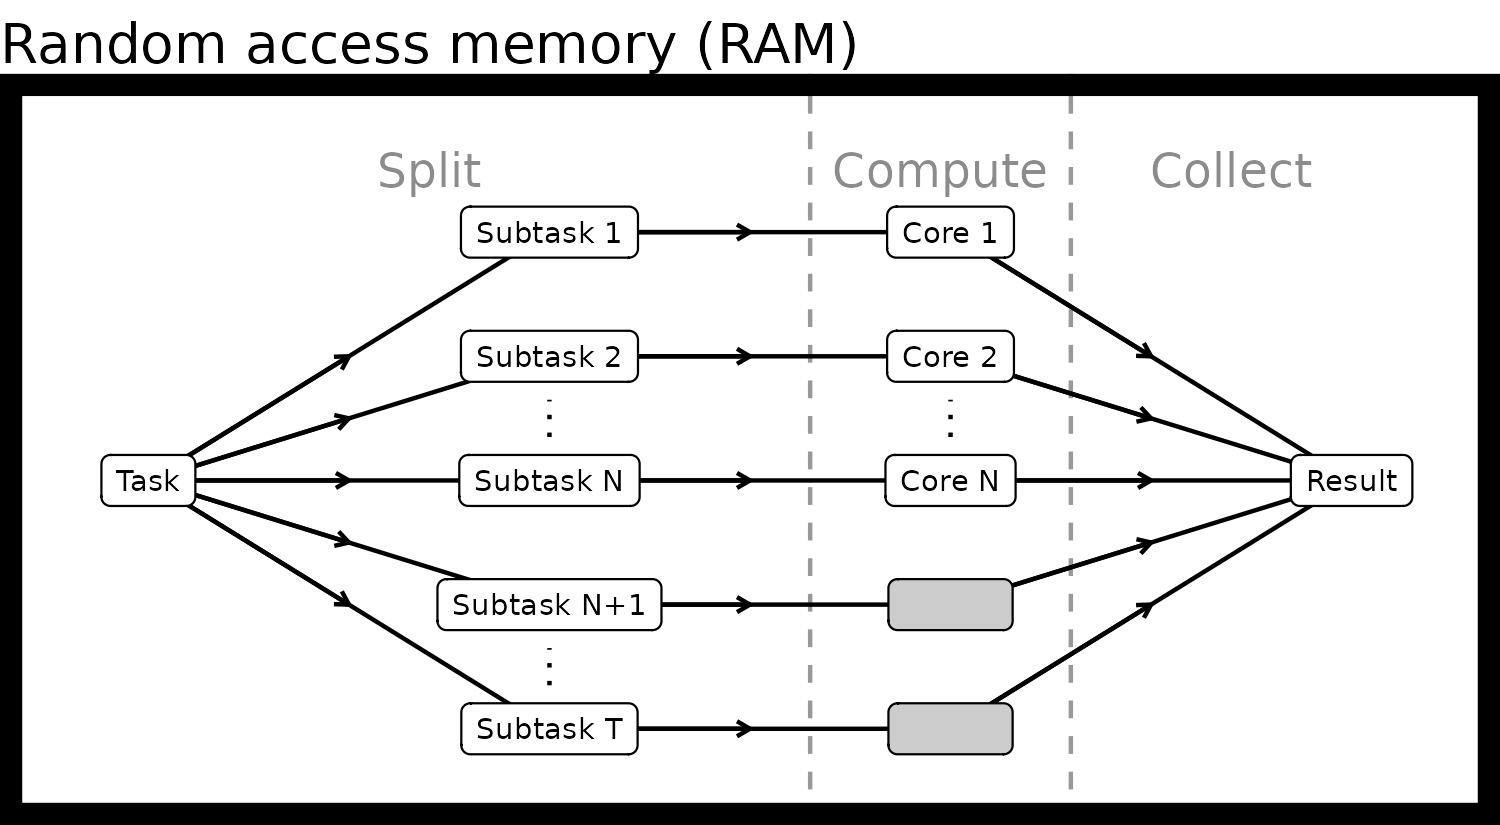
Fluxul de lucru paralel este stocat în memoria cu acces aleatoriu (RAM).

Programare paralelă în R

Datele births

print(ls_files)
 [1] "./births/AK.csv"
 [2] "./births/AL.csv"
 [3] "./births/AR.csv"
 [4] "./births/AZ.csv"
 [5] "./births/CA.csv"
 [6] "./births/CO.csv"
 [7] "./births/CT.csv"
 [8] "./births/DC.csv"
 [9] "./births/DE.csv"
 [10] "./births/FL.csv"
...
Programare paralelă în R

Mapare cu futures

plan(multisession, workers = 2)

ls_df <- future_map(ls_files, read.csv)
plan(sequential)
print(ls_df)
[[1]]
   state month plurality weight_gain_pounds mother_age
      AK     1         1                 30         43
   ...
[[2]]
   state month plurality weight_gain_pounds mother_age
      AL    10         1                 60         33
   ...
...
Programare paralelă în R

Profilare cu doi workeri

profvis({
  plan(multisession, workers = 2)
  ls_df <- future_map(ls_files, read.csv)
  plan(sequential)
})

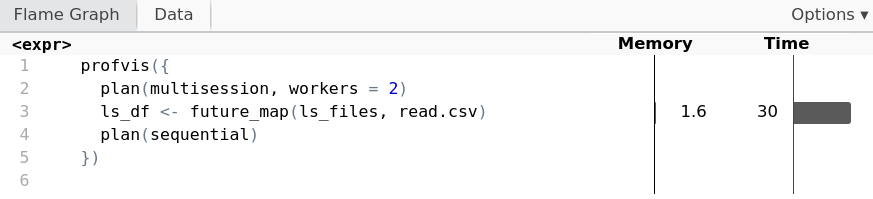
Rezultatul profilării codului generat de funcția profvis. Citirea fișierelor CSV în paralel cu doi workeri folosind future_map utilizează 1,6 megaocteți de memorie, în timp ce celelalte linii de cod nu înregistrează nicio utilizare.

Programare paralelă în R

Profilare cu patru workeri

profvis({
  plan(multisession, workers = 4)
  ls_df <- future_map(ls_files, read.csv)
  plan(sequential)
})

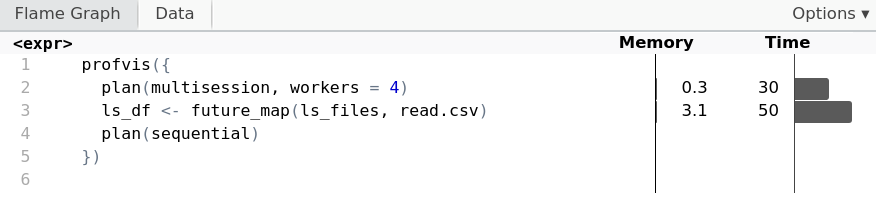
Rezultatul profilării codului generat de funcția profvis. Citirea fișierelor CSV în paralel cu patru workeri folosind future_map utilizează 3,1 megaocteți de memorie, iar planificarea multisession utilizează 0,3 megaocteți.

Programare paralelă în R

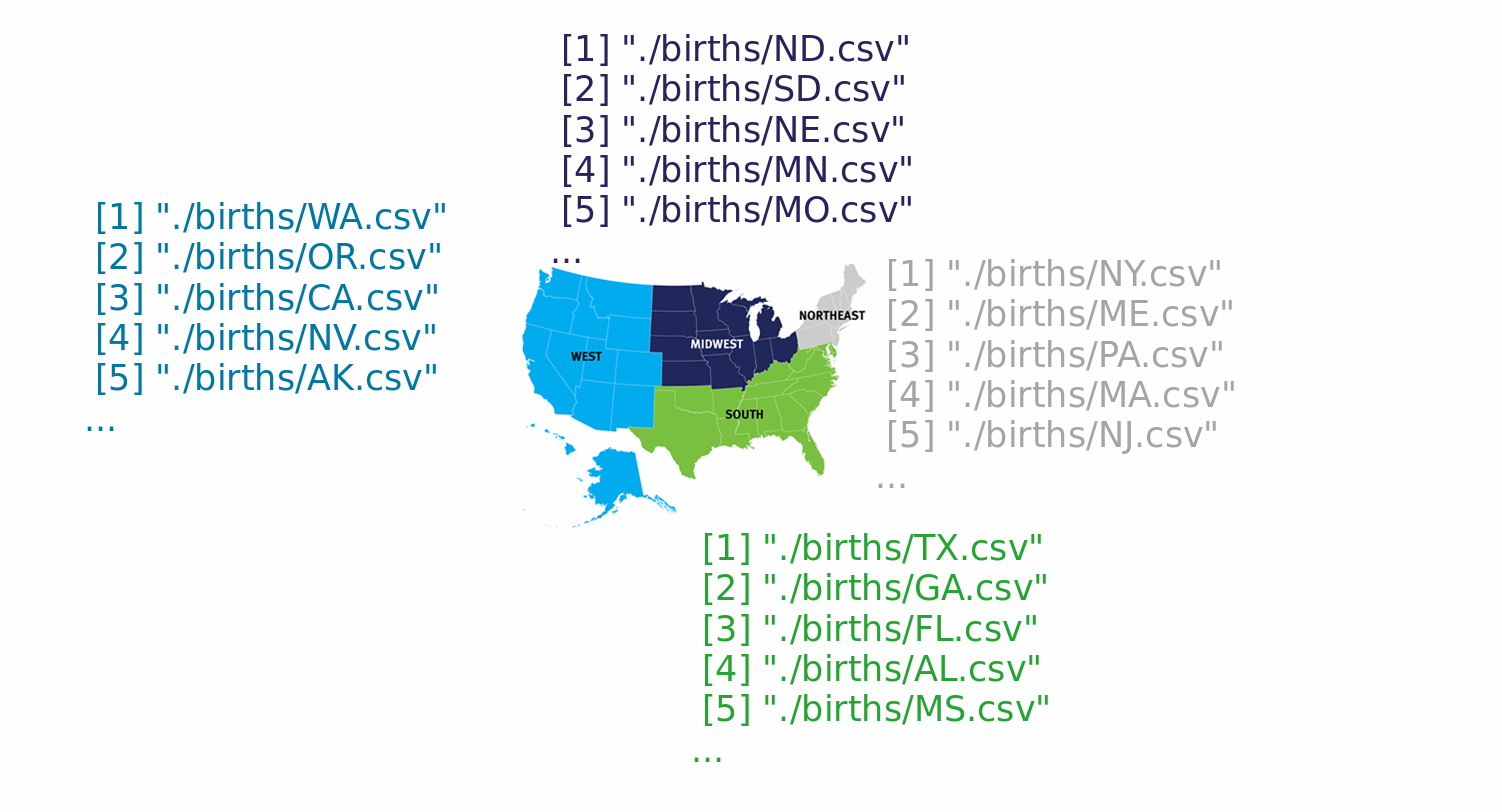
Ce se întâmplă în fundal

O hartă a SUA, împărțită în patru regiuni: Vest, Midwest, Sud și Nord-Est. Fiecare regiune corespunde unei liste de fișiere CSV cu date pentru fiecare stat din regiune.

Programare paralelă în R

Gestionarea memoriei prin chunking

config <- furrr_options(chunk_size = 26)

plan(multisession, workers = 4) ls_df <- future_map(ls_files, read.csv,
.options = config) plan(sequential)
Programare paralelă în R

Gestionarea memoriei prin chunking

profvis({
  config <- furrr_options(chunk_size = 26)
  plan(multisession, workers = 4)
  ls_df <- future_map(ls_files, read.csv,
             .options = config)
  plan(sequential)
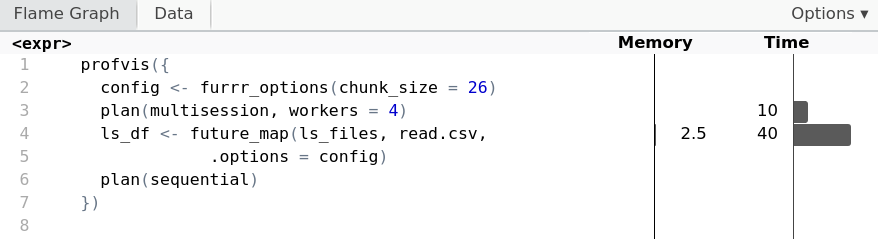
})

Rezultatul profilării codului generat de funcția profvis. Citirea fișierelor CSV în paralel cu patru workeri folosind future_map utilizează 2,5 megaocteți de memorie cu un chunk_size de 26.

Programare paralelă în R

Chunking cu parallel

cl <- makeCluster(4)


ls_df <- parLapply(cl, ls_files, read.csv)
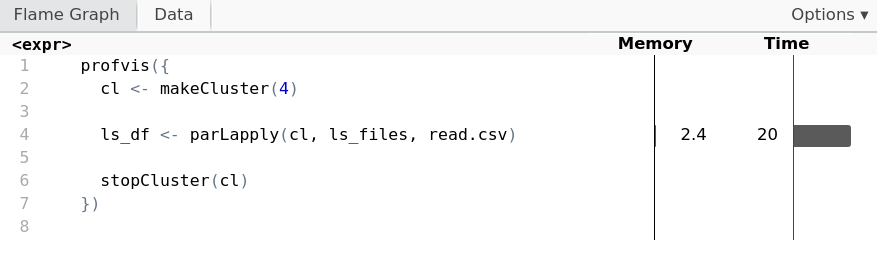
stopCluster(cl)

Citirea fișierelor CSV în paralel cu parLapply utilizează 2,4 megaocteți de memorie, toți folosiți în apelul parLapply.

Programare paralelă în R

Chunking cu parallel

cl <- makeCluster(4)
ls_df <- parLapply(cl, ls_files, read.csv,

chunk.size = 26)
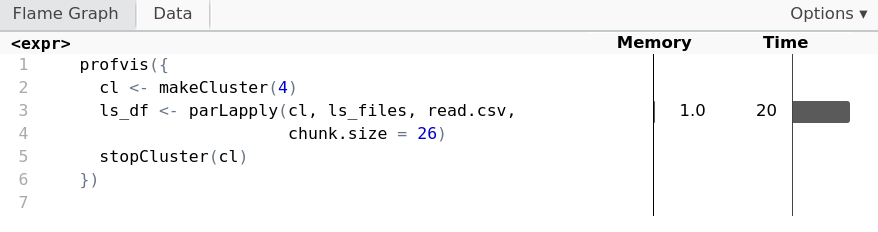
stopCluster(cl)

Citirea fișierelor CSV în paralel cu parLapply utilizează doar 1 megaoctet de memorie când chunk_size este setat la 26.

Programare paralelă în R

Când să folosiți chunking?

  • Chunking-ul este efectuat optim în mod implicit
  • Cu obiecte mari de date și memorie insuficientă
    • Încercați să utilizați mai puține nuclee, dacă este posibil
    • Experimentați cu câteva dimensiuni de chunk pentru a găsi optimul
Programare paralelă în R

Vamos praticar!

Programare paralelă în R

Preparing Video For Download...