Familia parallel apply

Programare paralelă în R

Nabeel Imam

Data Science

Creșterea în greutate în timpul sarcinii

print(ls_weights)
$AK
  [1] 30 33 50 30 26 99 52 28 24 40 30 99 40
 [14] 20 20 39 25 30 20 33 99 54 30 99 30 38
...
$AL
   [1] 60 32 30 21 30 27 28 32 18 28 30 24 59
  [14] 30 19 30 15 17 18 53 26  5 25 41 50 20
...
$AR
  [1] 31 40 30 99 27 36 30 35 25 19 10 25 40
 [14] 33 37 12 34 99 43 26 28 99 37 30 26  6
...
1 Date privind natalitatea de la CDC Births
Programare paralelă în R

FORK cu mclapply

boot_mean <- function (weights) {

  est <- rep(0, 1e4)

  for (i in 1:1e4) {
    b <- sample(weights, replace = T)
    est[i] <- mean(b)
  }

  return(est)
}

ls_boot <- mclapply(ls_weights, boot_mean,

mc.cores = 4)
  • Cu 20-40% mai rapid
  • Cluster FORK generat în fundal
    • Nu necesită configurare cluster
    • Nu funcționează pe Windows
Programare paralelă în R

Echilibrați sarcina cu parLapplyLB

Doi angajați au o sarcină de lucru mare, în timp ce un al treilea este inactiv.

lapply(ls_weights, length)
   AK    AL    AR    AZ    CA    CO    CT   DC    DE    FL    GA    HI    IA  ...
  260  1503   816  1649 14869  1286  1151  520   295  4693  2824   510   891  ...
1 Designed by Freepik
Programare paralelă în R

Echilibrați sarcina cu parLapplyLB

microbenchmark(
  "parLapply" = {
    cl <- makeCluster(4)
    ls <- parLapply(cl, ls_weights, boot_mean)
    stopCluster(cl)
  },
  "parLapplyLB" = {
    cl <- makeCluster(4)
    ls <- parLapplyLB(cl, ls_weights, boot_mean)
    stopCluster(cl)
  },
  times = 10
)
Unit: seconds
       expr      min     mean      max neval
  parLapply 15.77250 16.38548 16.83822    10
parLapplyLB 14.55609 15.49170 17.26866    10
  • Timpul mediu de execuție scade de la 16,4 secunde la 15,5 secunde (~ 5% reducere)
Programare paralelă în R

Mai multe argumente pentru iterare

add <- function (x, y, z) x + y + z


value1 <- c(0.5, 3.2, 5.1, 1.9) value2 <- c(0.1, 0.5, 0.2, 2.4) value3 <- 5
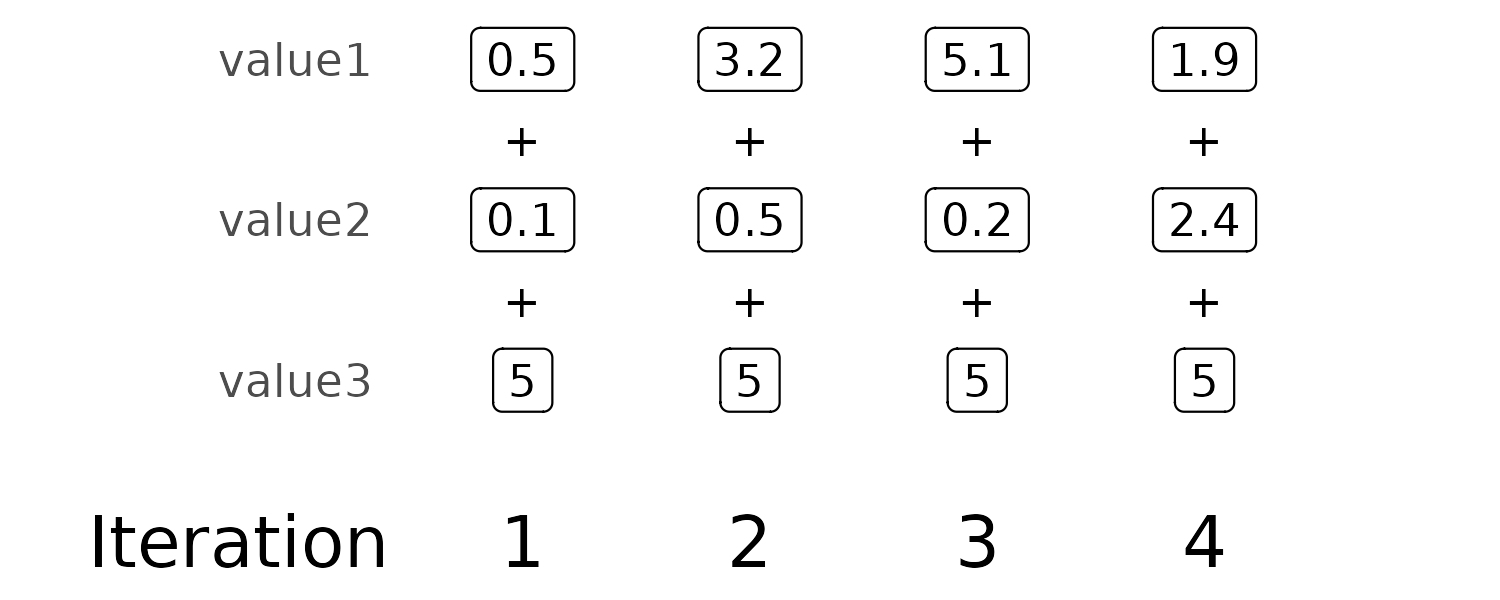
La prima iterație, primele elemente din value1, value2 și value3 sunt adunate. La a doua iterație, al doilea element din fiecare vector este adunat, și așa mai departe.

Programare paralelă în R

clusterMap

cl <- makeCluster(4)


clusterMap(cl, add,
x = value1, y = value2, z = value3) # Single value stopCluster(cl)
print(value3)
[1] 5
[[1]]
[1] 5.6

[[2]]
[1] 8.5

[[3]]
[1] 10.2

[[4]]
[1] 8.4
Programare paralelă în R

clusterMap vs. parLapply

clusterMap(cl,         # Cluster
           add,        # Function
           x = value1, # Multiple inputs
           y = value2,
           z = value3) # Could be single values to recycle
parLapply(cl,                # Cluster
          input,             # One input
          fun,               # Function
          arg_name = static) # Exported static variables
                             # supplied to named argument
Programare paralelă în R

Greutatea câștigată cu clusterMap

print(ls_weights)
$AK
  [1] 30 33 50 30 26 99 52 28 24 40 30 99 40
...
print(ls_plur)
$AK
  [1] 1 2 1 1 1 1 1 1 2 1 1 1 1 1 1 1 1 1 1 1
  ...
boot_dist <- function (weights, pluralities) {
  est <- rep(0, 1e4)
  ratio <- weights/pluralities
  for (i in 1:1e4) {
    b <- sample(ratio, replace = T)
    est[i] <- mean(b)
  }
  return(est)
}


cl <- makeCluster(4)
result <- clusterMap(cl, boot_dist,
weights = ls_weights, pluralities = ls_plur) stopCluster(cl)
Programare paralelă în R

Numărul total de nașteri

print(mat_births)
     1   2   3   4   5   6   7   8   9  10  11  12
AK   7  13   8   8   5   9  12  19  16  16   7  16
AL  55  58  79  66  48  63  69  81  74  76  61  82
AR  28  28  41  37  40  40  42  52  40  44  33  38
AZ  69  70  70  71  68  61  73  81  76  74  87  62
CA 603 599 659 601 669 719 675 687 660 698 703 633
CO  50  55  72  56  63  56  56  70  58  48  53  58
CT  51  51  57  58  59  41  51  46  54  56  58  52
DC  25  18  14  40  22  19  24  25  20  26  20  25
...
Programare paralelă în R

Operații pe rânduri și coloane în paralel

cl <- makeCluster(4)

# parCapply for column operations parCapply(cl, mat_births, sum)
# parRapply for row operations parRapply(cl, mat_births, sum) stopCluster(cl)
  • Sumă pe coloane

     1    2    3    4    5    6    7
    4258 3966 4437 4345 4371 4482 4614
     8    9   10   11   12
    4738 4686 4483 4427 4247
    
  • Sumă pe rânduri

    AK   AL   AR   AZ   CA   CO   CT
    136  812  463  862 7906  695  634
    DC   DE   FL   GA   HI   IA   ID
    278  151 2519 1512  254  472  237
    ...
    
Programare paralelă în R

Să exersăm!

Programare paralelă în R

Preparing Video For Download...