Нормальные данные

Планирование экспериментов в Python

James Chapman

Curriculum Manager, DataCamp

Нормальное распределение
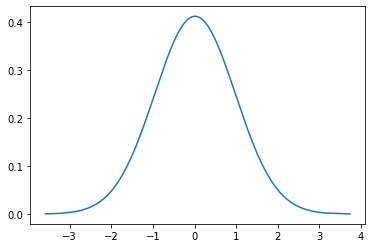
 

  • Характерная форма «колокола»
  • Связь с z-оценками

$$ {z} = \frac{x-\mu}{\sigma}$$

  • Среднее = 0, ст. откл. = 1
    • «На сколько стандартных отклонений точка удалена от среднего?»
    • «Какова вероятность получить такое значение?»


График типичного нормального распределения: синяя кривая в форме колокола на белом фоне.

Планирование экспериментов в Python

Нормальные данные и статистические тесты


  • Требуется для параметрических тестов
  • Непараметрические тесты: не предполагают нормальность данных


График типичного нормального распределения: синяя кривая в форме колокола на белом фоне.

Планирование экспериментов в Python

Нормальное распределение, z-оценка и alpha
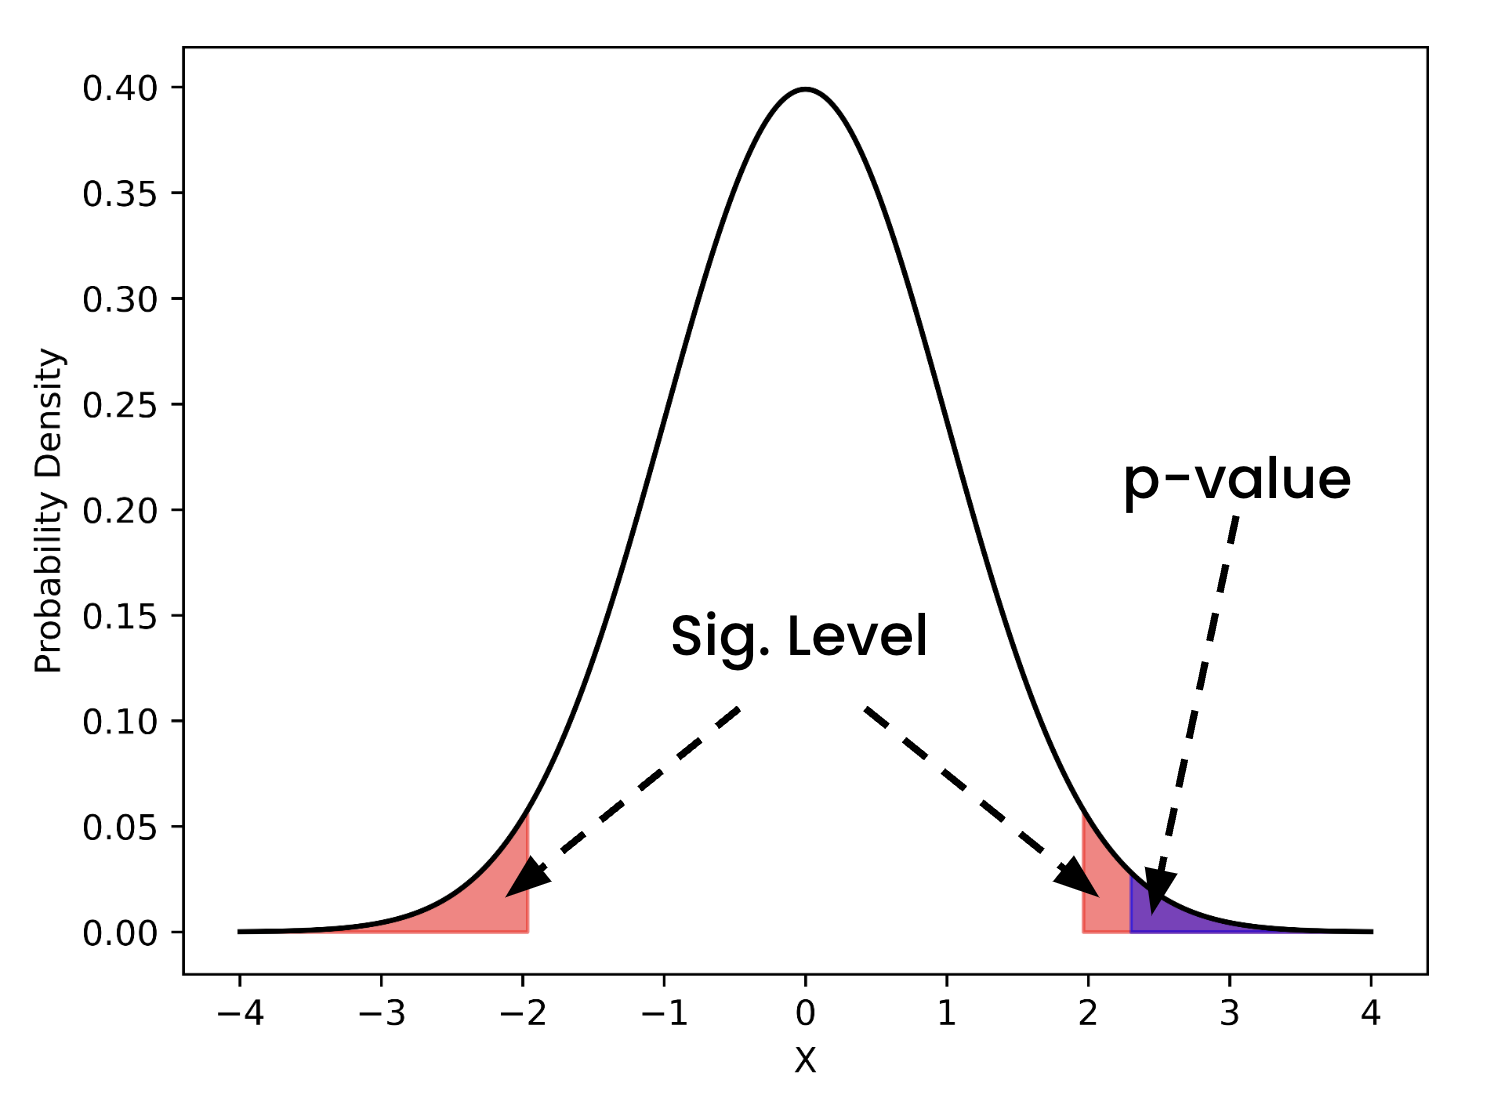
 

  • Связь с уровнем значимости ($\alpha$)
  • Сравнение p-значения с $\alpha$
  • Вероятность ошибки первого рода


Нормальное распределение с двумя небольшими закрашенными чёрным хвостами

Планирование экспериментов в Python

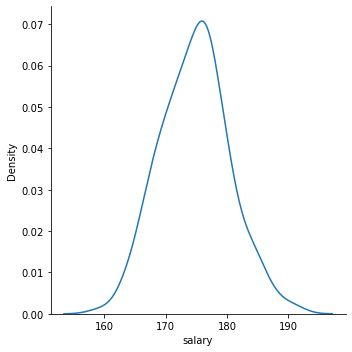
Визуализация нормальных данных


sns.displot(data=salaries,
            x='salary',
            kind="kde")
plt.show()


Распределение в форме колокола — более узкое и высокое, чем стандартное, но сохраняющее типичную форму

Планирование экспериментов в Python

QQ-графики

QQ-график: сравнение данных с заданным распределением

from statsmodels.graphics.gofplots import qqplot
from scipy.stats.distributions import norm
qqplot(salaries['salary'], 
       line='s', 
       dist=norm)
plt.show()
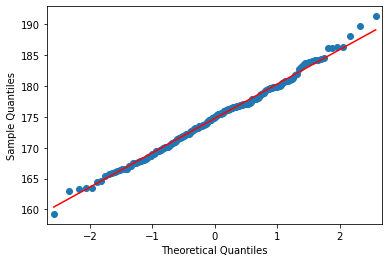
  • Идеал: точки плотно прилегают к линии
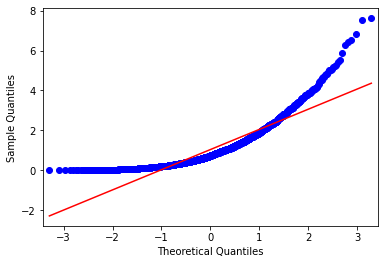
  • Плохо: точки отходят от линии на концах


QQ-график, на котором точки плотно прилегают к диагональной линии под углом 45°

QQ-график, на котором точки в центре прилегают к линии, а на концах отклоняются, образуя изогнутую кривую

Планирование экспериментов в Python

Тесты на нормальность


  • Шапиро–Уилк (подходит для небольших выборок)
  • D'Agostino $K^2$ (использует эксцесс и асимметрию)
  • Андерсона–Дарлинга (возвращает список значений)


$H_0$ = «Данные взяты из нормального распределения»

Планирование экспериментов в Python

Тест Шапиро–Уилка


from scipy.stats import shapiro
alpha = 0.05

stat, p = shapiro(salaries['salary']) print(f"p: {round(p,4)} test stat: {round(stat,4)}")
p: 0.8293 test stat: 0.9956
  • p > alpha
    • Не отвергаем $H_0$ → вероятно, нормальное
Планирование экспериментов в Python

Тест Андерсона–Дарлинга

from scipy.stats import anderson
result = anderson(x=salaries['salary'], dist="norm")
print(round(result.statistic,4))
print(result.significance_level)
print(result.critical_values)
0.2748
[15.  10.   5.   2.5  1. ]
[0.572 0.651 0.781 0.911 1.084]
  • 0.2748 < [0.572 0.651 0.781 0.911 1.084]
    • Не отвергаем $H_0$ → вероятно, нормальное
Планирование экспериментов в Python

Давайте потренируемся!

Планирование экспериментов в Python

Preparing Video For Download...