Настройка экспериментальных данных

Планирование экспериментов в Python

James Chapman

Curriculum Manager, DataCamp

Проблема рандомизации
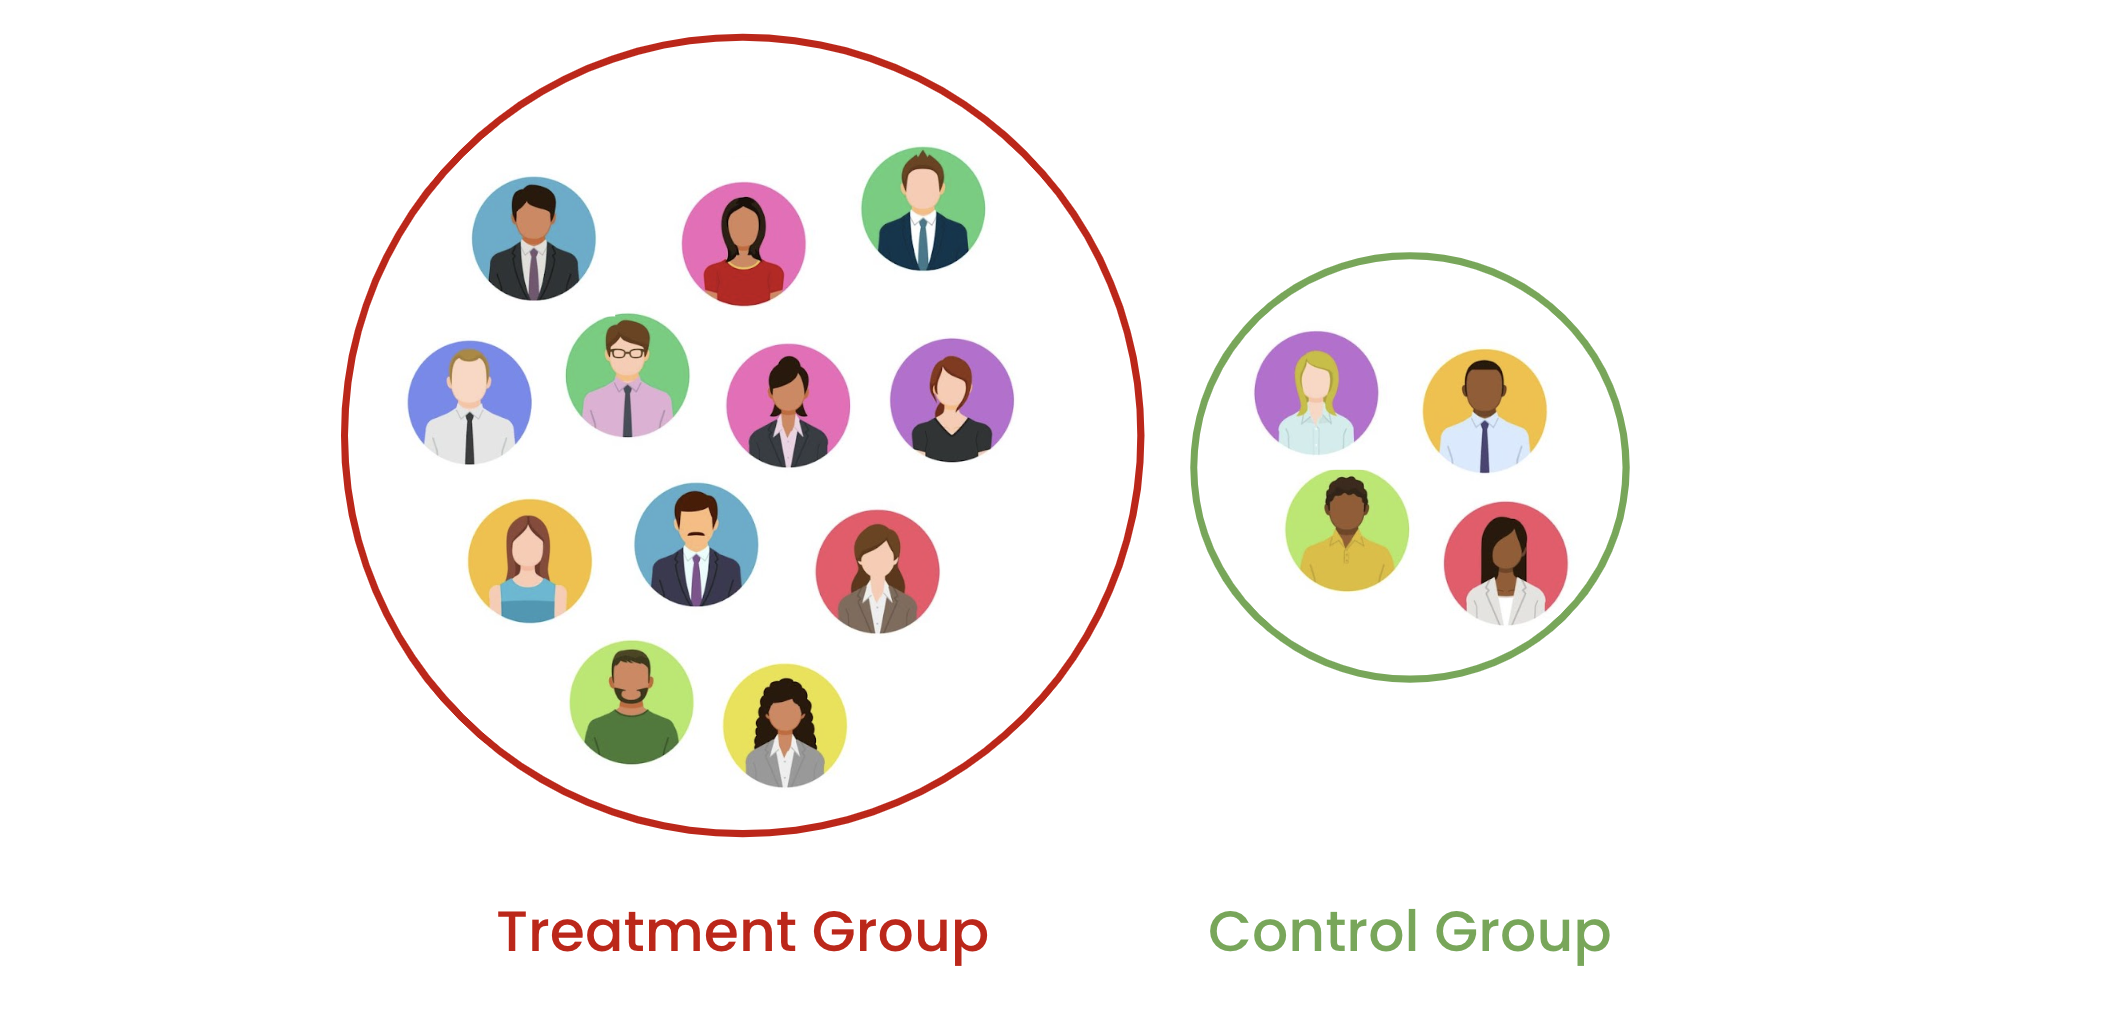
1) Проблема неравенства: разное число участников в группах

Две группы с разным числом участников.

Планирование экспериментов в Python

Проблема рандомизации

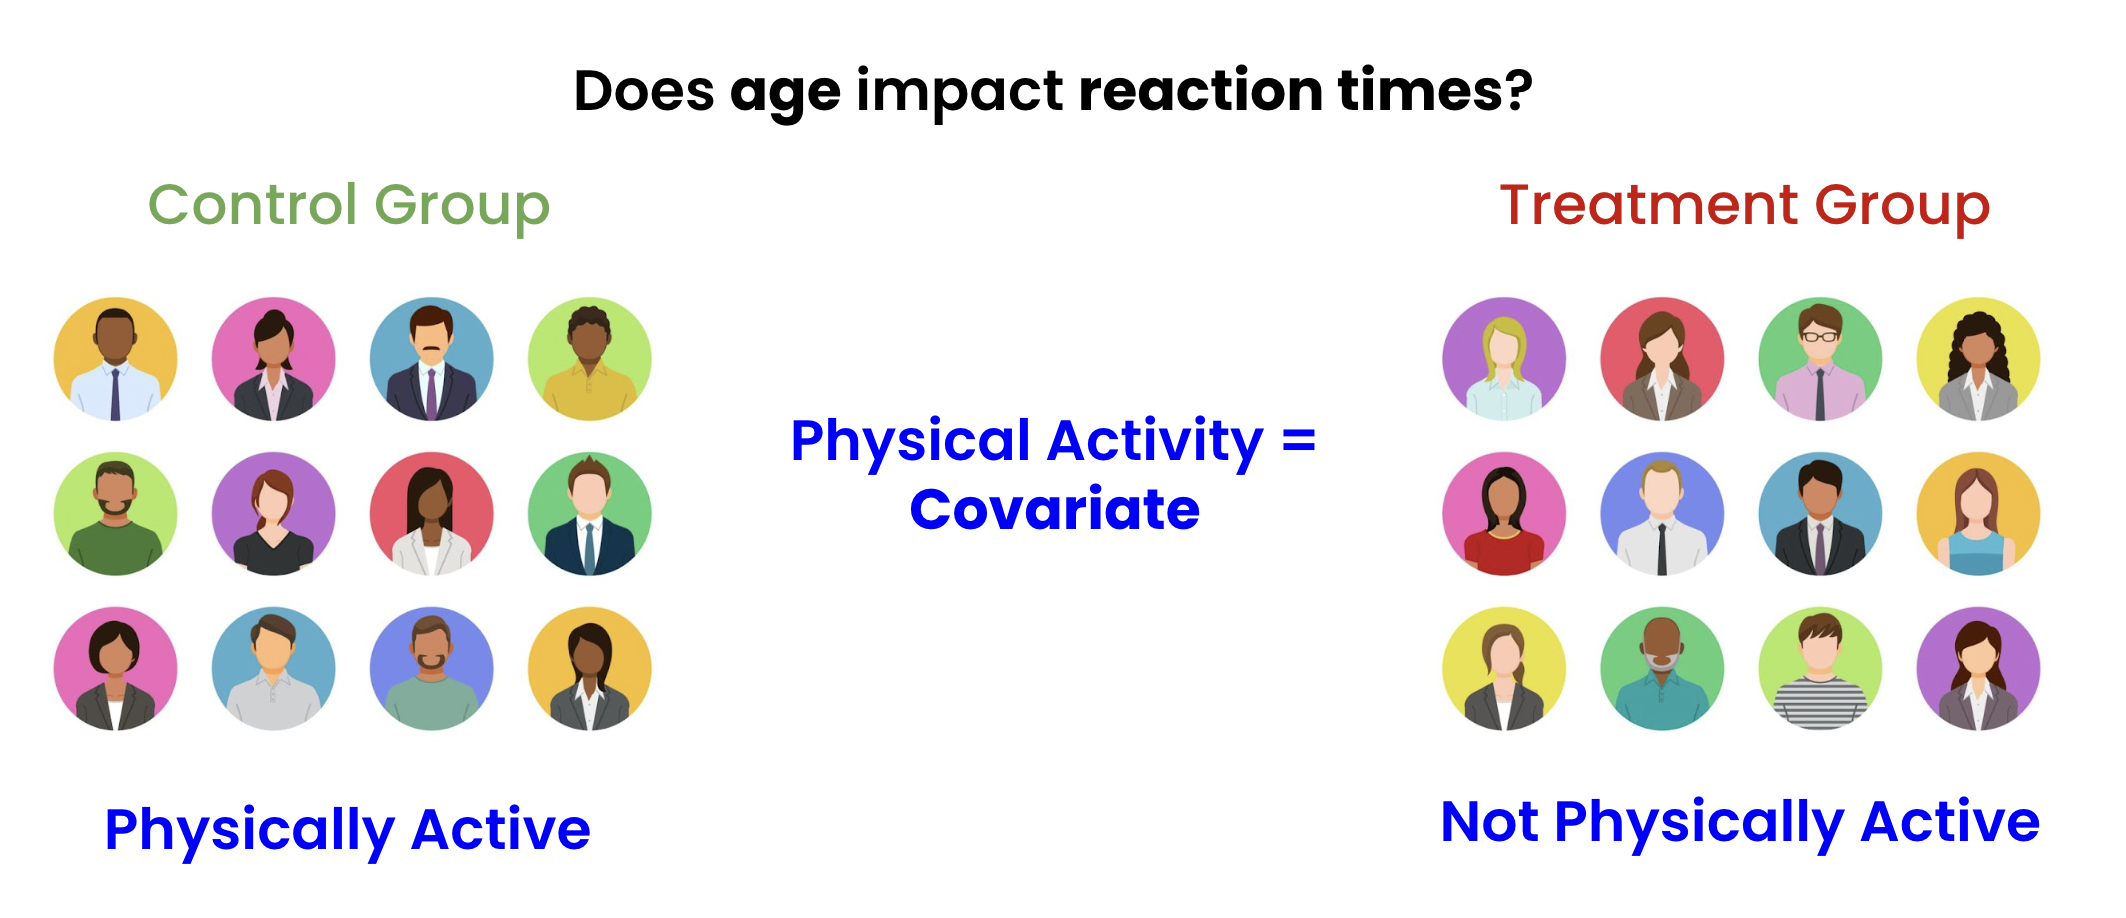
2) Проблема ковариат: высокая вариабельность ковариат → дисбаланс групп при рандомизации

Контрольная и экспериментальная группы для измерения влияния возраста на время реакции. Распределение физической подготовки в группах неравномерно, что может влиять на показатель времени реакции, хотя и не является основным предметом эксперимента.

Результат: сложнее измерить эффект воздействия!

Планирование экспериментов в Python

Блочная рандомизация


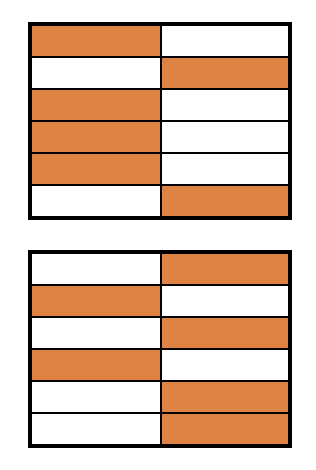
  • Сначала разбейте на блоки размера $n$, затем случайно распределите
    • Решает проблему неравенства

Пример блочной рандомизации: две сетки из оранжевых и белых квадратов

  • 24 участника разбиты на две группы и рандомизированы
Планирование экспериментов в Python

Наш набор данных

  • Набор данных e-commerce (ecom) (1000 участников)
    • Средний размер корзины
    • Среднее время на сайте
    • Активный пользователь (в среднем 40+ минут на сайте в день)
   basket_size  web_time  power_user
0          227         7           0
1          123         5           0
2           98        16           0
3          211        45           1
4          133        17           0
Планирование экспериментов в Python

Блочная рандомизация в Python

group1 = ecom.sample(frac=0.5, random_state=42, replace=False)
group1['Block'] = 1
group2 = ecom.drop(group1.index)
group2['Block'] = 2
print(len(group1), len(group2))
500,500
Планирование экспериментов в Python

Визуализация разбивок


import seaborn as sns
import matplotlib.pyplot as plt
sns.displot(data=ecom, 
            x='basket_size', 
            hue='power_user', 
            fill=True, 
            kind='kde')    
plt.show()

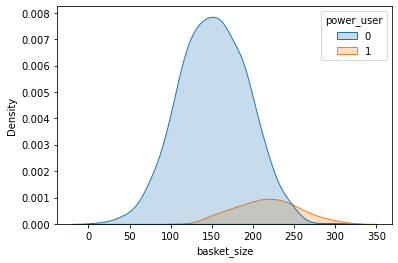
Смешивающая переменная = переменная, которая может вызывать эффект вместо воздействия


График распределения seaborn с двумя слегка прозрачными нормальными распределениями: большим синим и меньшим оранжевым, немного перекрывающимися, с оранжевым правее

Планирование экспериментов в Python

Стратифицированная рандомизация


  • Сначала разбивка по ковариате(-ам)
    • Затем рандомизация
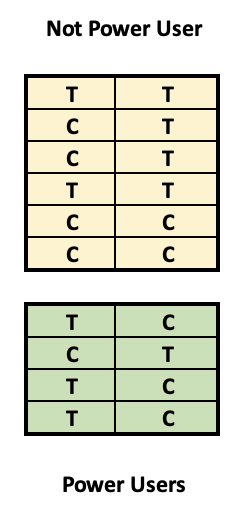
  • Зелёный = все активные пользователи (Жёлтый = неактивные)
    • Затем разбивка на группы «Воздействие/Контроль»
  • Решает проблему ковариат и смешивания
  • Применимо для нескольких ковариат – но усложняется!

Два блока данных – зелёный и жёлтый. В каждой ячейке стоит буква T или C; жёлтый блок крупнее

Планирование экспериментов в Python

Первая страта

  • Выделите активных пользователей
  • Разделите на группы «Воздействие/Контроль»
strata_1 = ecom[ecom['power_user'] == 1]
strata_1['Block'] = 1

strata_1_g1 = strata_1.sample(frac=0.5, replace=False) strata_1_g1['T_C'] = 'T'
strata_1_g2 = strata_1.drop(strata_1_g1.index) strata_1_g2['T_C'] = 'C'
Планирование экспериментов в Python

Вторая страта

  • Выделите неактивных пользователей
  • Разделите на группы «Воздействие/Контроль»
strata_2 = ecom.drop(strata_1.index)
strata_2['Block'] = 2

strata_2_g1 = strata_2.sample(frac=0.5, replace=False) strata_2_g1['T_C'] = 'T' strata_2_g2 = strata_2.drop(strata_2_g1.index) strata_2_g2['T_C'] = 'C'
Планирование экспериментов в Python

Проверка стратификации

  • Объедините блоки и группы
  • Используйте groupby для проверки распределения
ecom_stratified = pd.concat([strata_1_g1, strata_1_g2, strata_2_g1, strata_2_g2])

ecom_stratified.groupby(['Block','T_C', 'power_user']).size()
Block  T_C  power_user
1      C    1              50
       T    1              50
2      C    0             450
       T    0             450
Планирование экспериментов в Python

Давайте потренируемся!

Планирование экспериментов в Python

Preparing Video For Download...