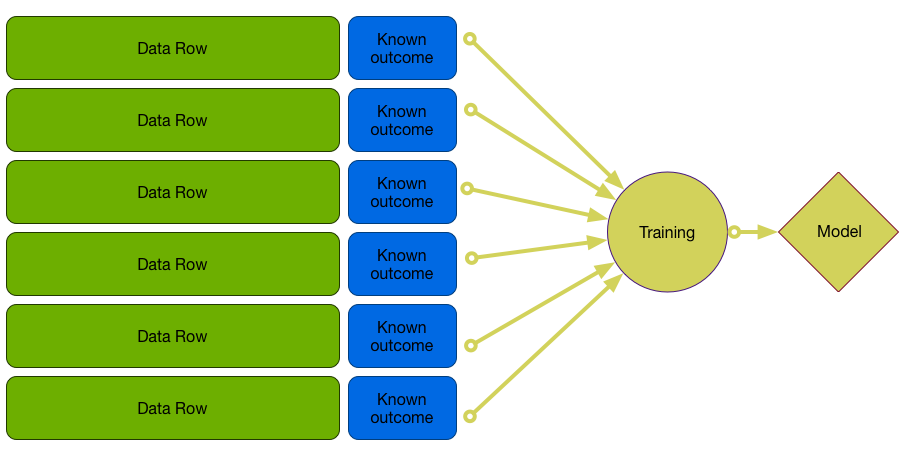
Правильное обучение модели
Обучение с учителем в R: регрессия

Nina Zumel and John Mount
Win-Vector, LLC
Модель может работать значительно лучше на обучающих данных, чем на новых.
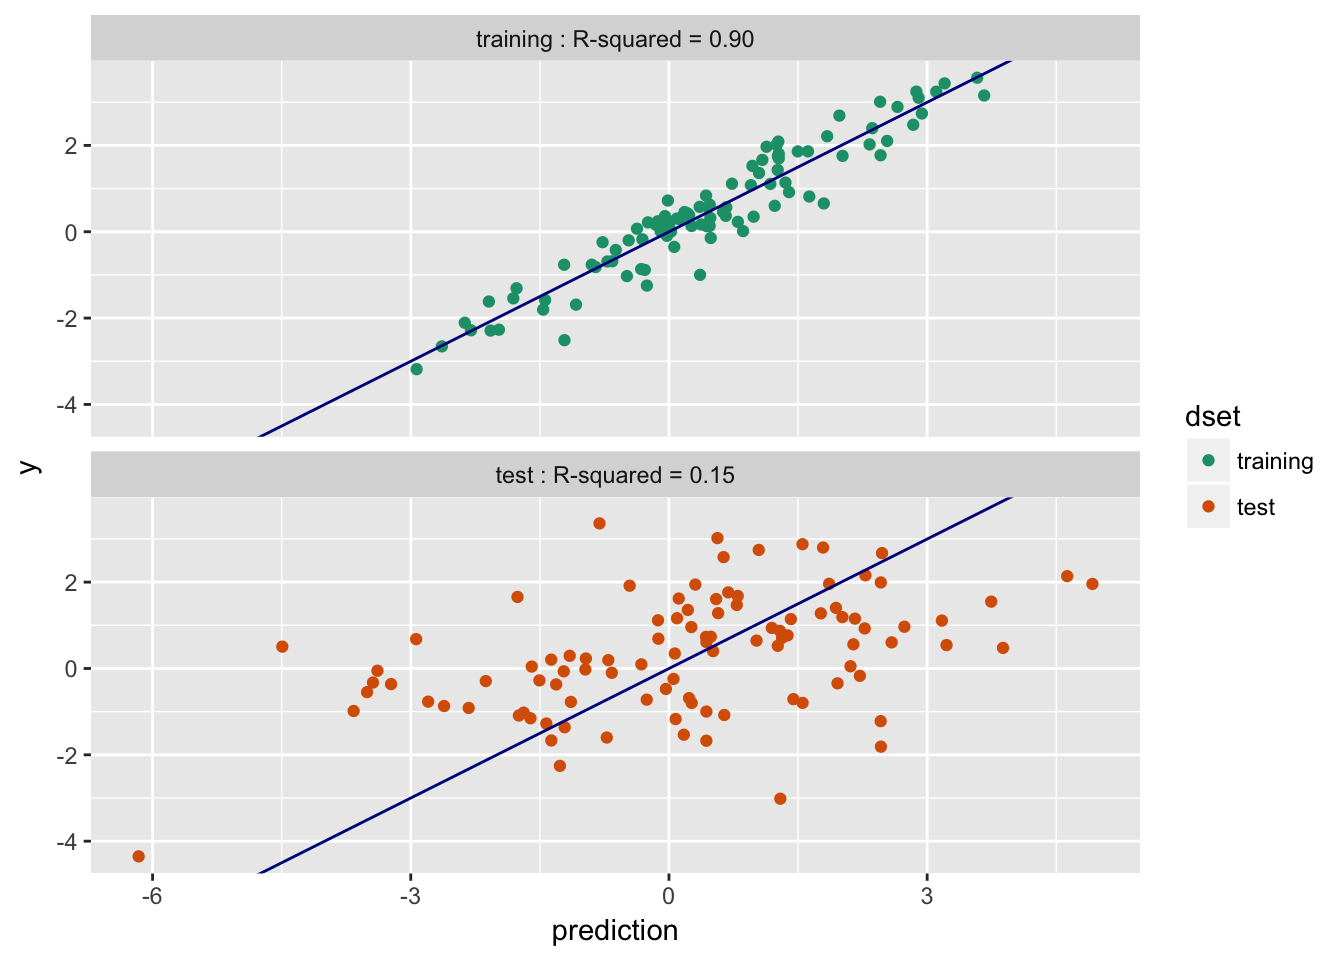
- Training $R^2$: 0.9; Test $R^2$: 0.15 -- Переобучение
Разбивка на обучающую и тестовую выборки
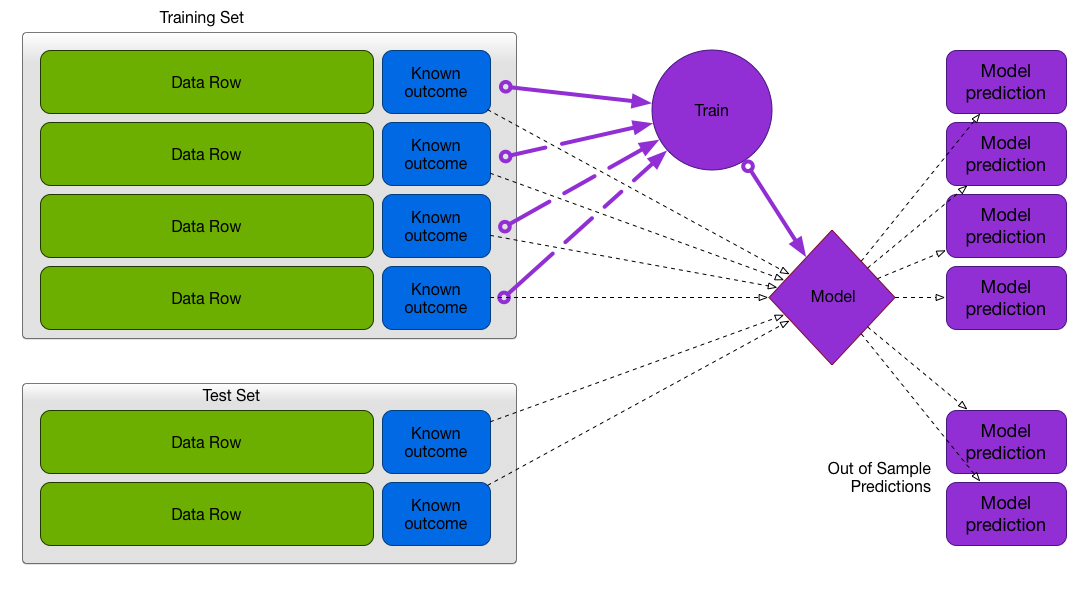
Рекомендуется при достаточном объёме данных
Пример: модель женской безработицы
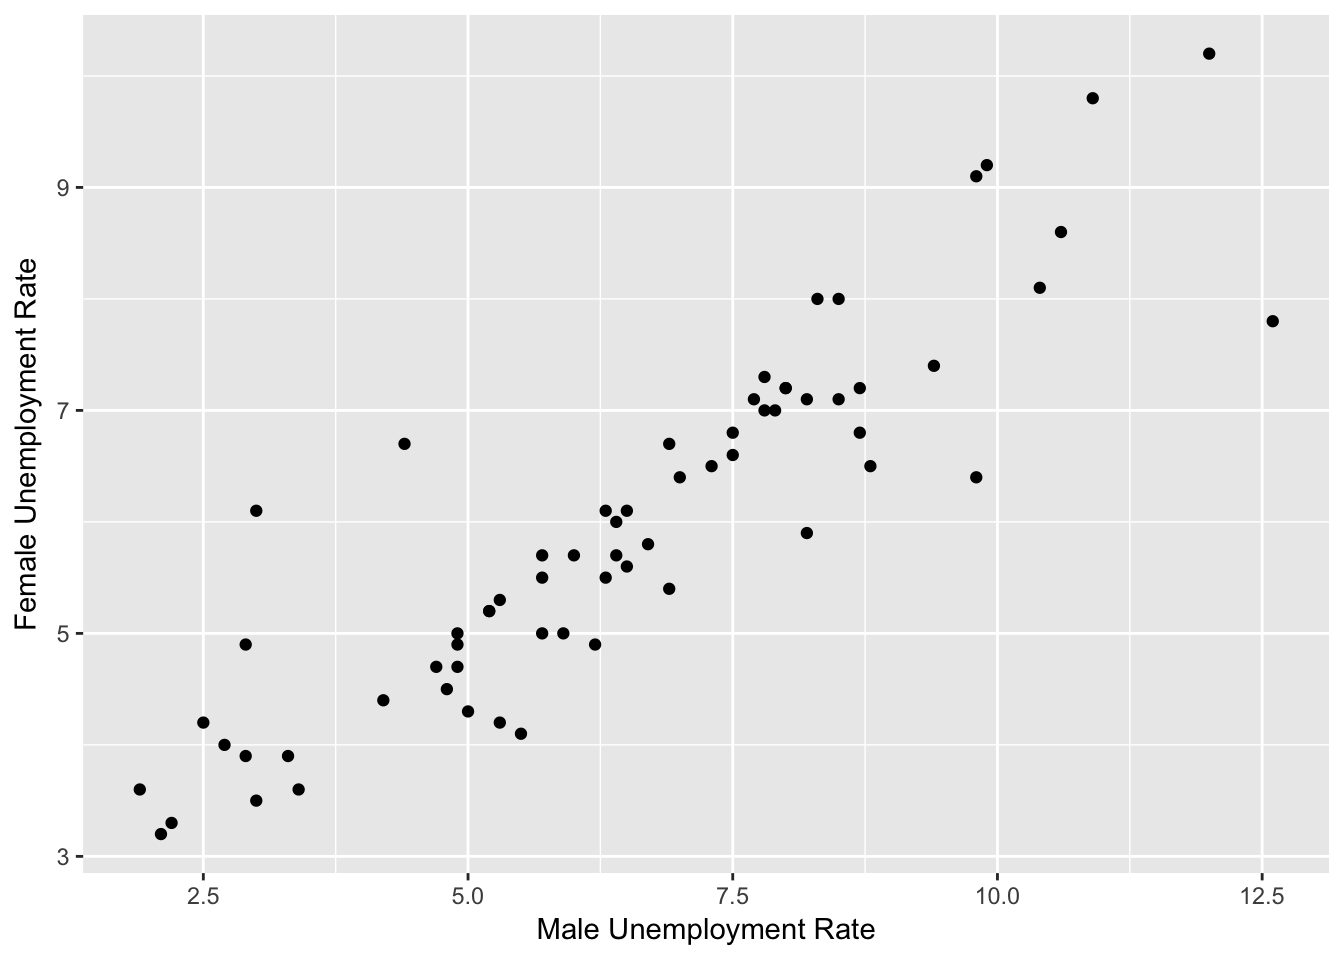
- Обучение: 66 строк, тест: 30 строк
Качество модели: обучающая vs. тестовая выборка
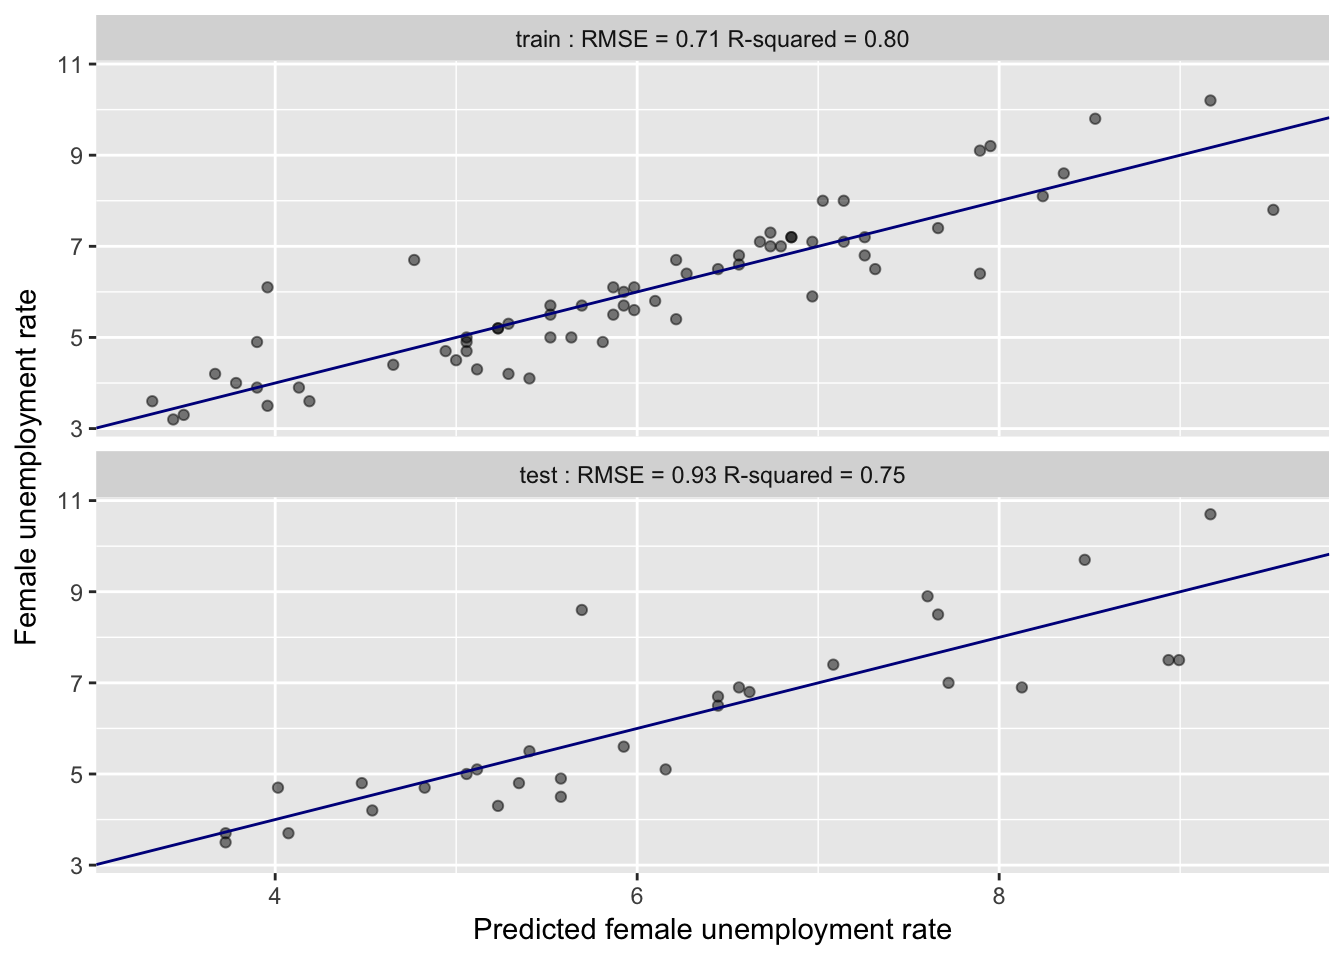
- Обучающая выборка: RMSE 0.71, $R^2$ 0.8
- Тестовая выборка: RMSE 0.93, $R^2$ 0.75
Кросс-валидация
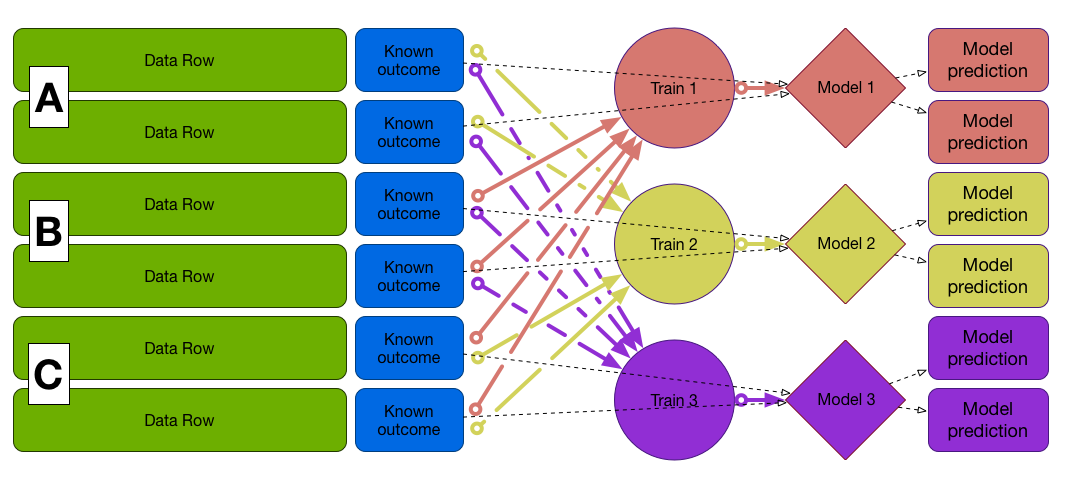
Предпочтителен, когда данных недостаточно для выделения тестовой выборки
Кросс-валидация
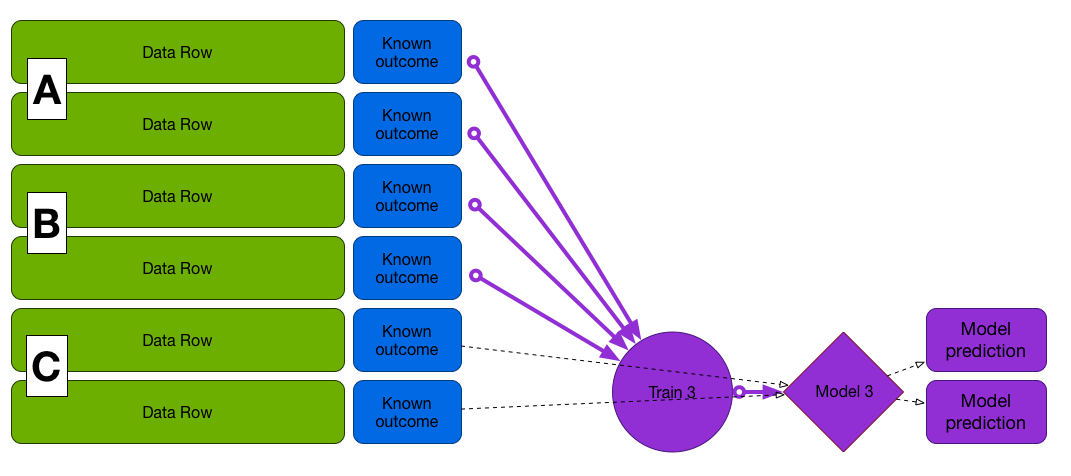
Кросс-валидация
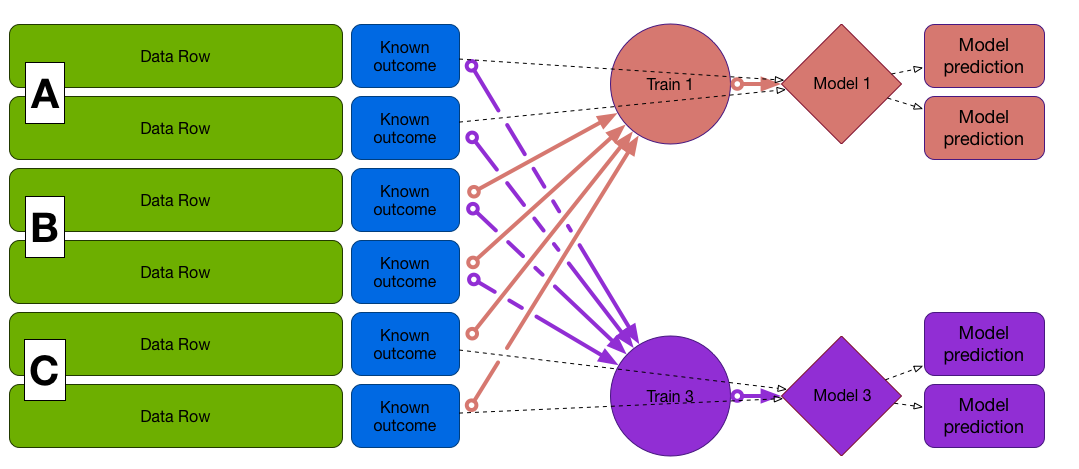
Кросс-валидация
Итоговая модель