Повышение доли успешных обнаружений с помощью ресэмплинга

Обнаружение мошенничества на Python

Charlotte Werger

Data Scientist

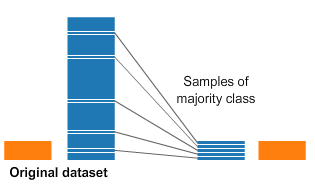
Андерсэмплинг
Обнаружение мошенничества на Python

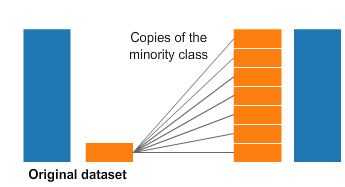
Оверсэмплинг

Обнаружение мошенничества на Python

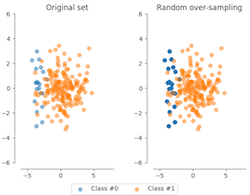
Оверсэмплинг на Python

from imblearn.over_sampling import RandomOverSampler

method = RandomOverSampler() X_resampled, y_resampled = method.fit_resample(X, y)
compare_plots(X_resampled, y_resampled, X, y)
Обнаружение мошенничества на Python

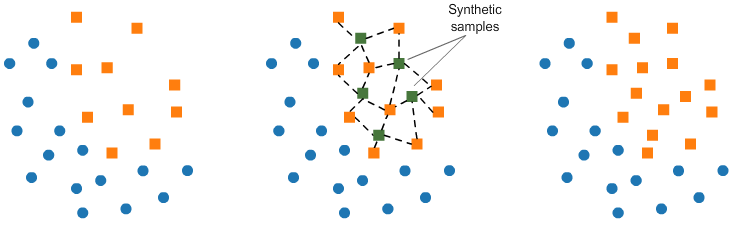
Метод синтетической избыточной выборки меньшинства (SMOTE)
1 https://www.kaggle.com/rafjaa/resampling-strategies-for-imbalanced-datasets
Обнаружение мошенничества на Python

Какой метод ресэмплинга выбрать?

  • Random Under Sampling (RUS): отбрасывает данные, вычислительно эффективен
  • Random Over Sampling (ROS): прост в применении, но обучение ведётся на множестве дубликатов
  • Synthetic Minority Oversampling Technique (SMOTE): формирует более реалистичный набор данных, однако обучение выполняется на «синтетических» примерах
Обнаружение мошенничества на Python

Когда применять методы ресэмплинга

from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression

# Define resampling method and split into train and test method = SMOTE() X_train, X_test, y_train, y_test = train_test_split(X, y, train_size=0.8, random_state=0)
# Apply resampling to the training data only X_resampled, y_resampled = method.fit_resample(X_train, y_train)
# Continue fitting the model and obtain predictions model = LogisticRegression() model.fit(X_resampled, y_resampled)
# Get your performance metrics predicted = model.predict(X_test) print (classification_report(y_test, predicted))
Обнаружение мошенничества на Python

Давайте потренируемся!

Обнаружение мошенничества на Python

Preparing Video For Download...