Другие методы кластеризации для обнаружения мошенничества

Обнаружение мошенничества на Python

Charlotte Werger

Data Scientist

Существует множество методов кластеризации
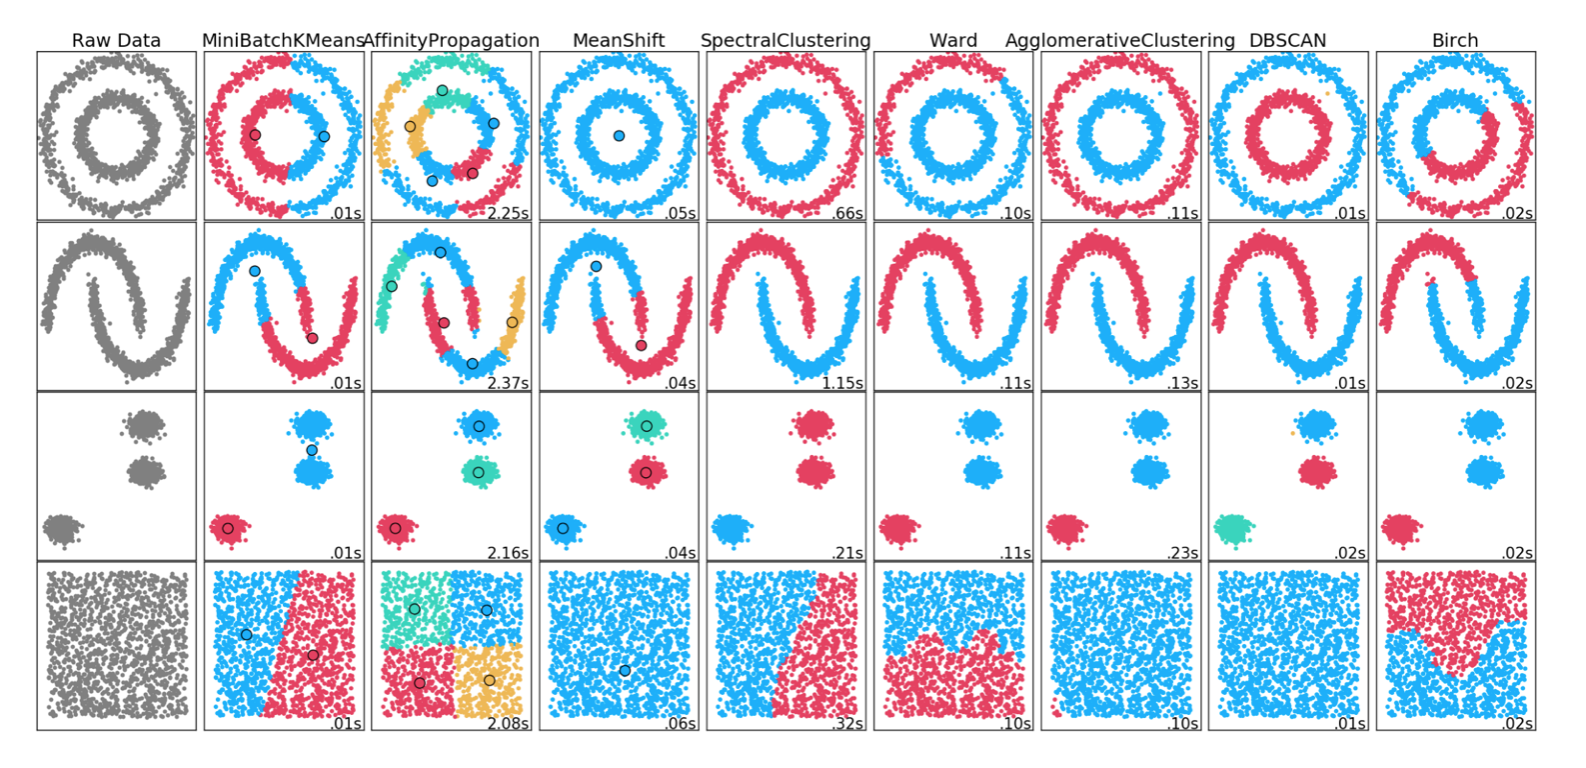
Обнаружение мошенничества на Python

Разные способы выявления мошенничества: наименьшие кластеры
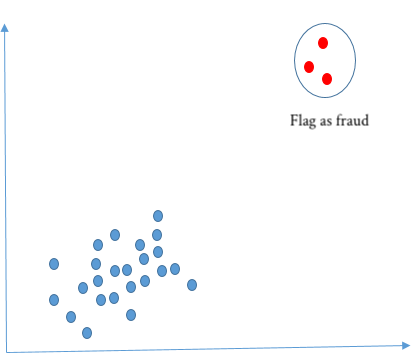
Обнаружение мошенничества на Python

На практике это выглядит примерно так
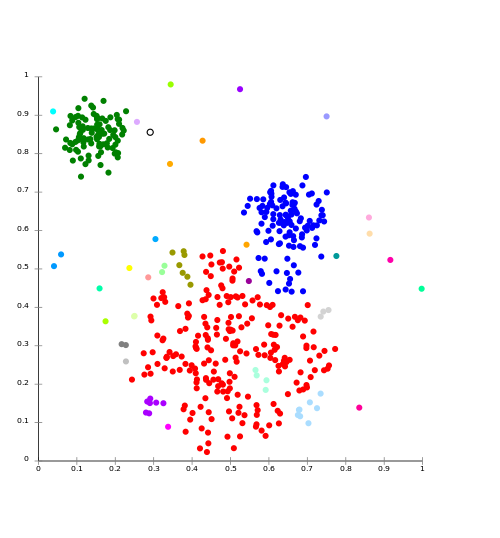
Обнаружение мошенничества на Python

DBSCAN против K-means

  • Не нужно задавать количество кластеров заранее
  • Настраивается максимальное расстояние между точками внутри кластера
  • Задаётся минимальное число объектов в кластере
  • Лучше справляется с данными нестандартной формы
  • Но.. более высокие вычислительные затраты
Обнаружение мошенничества на Python

Реализация DBSCAN

from sklearn.cluster import DBSCAN
db = DBSCAN(eps=0.5, min_samples=10, n_jobs=-1).fit(X_scaled)

# Get the cluster labels (aka numbers) pred_labels = db.labels_
# Count the total number of clusters n_clusters_ = len(set(pred_labels)) - (1 if -1 in pred_labels else 0) # Print model results print('Estimated number of clusters: %d' % n_clusters_)
Estimated number of clusters: 31
Обнаружение мошенничества на Python

Проверка размера кластеров

# Print model results
print("Silhouette Coefficient: %0.3f" % metrics.silhouette_score(X_scaled, pred_labels))
Silhouette Coefficient: 0.359
# Get sample counts in each cluster 
counts = np.bincount(pred_labels[pred_labels>=0])
print (counts)
[ 763  496  840  355 1086  676   63  306  560  134   28   18  262  128  332  22  
   22   13   31   38   36   28   14   12   30   10   11   10   21   10    5]
Обнаружение мошенничества на Python

Давайте потренируемся!

Обнаружение мошенничества на Python

Preparing Video For Download...