Методы кластеризации для обнаружения мошенничества

Обнаружение мошенничества на Python

Charlotte Werger

Data Scientist

Кластеризация: поиск закономерностей в данных
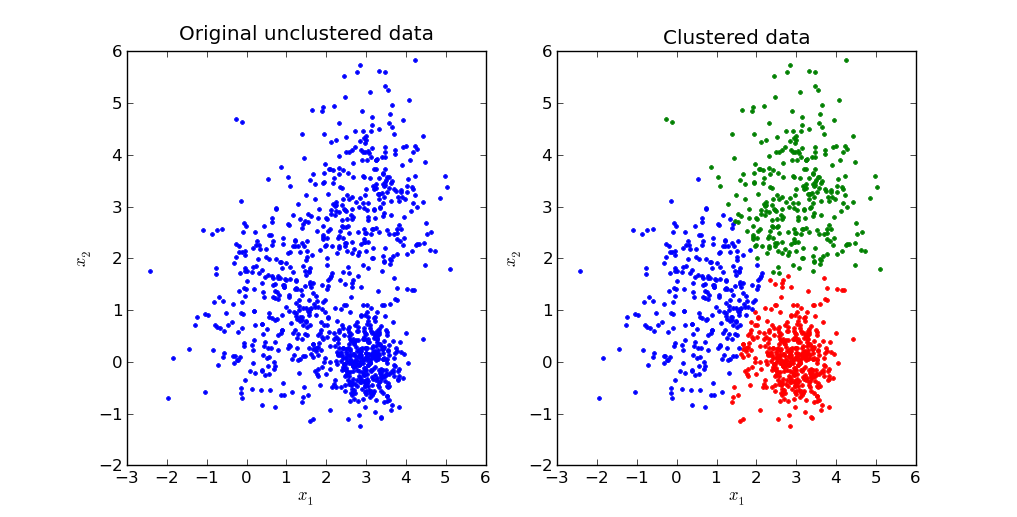
Обнаружение мошенничества на Python

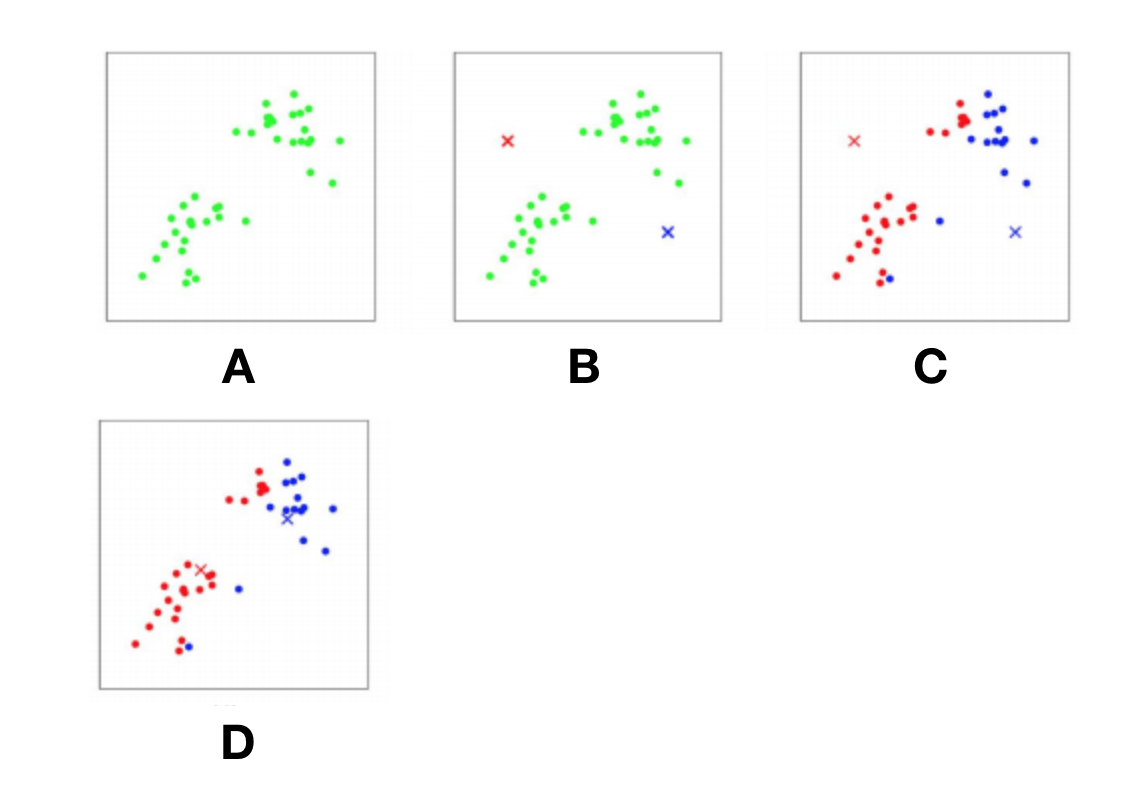
K-means: кластеризация по расстоянию до центроидов
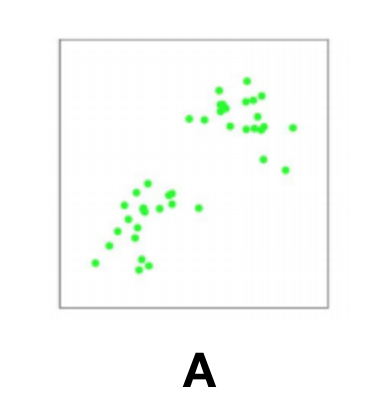
Обнаружение мошенничества на Python

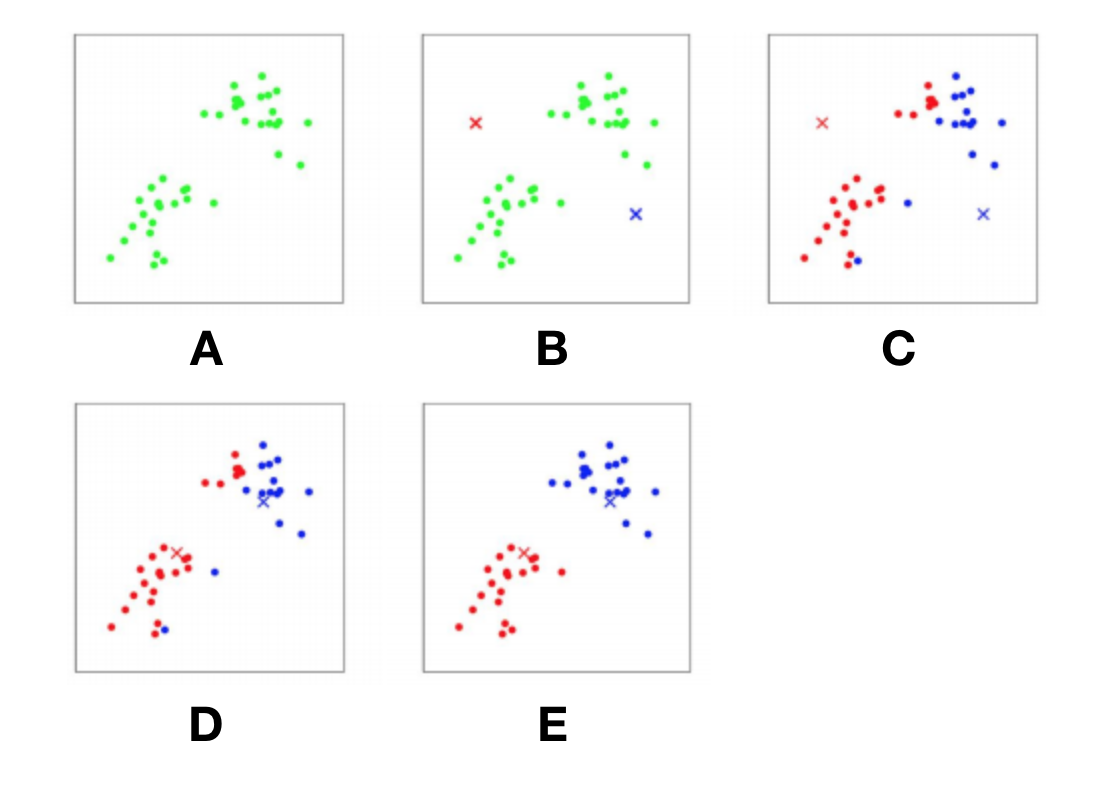
K-means: кластеризация по расстоянию до центроидов
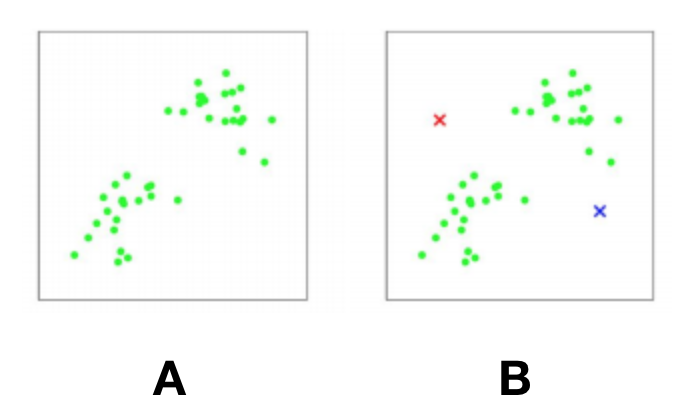
Обнаружение мошенничества на Python

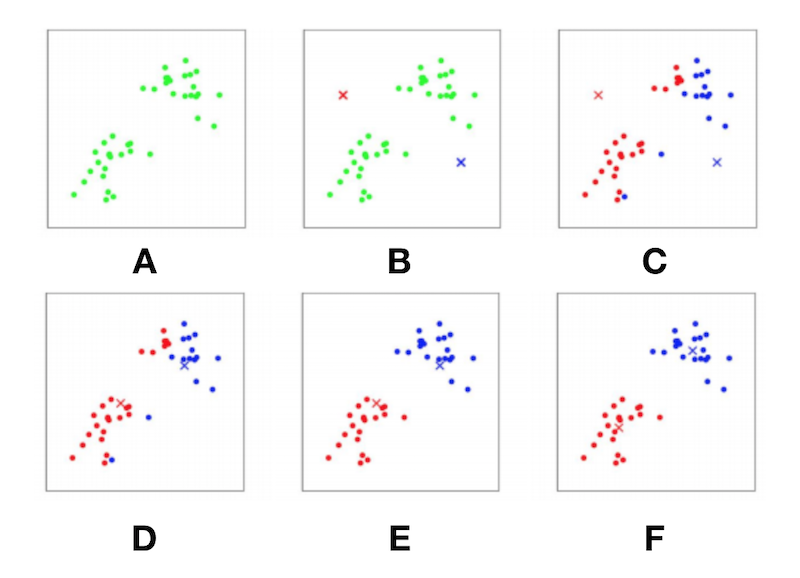
K-means: кластеризация по расстоянию до центроидов
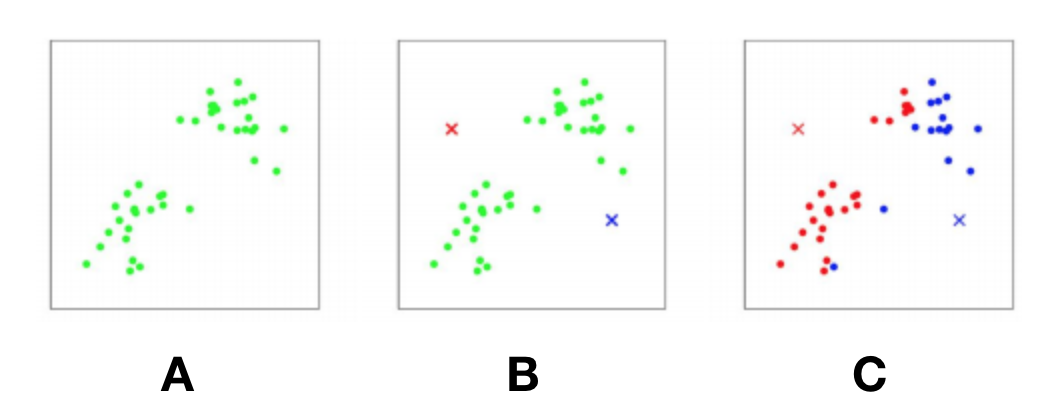
Обнаружение мошенничества на Python

Обнаружение мошенничества на Python

Обнаружение мошенничества на Python

Обнаружение мошенничества на Python

K-means на Python

# Import the packages
from sklearn.preprocessing import MinMaxScaler
from sklearn.cluster import KMeans

# Transform and scale your data X = np.array(df).astype(np.float)
scaler = MinMaxScaler() X_scaled = scaler.fit_transform(X)
# Define the k-means model and fit to the data kmeans = KMeans(n_clusters=6, random_state=42).fit(X_scaled)
Обнаружение мошенничества на Python

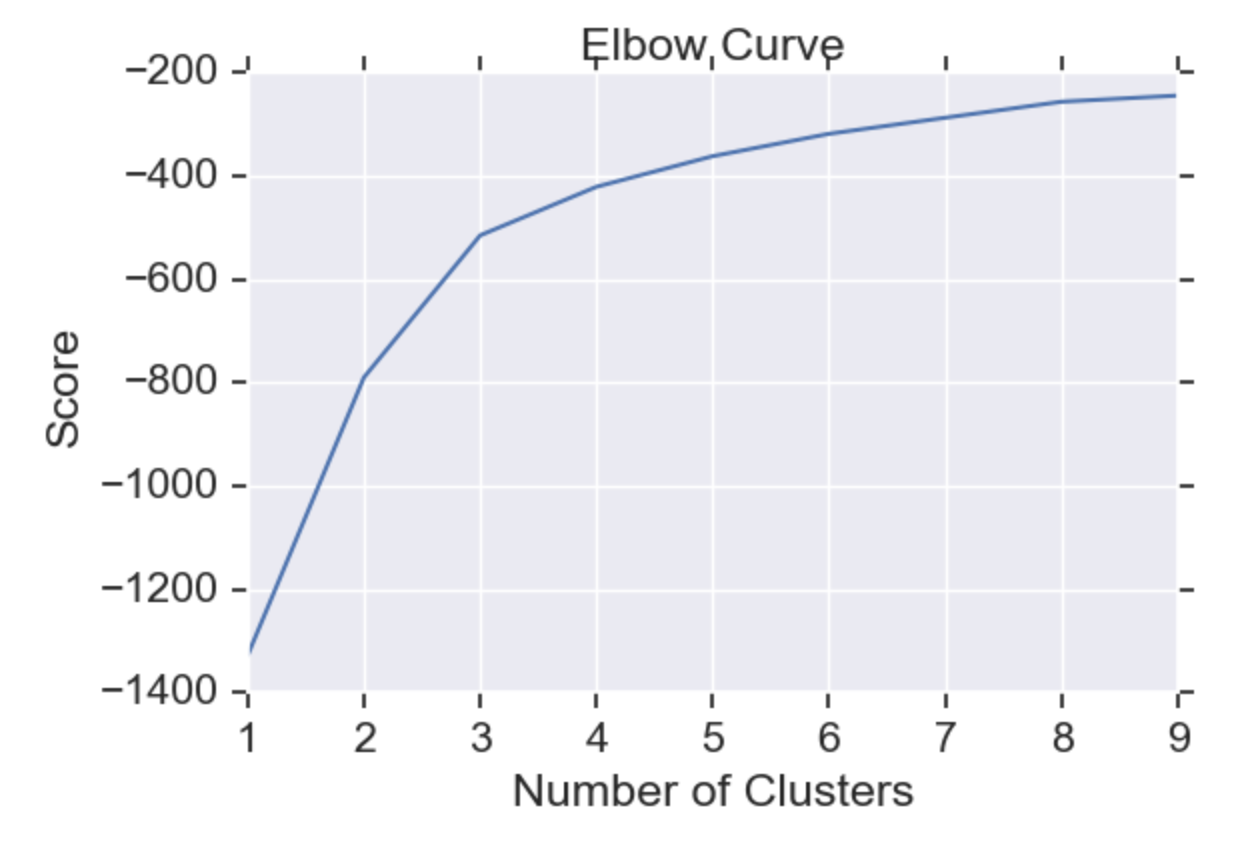
Оптимальное число кластеров

Выбор числа кластеров:

  • Метод силуэта
  • Метод локтя
clust = range(1, 10) 
kmeans = [KMeans(n_clusters=i) for i in clust]

score = [kmeans[i].fit(X_scaled).score(X_scaled) for i in range(len(kmeans))]
plt.plot(clust,score) plt.xlabel('Number of Clusters') plt.ylabel('Score') plt.title('Elbow Curve') plt.show()
Обнаружение мошенничества на Python

Кривая локтя

Обнаружение мошенничества на Python

Давайте потренируемся!

Обнаружение мошенничества на Python

Preparing Video For Download...