Тематическое моделирование для выявления мошенничества

Обнаружение мошенничества на Python

Charlotte Werger

Data Scientist

Тематическое моделирование: выявление скрытых закономерностей в тексте

  1. Обнаружение тем в текстовых данных
  2. «О чём этот текст»
  3. Концептуально схоже с кластеризацией данных
  4. Сравнение тем мошеннических и обычных случаев — как признак или флаг
  5. Или... есть ли в данных тема, которая указывает на мошенничество?
Обнаружение мошенничества на Python

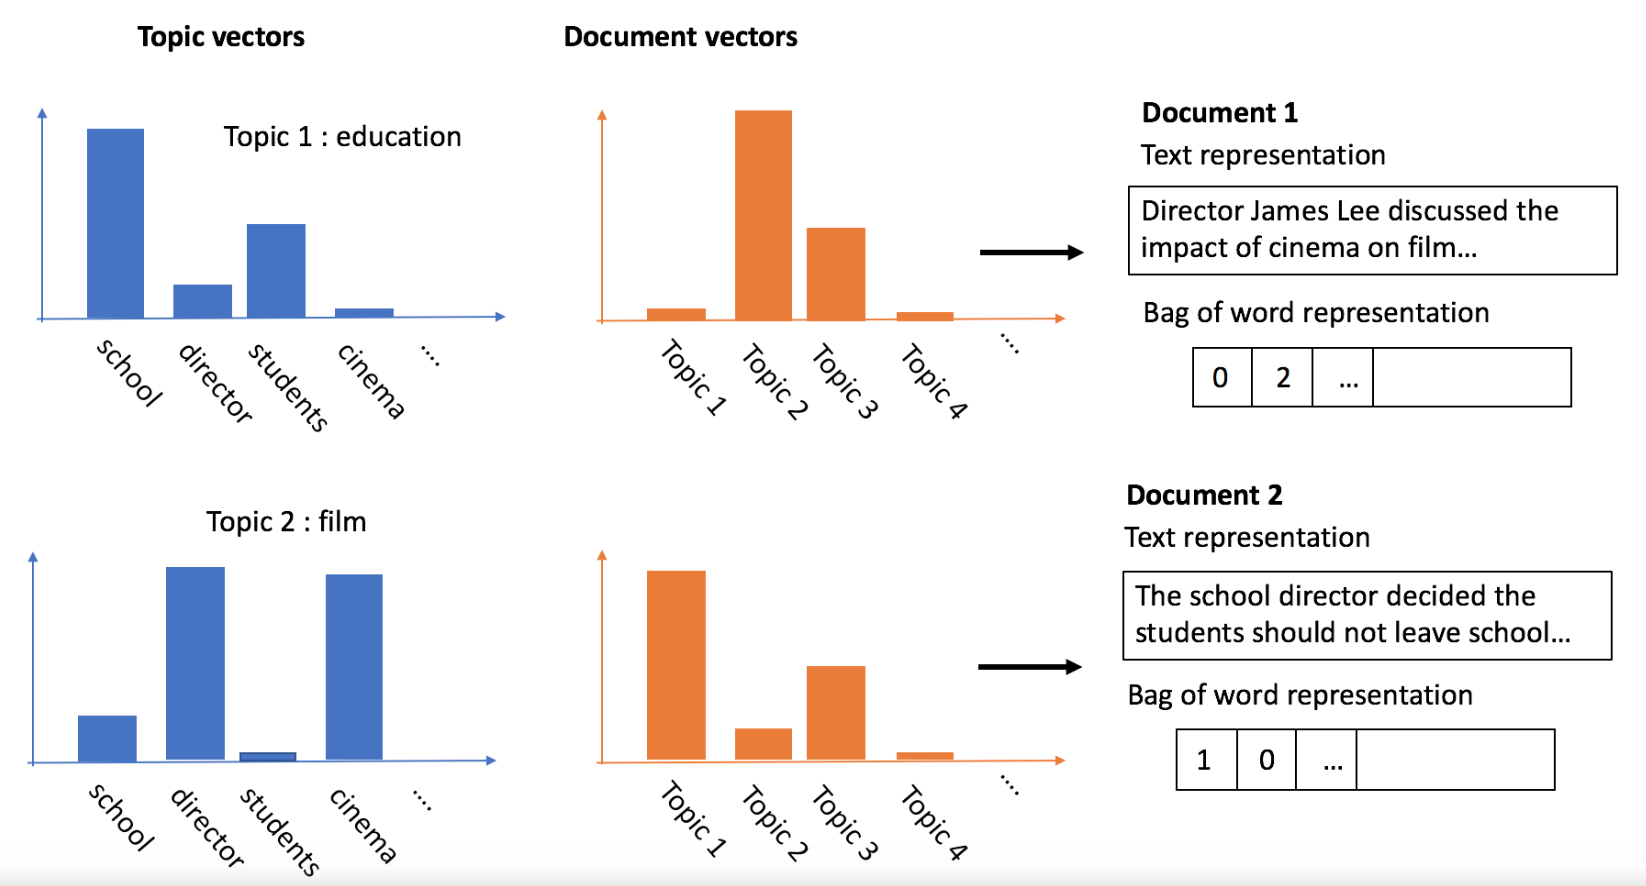
Латентное размещение Дирихле (LDA)

LDA даёт:

  1. Модель «темы на текстовый элемент» (вероятности)
  2. Модель «слова на тему»

Создание собственной тематической модели:

  1. Очистите данные
  2. Создайте мешок слов: словарь и корпус
  3. Передайте словарь и корпус в модель LDA
Обнаружение мошенничества на Python

Латентное размещение Дирихле (LDA)

Обнаружение мошенничества на Python

Мешок слов: словарь и корпус

from gensim import corpora
# Create dictionary number of times a word appears
dictionary = corpora.Dictionary(cleaned_emails)
# Filter out (non)frequent words 
dictionary.filter_extremes(no_below=5, keep_n=50000)
# Create corpus
corpus = [dictionary.doc2bow(text) for text in cleaned_emails]
Обнаружение мошенничества на Python

Латентное размещение Дирихле (LDA) с gensim

import gensim
# Define the LDA model
ldamodel = gensim.models.ldamodel.LdaModel(corpus, num_topics = 3, 
id2word=dictionary, passes=15)
# Print the three topics from the model with top words
topics = ldamodel.print_topics(num_words=4)
for topic in topics:
    print(topic)
(0, 0.029*"email" + 0.016*"send" + 0.016*"results" + 0.016*"invoice")
(1, 0.026*"price" + 0.026*"work" + 0.026*"management" + 0.026*"sell")
(2, 0.029*"distribute" + 0.029*"contact" + 0.016*"supply" + 0.016*"fast")
Обнаружение мошенничества на Python

Давайте потренируемся!

Обнаружение мошенничества на Python

Preparing Video For Download...