Стандартизация признаков

Прогнозирование CTR с помощью машинного обучения на Python

Kevin Huo

Instructor

Зачем нужна стандартизация

  • Стандартизация: приведение данных в соответствие с требованиями моделей
  • Некоторые признаки могут иметь слишком высокую дисперсию и непропорционально влиять на модель
  • Пример: отдельные счётчики имеют слишком широкий диапазон значений из-за одного спам-пользователя
  • Не применяется к категориальным переменным: site_id, app_id, device_id и т. д.
Прогнозирование CTR с помощью машинного обучения на Python

Логарифмическая нормализация

df.var()
click                   1.294270e-01
hour                    1.123316e-01
df.var().median()
0.7108583771671939
print(df['click'].var())
df['device_id_count'] = df[
  'device_id_count'].apply(
  lambda x: np.log(x))
print(df['click'].var())
249362570.10134825
15.628476003312514
Прогнозирование CTR с помощью машинного обучения на Python

Масштабирование данных

  • Стандартное масштабирование приводит все признаки к среднему 0 и стандартному отклонению 1
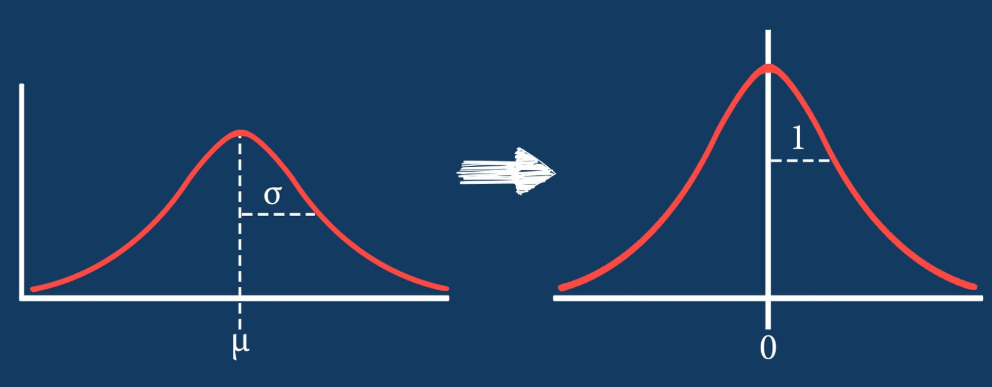
Пример стандартного масштабирования

  • Как правило, рекомендуется применять при обучении моделей машинного обучения
Прогнозирование CTR с помощью машинного обучения на Python

Стандартное масштабирование данных

  • Масштабирование выполняется с помощью StandardScaler() следующим образом:
scaler = StandardScaler()
X[numeric_cols] = scaler.fit_transform(X[numeric_cols])
dtype: float64
1    10.5 -> 0.85
2    32.3 -> 1.54
Прогнозирование CTR с помощью машинного обучения на Python

Давайте потренируемся!

Прогнозирование CTR с помощью машинного обучения на Python

Preparing Video For Download...