Remporter une compétition Kaggle en Python
Yauhen Babakhin
Kaggle Grandmaster

Fuite dans les caractéristiques – utilisation de données non disponibles en situation réelle
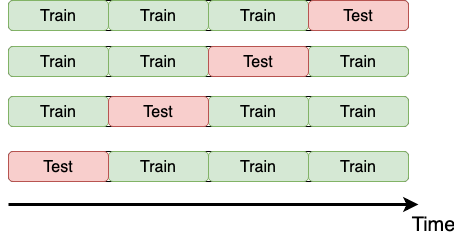
Fuite dans la stratégie de validation – stratégie différente de la réalité


# Importer TimeSeriesSplit
from sklearn.model_selection import TimeSeriesSplit
# Créer un objet TimeSeriesSplit
time_kfold = TimeSeriesSplit(n_splits=5)
# Trier train par date
train = train.sort_values('date')
# Parcourir chaque division de validation croisée
for train_index, test_index in time_kfold.split(train):
cv_train, cv_test = train.iloc[train_index], train.iloc[test_index]
# Liste pour les résultats fold_metrics = []for train_index, test_index in CV_STRATEGY.split(train): cv_train, cv_test = train.iloc[train_index], train.iloc[test_index]# Entraîner un modèle model.fit(cv_train)# Faire des prédictions predictions = model.predict(cv_test)# Calculer la mesure metric = evaluate(cv_test, predictions) fold_metrics.append(metric)
| Numéro de pli | MSE Modèle A | MSE Modèle B |
|---|---|---|
| Pli 1 | 2.95 | 2.97 |
| Pli 2 | 2.84 | 2.45 |
| Pli 3 | 2.62 | 2.73 |
| Pli 4 | 2.79 | 2.83 |
import numpy as np
# Moyenne simple sur les plis
mean_score = np.mean(fold_metrics)
# Pointage global de validation
overall_score_minimizing = np.mean(fold_metrics) + np.std(fold_metrics)
# Ou
overall_score_maximizing = np.mean(fold_metrics) - np.std(fold_metrics)
| Numéro de pli | MSE Modèle A | MSE Modèle B |
|---|---|---|
| Pli 1 | 2.95 | 2.97 |
| Pli 2 | 2.84 | 2.45 |
| Pli 3 | 2.62 | 2.73 |
| Pli 4 | 2.79 | 2.83 |
| Moyenne | 2.80 | 2.75 |
| Global | 2.919 | 2.935 |
Remporter une compétition Kaggle en Python