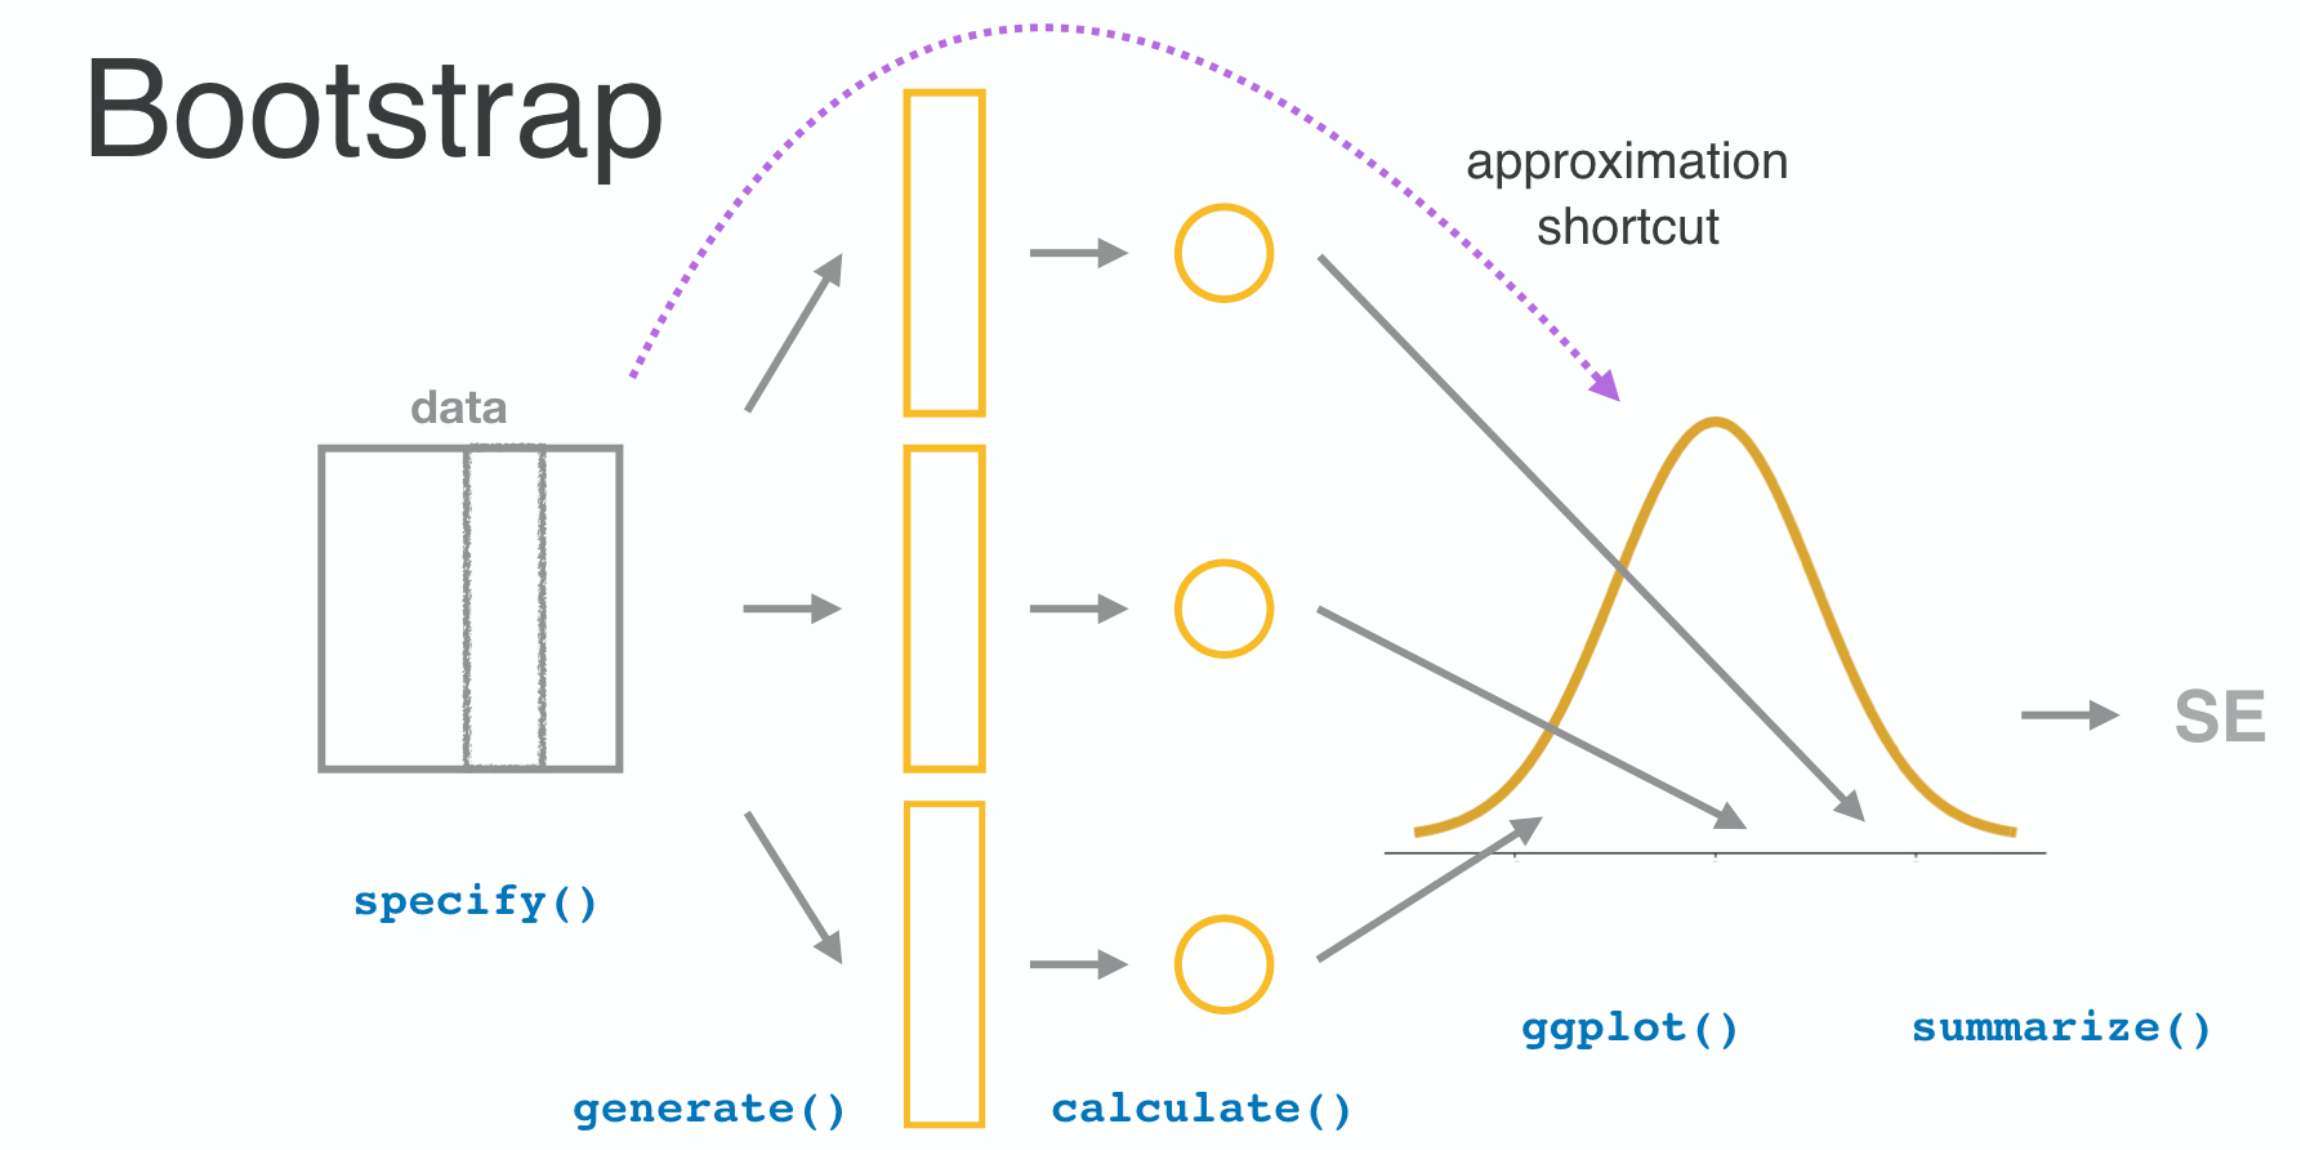
Raccourci d'approximation

Inférence pour des données catégorielles en R

Andrew Bray

Assistant Professor of Statistics at Reed College
Intervalles de confiance

SE
0.009998905
SE_small_n
0.03809731
SE_low_p
0.00547912

L'erreur type augmente lorsque

  • n est petit
  • p est près de 0,5
Inférence pour des données catégorielles en R

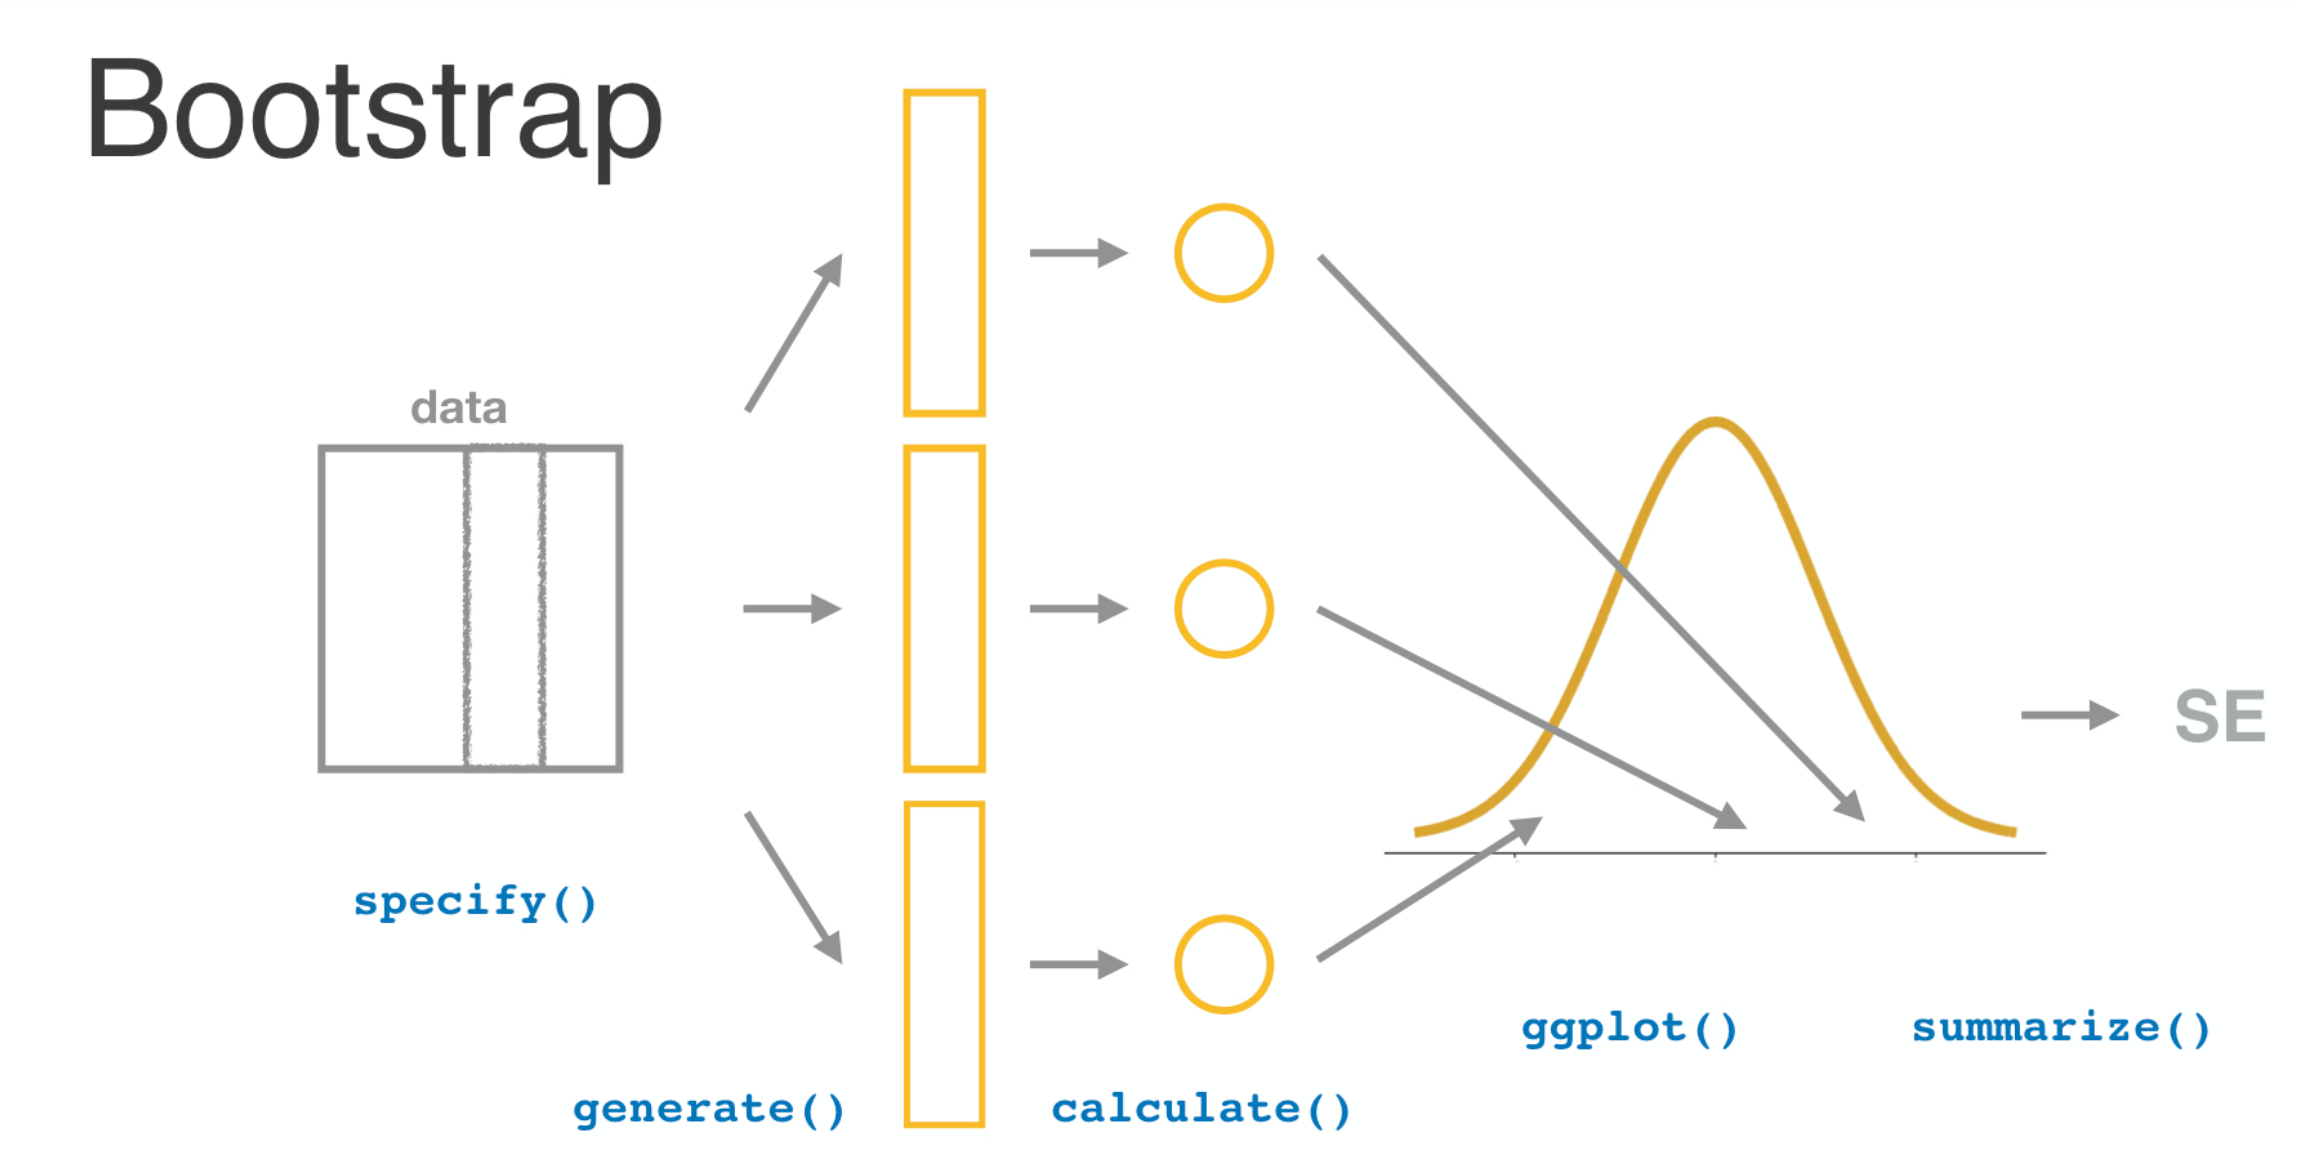
bootstrap_one.png

Inférence pour des données catégorielles en R

bootstrap_two.png

Inférence pour des données catégorielles en R

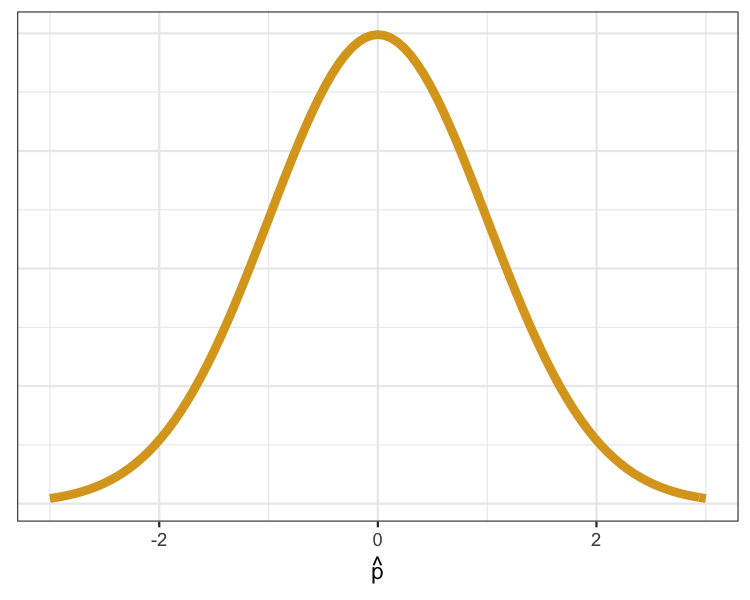
La loi normale

A.K.A. la « courbe en cloche ».

Si

  • les observations sont indépendantes
  • n est grand

Alors

  • $\hat{p}$ suit une loi normale

ch1v3-normal-curve.png

Inférence pour des données catégorielles en R

Écart type

$$\sqrt{\frac{ \hat{p} \times (1 - \hat{p})}{n}}$$

Inférence pour des données catégorielles en R

Vérifier les hypothèses du modèle

Comment vérifier que « les observations sont indépendantes » ?

  • Cela dépend de la méthode de collecte des données.

Que signifie « n est grand » ?

  • $n \times \hat{p} \gt 10$
  • $n \times(1 - \hat{p}) \gt 10$
Inférence pour des données catégorielles en R

Calcul de l'erreur type : approximation

p_hat <- gss2016 %>%
  summarize(mean(happy == "HAPPY")) %>%
  pull()
n <- nrow(gss2016)
c(n * p_hat, n * (1 - p_hat))
116  35
SE_approx <- sqrt(p_hat * (1 - p_hat) / n)
SE_approx
0.03418468
Inférence pour des données catégorielles en R

Calcul de l'erreur type : calcul direct

boot <- gss2016 %>%
  specify(response = happy, success = "HAPPY") %>%
  generate(reps = 500, type = "bootstrap") %>%
  calculate(stat = "prop")
SE_boot <- boot %>%
  summarize(sd(stat)) %>%
  pull()
SE_boot
0.03176741
Inférence pour des données catégorielles en R

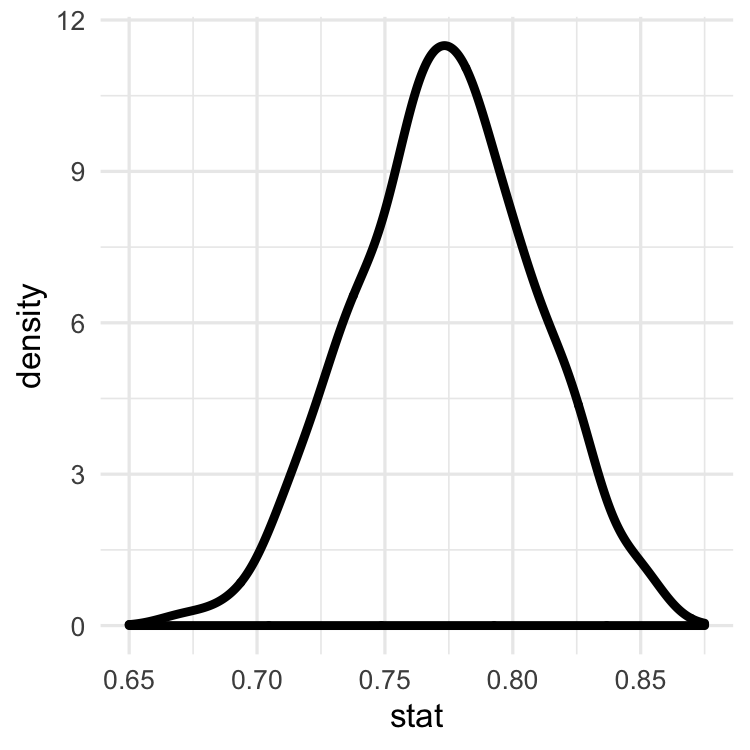
Distributions d'échantillonnage

ggplot(boot, aes(x = stat)) +
  geom_density()

ch1v3-density-curve-1.png

Inférence pour des données catégorielles en R

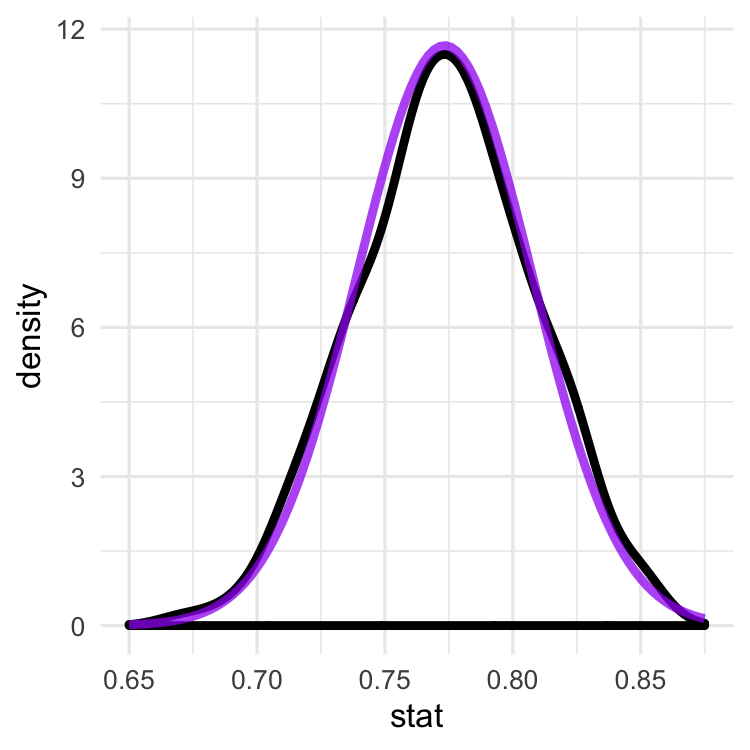
Distributions d'échantillonnage

ggplot(boot, aes(x = stat)) +
  geom_density() +
  stat_function(fun = dnorm, 
                color = "purple",
                args = 
                  list(mean = p_hat,
                       sd = SE_approx))

ch1v3-density-curve-1.png

Inférence pour des données catégorielles en R

Distributions d'échantillonnage

ggplot(boot, aes(x = stat)) +
  geom_density() +
  stat_function(fun = dnorm, 
                color = "purple",
                args = 
                  list(mean = p_hat,
                       sd = SE_approx))

ch1v3-density-curve-2.png

Inférence pour des données catégorielles en R

Passons à la pratique !

Inférence pour des données catégorielles en R

Preparing Video For Download...