Comment développer votre arbre

Machine Learning avec des modèles arborescents en R

Sandro Raabe

Data Scientist

Ensemble de données sur le diabète

head(diabetes)
# A tibble: 6 x 9
  outcome pregnancies glucose blood_pressure skin_thickness insulin   bmi    age
  <fct>         <int>   <int>          <int>          <int>   <int> <dbl>  <int>
1 yes               6     148             72             35       0  33.6     50
2 no                1      85             66             29       0  26.6     31
3 yes               8     183             64              0       0  23.3     32
Machine Learning avec des modèles arborescents en R

Utiliser tout l'ensemble de données

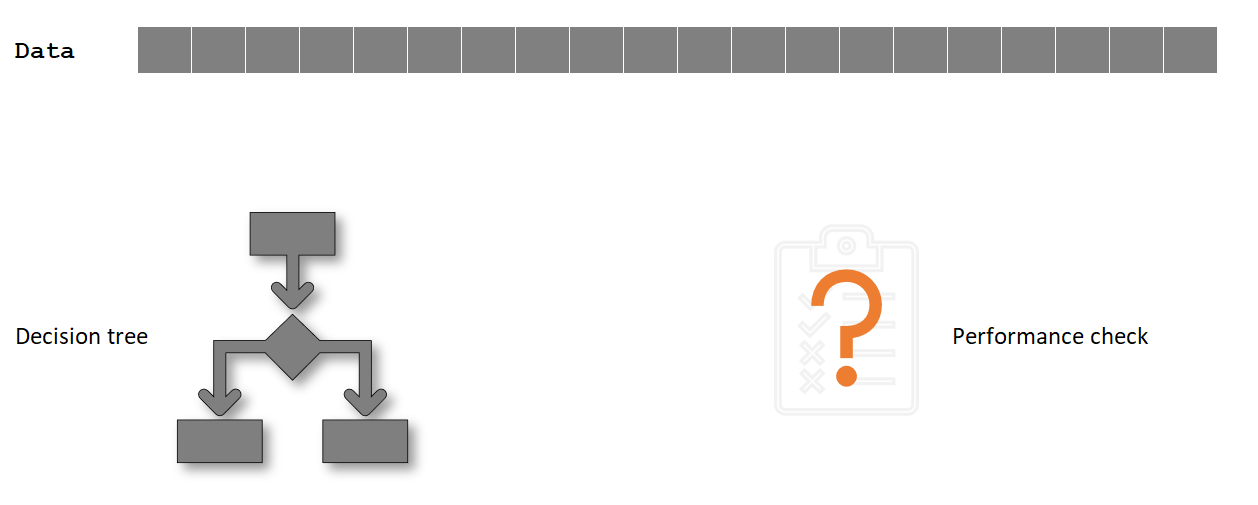
  • Tout a servi à l'entraînement : aucun jeu de test pour évaluer le modèle
model_flow_1

Machine Learning avec des modèles arborescents en R

Fractionnement des données

datasplit

model and evaluation

Machine Learning avec des modèles arborescents en R

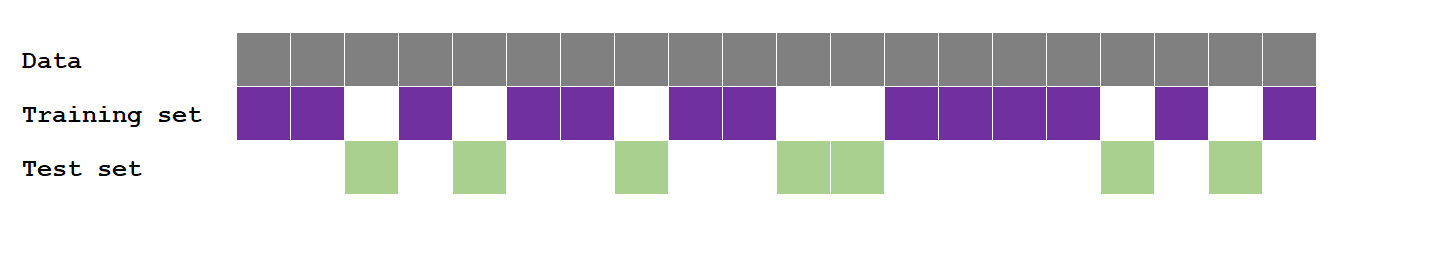
Méthodes de fractionnement

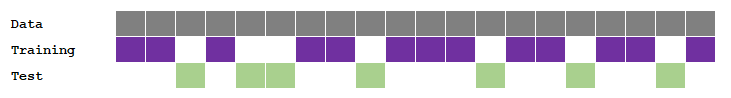
splitting methods

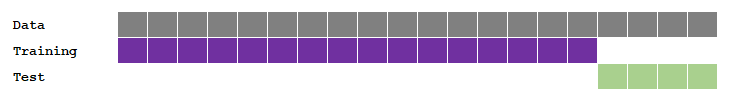
splitting_methods2

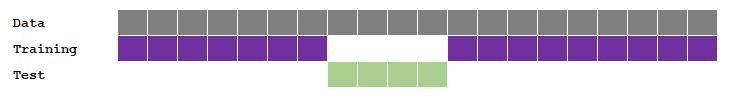
splitting_methods3

Machine Learning avec des modèles arborescents en R

La fonction initial_split()

  • Fractionne aléatoirement en un seul ensemble d'entraînement et un seul ensemble de test
# Split data proportionally (default: 0.75)
diabetes_split <- initial_split(diabetes, prop = 0.9)
diabetes_split
<Analysis/Assess/Total>
<692/76/768>
1 du paquet rsample
Machine Learning avec des modèles arborescents en R

Fonctions training() et testing()

  • Extraire les ensembles d'entraînement et de test à partir d'un fractionnement
diabetes_train <- training(diabetes_split)

diabetes_test <- testing(diabetes_split)
  • Vérification :
    nrow(diabetes_train)/nrow(diabetes)
    
[1] 0.9007812
1 de rsample
Machine Learning avec des modèles arborescents en R

Éviter les déséquilibres de classes

# Training count of 'yes' and 'no' outcomes
counts_train <- table(diabetes_train$outcome)
counts_train
 no yes 
490 86
# Training proportion of 'yes' outcome
prop_yes_train <- counts_train["yes"]/
                  sum(counts_train)
prop_yes_train
0.15
# Test data count of 'yes' and 'no' outcomes
counts_test <- table(diabetes_test$outcome)
counts_test
 no yes 
 28  48
# Test data proportion of 'yes' outcome
prop_yes_test <- counts_test["yes"]/
                  sum(counts_test)
prop_yes_test
0.63
Machine Learning avec des modèles arborescents en R

Solution : imposer des distributions similaires

initial_split(diabetes, 
              prop = 0.9, 
              strata = outcome)
  • Assure un fractionnement aléatoire avec une répartition similaire de la variable outcome
Machine Learning avec des modèles arborescents en R

Passons au fractionnement !

Machine Learning avec des modèles arborescents en R

Preparing Video For Download...