Compromis biais-variance

Machine Learning avec des modèles arborescents en R

Sandro Raabe

Data Scientist

Hyperparamètres
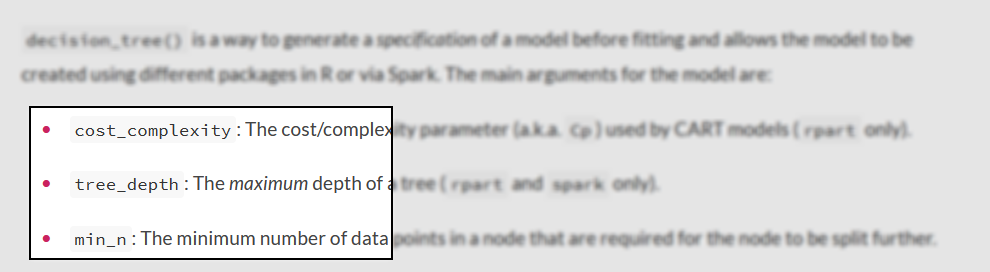
  • Choisis par la personne qui modélise
  • p. ex. tree_depth
  • Vérifiez la documentation !
?decision_tree

plusieurs hyperparamètres

Machine Learning avec des modèles arborescents en R

Modèle simple

simple_spec <- decision_tree(tree_depth = 2) %>% 
    set_mode("regression")

simple_spec %>% fit(final_grade ~ .,
                    data = training_data)

Modèle complexe

complex_spec <- decision_tree(tree_depth = 15) %>% 
    set_mode("regression")

complex_spec %>% fit(final_grade ~ .,
                     data = training_data)

arbre de profondeur 2

arbre de profondeur 30

Machine Learning avec des modèles arborescents en R

Modèle complexe – surapprentissage – forte variance

Prédictions sur l'ensemble d'entraînement : très bon !
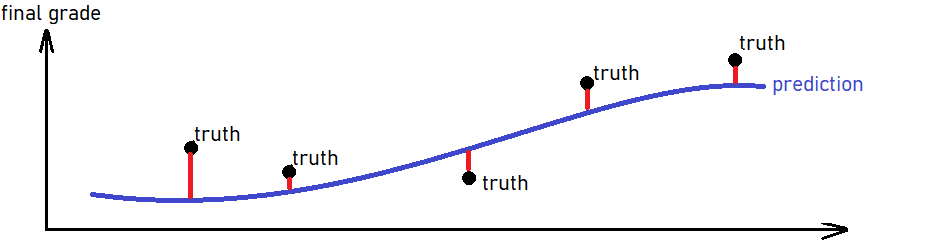
petites erreurs sur l'ensemble d'entraînement

mae(train_results, 
    estimate = .pred,
    truth = final_grade)
# A tibble: 1 x 3
  .metric  .estimate
1 mae          0.204

Prédictions sur l'ensemble de test : loin du compte !
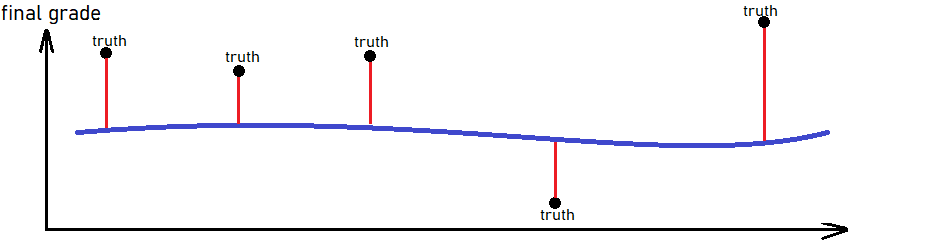
grandes erreurs sur l'ensemble de test

mae(test_results, 
    estimate = .pred,
    truth = final_grade)
# A tibble: 1 x 3
  .metric  .estimate
1 mae          0.947
Machine Learning avec des modèles arborescents en R

Modèle simple – sous-apprentissage – fort biais

Grosses erreurs sur l'entraînement et le test :

bind_rows(training = mae(train_results, estimate = .pred, truth = final_grade),
          test     = mae(test_results,  estimate = .pred, truth = final_grade),
          .id = "dataset")
# A tibble: 2 x 4
  dataset    .metric  .estimate
  <chr>      <chr>        <dbl>
1 training   mae          0.754
2 test       mae          0.844
Machine Learning avec des modèles arborescents en R

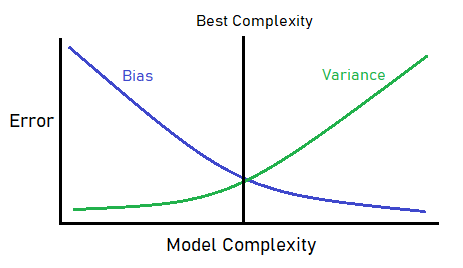
Le compromis biais-variance

compromis biais-variance


  • Modèles simples -> biais élevé
  • Modèles complexes -> variance élevée
  • Compromis entre biais et variance
  • Viser la zone optimale
Machine Learning avec des modèles arborescents en R

Détecter le surapprentissage

Hors échantillon/VC :

collect_metrics(cv_fits)


# A tibble: 1 x 3
  .metric    mean     n 
1 mae       2.432     5
  • Erreur de VC élevée
  • Surapprentissage / forte variance
  • Réduire la complexité !

Dans l'échantillon :

mae(training_pred, 
    estimate = .pred, 
    truth = final_grade)
# A tibble: 1 x 2
  .metric  .estimate
1 mae          0.228
  • Faible erreur d'entraînement
Machine Learning avec des modèles arborescents en R

Détecter le sous-apprentissage

Dans l'échantillon :

mae(training_pred, estimate = .pred, truth = final_grade)
# A tibble: 1 x 2
  .metric .estimate
  <chr>       <dbl>
1 mae         2.432
  • Grande erreur dans l'échantillon/à l'entraînement
  • Sous-apprentissage / fort biais
  • Augmenter la complexité !
Machine Learning avec des modèles arborescents en R

Faisons le compromis !

Machine Learning avec des modèles arborescents en R

Preparing Video For Download...