Tests de normalité

Fondements de l'inférence en Python

Paul Savala

Assistant Professor of Mathematics

Taille des hommes aux É.-U.
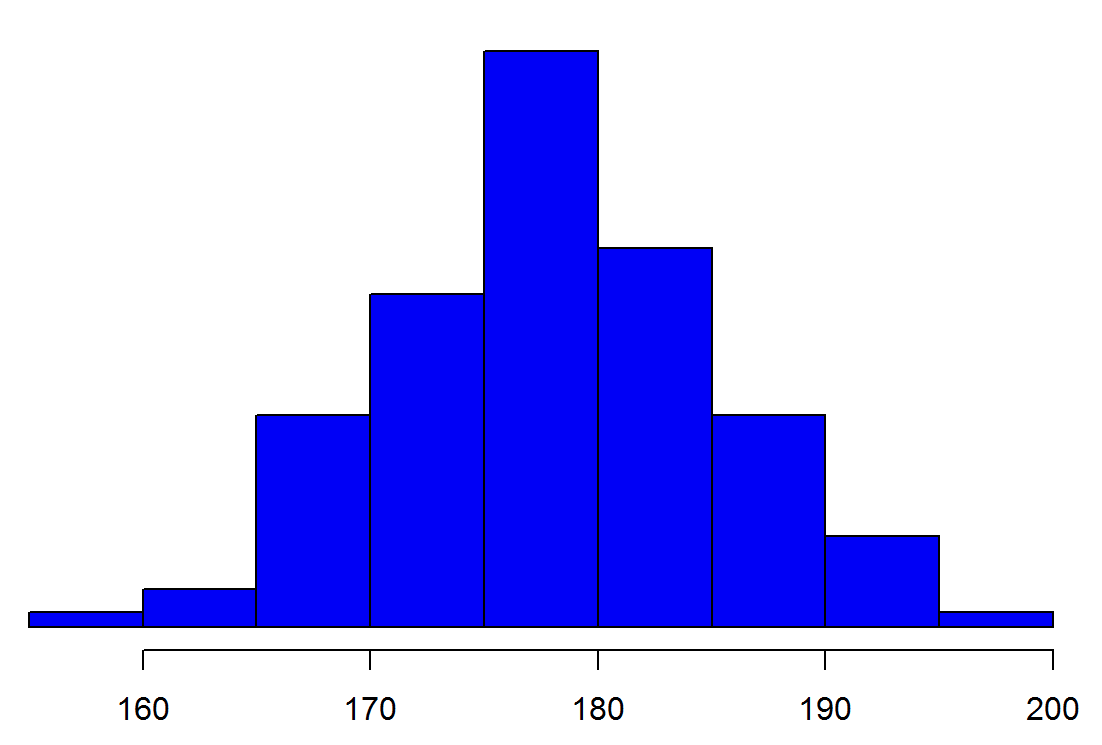
Un histogramme approximativement normal, avec une taille moyenne de 180 centimètres, une taille minimale de 160 centimètres et une taille maximale de 200 centimètres.

Fondements de l'inférence en Python

Résidus du modèle

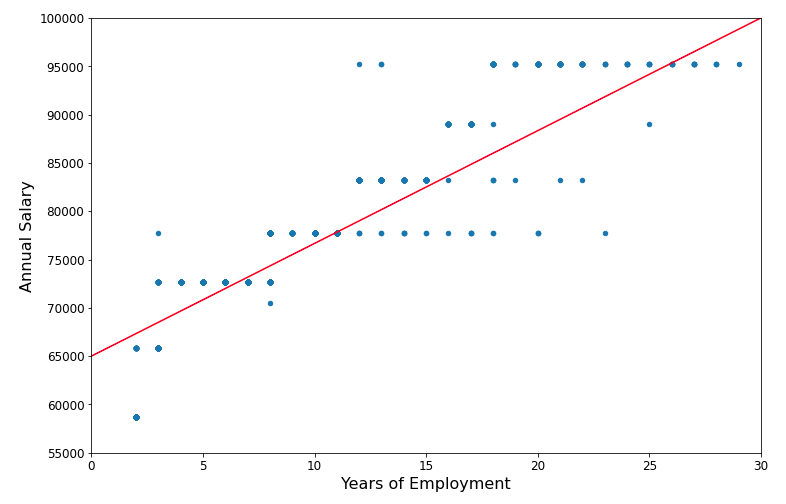
Un nuage de points avec les années d'emploi sur l'axe des x, le salaire annuel sur l'axe des y, et une tendance linéaire généralement positive. Une ligne rouge de meilleure adaptation est tracée.

Attendez-vous à une répartition égale au-dessus et au-dessous de la prédiction

Fondements de l'inférence en Python

Résidus du modèle

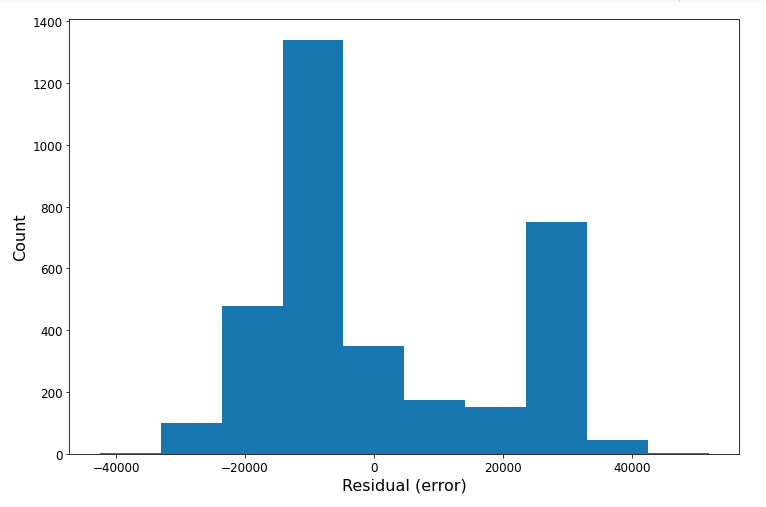
Un histogramme avec « résidu (erreur) » sur l'axe des x, « fréquence » sur l'axe des y, et une distribution bimodale avec un mode autour de moins dix mille et un autre autour de plus trente mille.

Fondements de l'inférence en Python

Applications des lois normales

  • Tests paramétriques : tests d'hypothèse supposant la normalité
  • Test t pour comparer des moyennes :
    • Suppose que les moyennes d'échantillon sont normalement distribuées
    • Sinon, les conclusions sont non valides
Fondements de l'inférence en Python

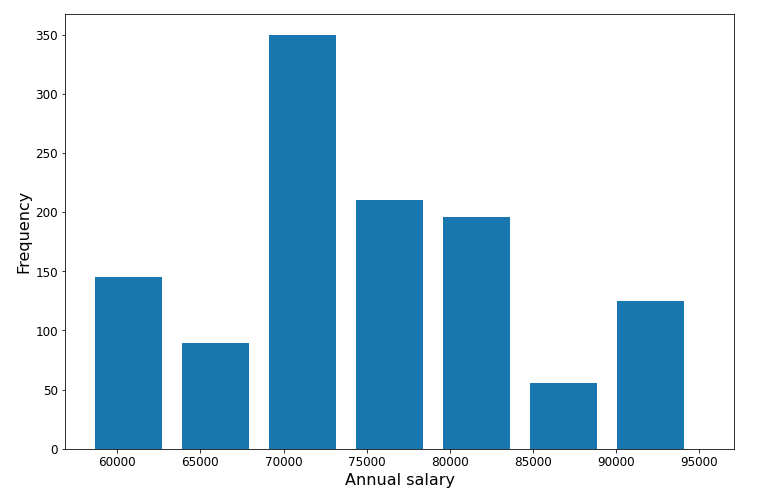
Un histogramme avec des salaires entre soixante mille et quatre-vingt-quinze mille sur l'axe des x, et la fréquence sur l'axe des y. L'histogramme est assez proche d'une normale.

Fondements de l'inférence en Python

Test de normalité d'Anderson-Darling

  • Vérifie l'hypothèse de normalité

$H_0$ : les données suivent une loi normale

$H_a$ : les données ne suivent pas une loi normale

Fondements de l'inférence en Python

Test d'Anderson-Darling dans SciPy

result = stats.anderson(police_df['Annual Salary'])

result.statistic
27.41
result.critical_values
[0.574, 0.654, 0.784, 0.915, 1.088]
result.significance_level[result.statistic > result.critical_values]
[15.  10.   5.   2.5  1. ]
Fondements de l'inférence en Python

Ajuster une loi normale

mu, std = stats.norm.fit(police_df['Annual Salary'])

estimated_pct_under_70k = stats.norm.cdf(70000, loc=mu, scale=std)
print(estimated_pct_under_70k)
0.27
actual_under_70k = police_df[police_df['Annual Salary'] < 70000]

print(len(actual_under_70k) / len(police_df))
0.20
Fondements de l'inférence en Python

Passons à la pratique !

Fondements de l'inférence en Python

Preparing Video For Download...