ChIP-seq avec Bioconductor en R
Peter Humburg
Statistician, Macquarie University


Charger les données :
reads <- readGAlignments(bam)
reads_gr <- granges(reads[[1]])
Obtenir la longueur moyenne des fragments :
frag_length <- fragmentlength(qc_report)["GSM1598218"]
Étendre les lectures et calculer la couverture :
reads_ext <- resize(reads_gr, width=frag_length)
cover_ext <- coverage(reads_ext)

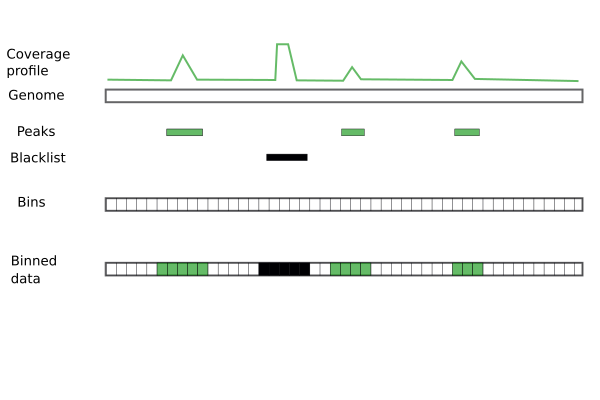
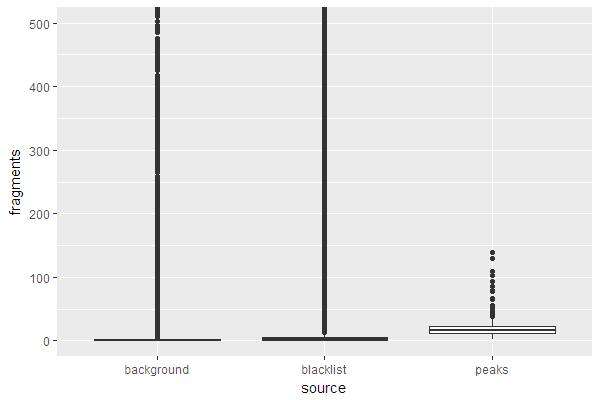
Créer des blocs de 200 pb le long du génome.
bins <- tileGenome(seqinfo(reads), tilewidth=200,
cut.last.tile.in.chrom=TRUE)
Trouver tous les blocs qui chevauchent des pics.
peak_bins_overlap <- findOverlaps(bins, peaks)
peak_bins <- bins[from(peak_bins_overlap), ]
Compter le nombre de lectures chevauchant chaque bloc de pic.
peak_bins$score <- countOverlaps(peak_bins, reads)
count_bins <- function(reads, target, bins){
# Find all bins overlapping peaks
overlap <- from(findOverlaps(bins, target))
target_bins <- bins[overlap, ]
# Count the number of reads overlapping each peak bin
target_bins$score <- countOverlaps(target_bins, reads)
target_bins
}
peak_bins <- count_bins(reads_ext, peaks, bins)
bl_bins <- count_bins(reads_ext, blacklist.hg19, bins)
Retirer tous les blocs déjà pris en compte.
bkg_bins <- subset(bins, !bins %in% peak_bins & !bins %in% bl_bins)
Compter les lectures chevauchant chaque bloc restant.
bkg_bins$score <- countOverlaps(bkg_bins, reads_ext)


ChIP-seq avec Bioconductor en R