Encodage des données catégorielles avec l'apprentissage supervisé
Ingénierie des caractéristiques en R

Jorge Zazueta
Research Professor and Head of the Modeling Group at the School of Economics, UASLP
Introduction à l'encodage supervisé
L'encodage supervisé, lui, utilise les valeurs cibles pour dériver des caractéristiques numériques à partir de prédicteurs nominaux.
Introduction à l'encodage supervisé
L'encodage supervisé utilise les valeurs cibles pour dériver des caractéristiques numériques à partir de prédicteurs nominaux.
Fonctions d'encodage supervisé offertes dans le embed package
| Function | Definition |
|---|---|
| step_lencode_glm() | Utilise des encodages par vraisemblance pour convertir un prédicteur nominal en un seul ensemble de scores issus d'un modèle linéaire généralisé. |
| step_lencode_bayes() | Applique des encodages bayésiens par vraisemblance pour convertir un prédicteur nominal en un seul ensemble de scores issus d'un modèle linéaire généralisé estimé par analyse bayésienne. |
| step_lencode_mixed() | Convertit des prédicteurs nominaux en un seul ensemble de scores issus d'un modèle linéaire généralisé mixte. |
Prédire la réussite des demandes de subvention
Nous voulons prédire la réussite d'une demande de subvention uniquement selon le code du commanditaire.
lr_model <- logistic_reg() # declare model

lr_recipe_glm <- # Set recipe glm
  recipe(class ~ sponsor_code,
         data = grants_train) %>%
  step_lencode_glm(sponsor_code,
                   # Declare outcome variable
                   outcome = vars(class))

lr_workflow_glm <- # Create Workflow
  workflow() %>%
  add_model(lr_model) %>%
  add_recipe(lr_recipe_glm)
Résumé du flux de travail
lr_workflow_glm
-- Workflow ------------------------------------
Preprocessor: Recipe
Model: logistic_reg()

-- Preprocessor --------------------------------
1 Recipe Step

- step_lencode_glm()

-- Model --------------------------------------
Logistic Regression Model Specification (classification)

Computational engine: glm
Ajuster, augmenter et évaluer
Ajustons et évaluons notre modèle
lr_fit_glm <- # Fit
  lr_workflow_glm %>%
  fit(grants_train)

lr_aug_glm <- # Augment
  lr_fit_glm %>%
  augment(grants_test)

glm_model <- lr_aug_glm %>% # Assess
  class_evaluate(truth = class,
                 estimate = .pred_class,
                 .pred_successful)
Les résultats de performance sont stockés dans glm_model
glm_model
# A tibble: 2 × 3
  .metric  .estimator .estimate
  <chr>    <chr>          <dbl>
1 accuracy binary         0.728
2 roc_auc  binary         0.684
Assembler les modèles
Nous construisons bayes_model et mixed_model pour comparer les performances des étapes correspondantes.
# Define model names
model <- c("glm", "glm",
           "bayes","bayes",
           "mixed", "mixed")
# Bind models in a tibble
models <-
bind_rows(glm_model,
          bayes_model,
          mixed_model)%>%
  add_column(model = model)%>%
  select(-.estimator) %>%
  spread(model,.estimate)
Un tableau de performance pratique
models
# A tibble: 2 × 4
  .metric  bayes   glm mixed
  <chr>    <dbl> <dbl> <dbl>
1 accuracy 0.718 0.728 0.720
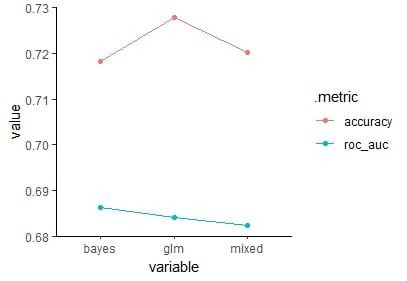
2 roc_auc  0.686 0.684 0.682
Visualiser les résultats
Visualisez les résultats dans un diagramme en coordonnées parallèles du package Gally.
# Libraries
library(GGally)

# Parallel coordinates chart
ggparcoord(models,
           columns = 2:4,
           groupColumn = 1,
           scale="globalminmax",
           showPoints = TRUE)
Diagramme en coordonnées parallèles d'accuracy et de roc_auc comparant tous les modèles.
Passons à la pratique !
Ingénierie des caractéristiques en R

